全体の中で、今回はここ
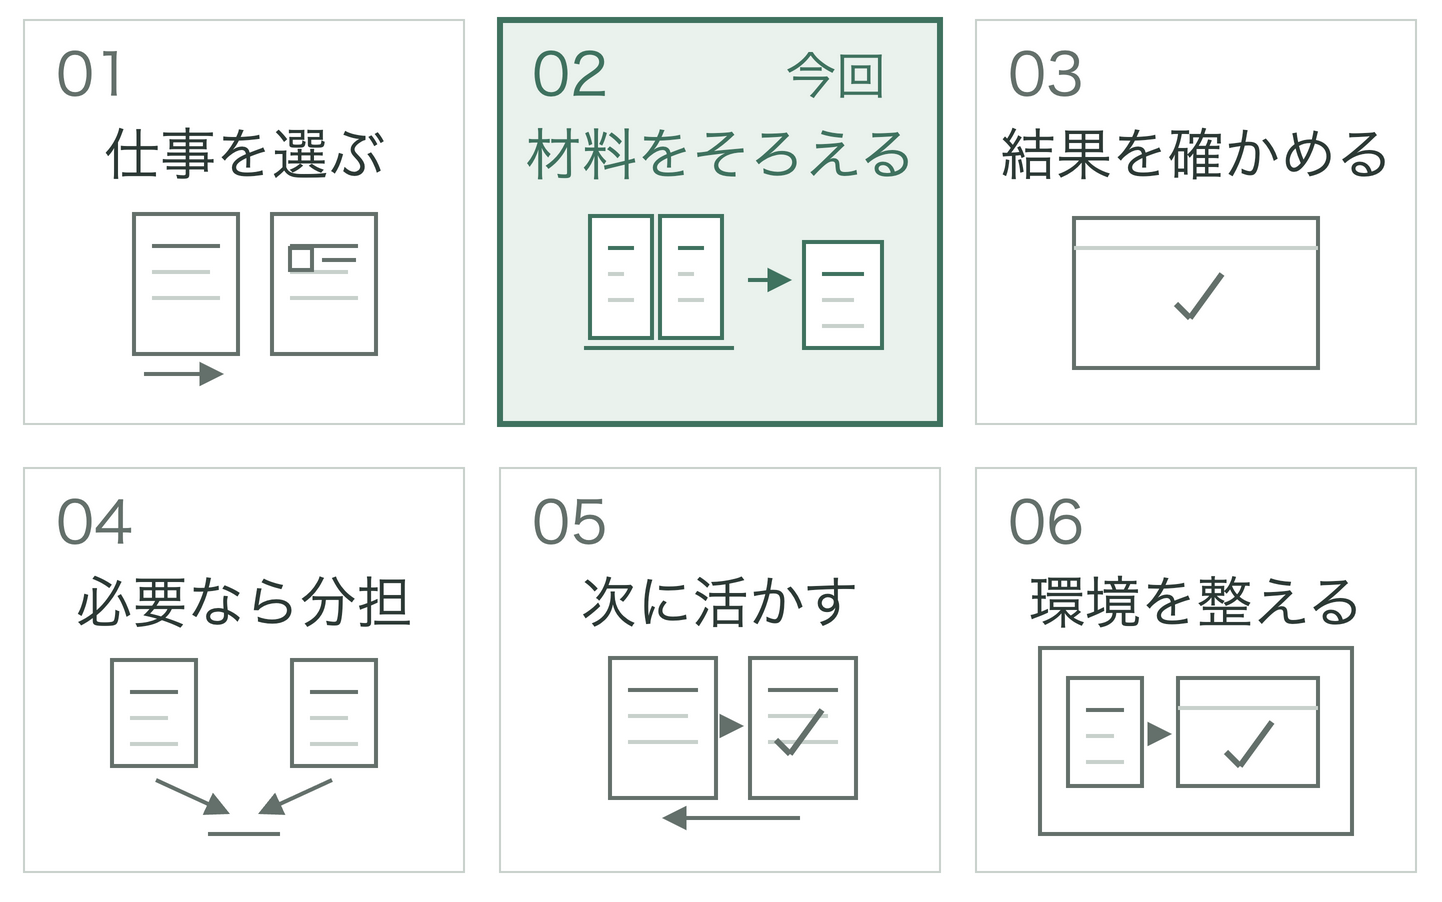
前回は説明を頼むのか修正を頼むのかを分けました。今回はその仕事に必要な情報をそろえます。次回は集めた情報だけでなく実際の結果も確かめます。
ゴールは架空のログインアプリについて「何を読んだか・何が根拠か・何が未確認か」を分けた調査メモを作れることです。
視点
今回の結論
情報設計の目標は読む量を減らすこと自体ではなく、必要な根拠を落とさずに集めることです。
Step 1:ログインを調べたいのに全資料を渡す
前回の架空アプリで、コードを変えずにログインの原因を調べます。全ソース、古い設計書、長い実行ログを一度に渡すと、どの情報が今の問題に関係するかを追いにくくなります。
書庫の料理本でカレーの作り方を調べる場面を考えてください。全冊を机に積む必要はありません。ただ、レシピが別ページの下ごしらえを参照しているなら、そのページも開かないと手順がつながりません。
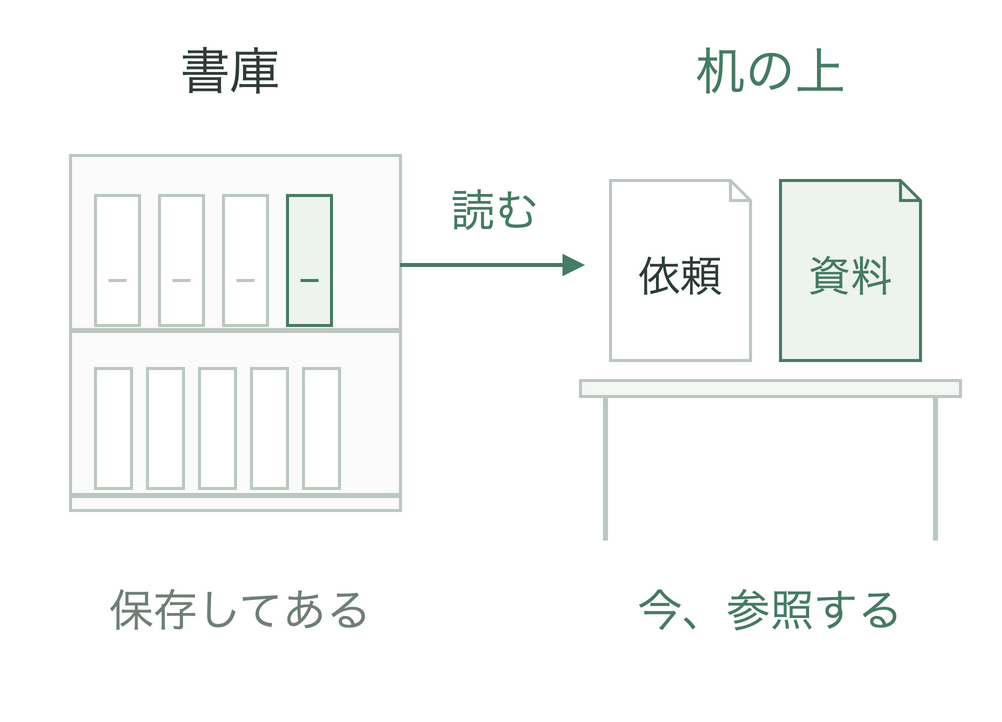
書庫が保存されたファイル、机の上が今読んでいる内容に当たります。AIがその時点で参照できる依頼文・読んだコード・操作結果などを、ここではコンテキストと呼びます。必要な情報を必要なときに渡す設計がContext Engineeringです。
「少しだけ読めばよい」という意味ではありません。料理本が書庫にあるだけでは使えない一方、レシピの最初の1ページだけで足りるとも限らないからです。
ログインの調査も同じです。「認証」という名前だけで読むファイルを決めず、ボタンの入口から、その処理が使う別の処理や設定までたどります。これらの依存先が抜けると、説明も途中で途切れます。
Step 2:手順・技法・判断基準を分ける
同じ料理本でも、レシピの全体手順、包丁で切る技法、火の通りを確かめる判断基準は役割が違います。全体手順がPlaybookです。工程ごとのやり方が作業用Skillで、必要な場面で使う判断基準がPrincipleに当たります。
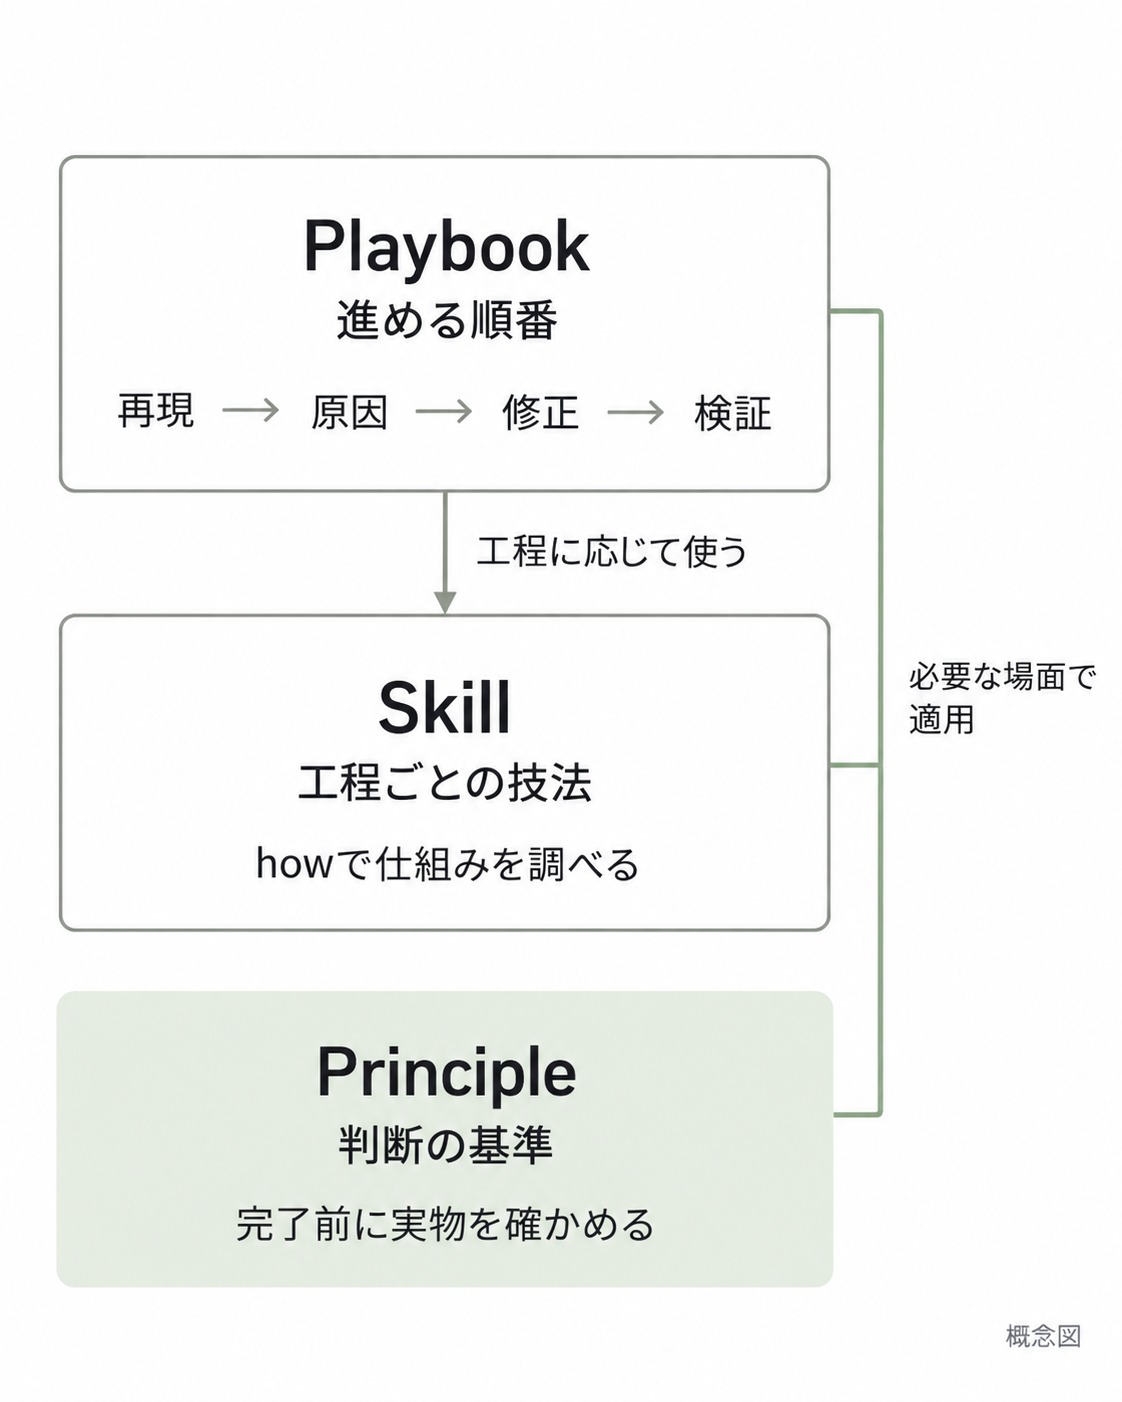
レシピを読み終えたことだけで、料理に火が通ったとは言えません。判断基準は最後に付け足す飾りではなく、該当する場面の作業や確認に使います。
pstackなら、Bug fixという手順の原因調査でhowを使い、完了前にはProve It Worksに従って実物を確かめます。読み取り専用の調査を頼んだ場合は、この説明を見て修正まで始めるわけではありません。
ただし、これは役割の区別です。Skillは広くは「AIに渡す再利用可能な指示のまとまり」を指します。入口のpoteto-modeも、判断基準のPrincipleもSkillです。Principleは principle-*/SKILL.md に保存されていて、別の実行エンジンが3層あるわけではありません。
同じログイン不具合で、役割を比べる
| 名前 | 答える問い | この例では |
|---|---|---|
| Playbook | どの順で進める? | 再現 → 原因調査 → 修正 → 再検証 |
| 作業用Skill | その工程をどう進める? | howで処理の流れを調べる |
| Principle | 何を判断基準にする? | 「実物で確かめる」に従い同じログインを試す |
| エージェント | 誰が作業する? | 指示を読み、調査や検証を進めるAI |
| コンテキスト | 今、何を参照できる? | 依頼文・読んだコード・操作結果 |
Step 3:索引から実物へ進む
pstack/skills/poteto-mode/SKILL.md の Principles節・L38–40 は、適用する原則について次のように指示します。
Read the leaf skill in full for any principle you apply.
入口には適用条件と短い説明を置き、必要になった詳細ファイルは全文を読みます。これが、必要な段階で詳細を開く設計です。「段階的に読む」は適用する指示の都合のよい箇所だけ読むという意味ではありません。
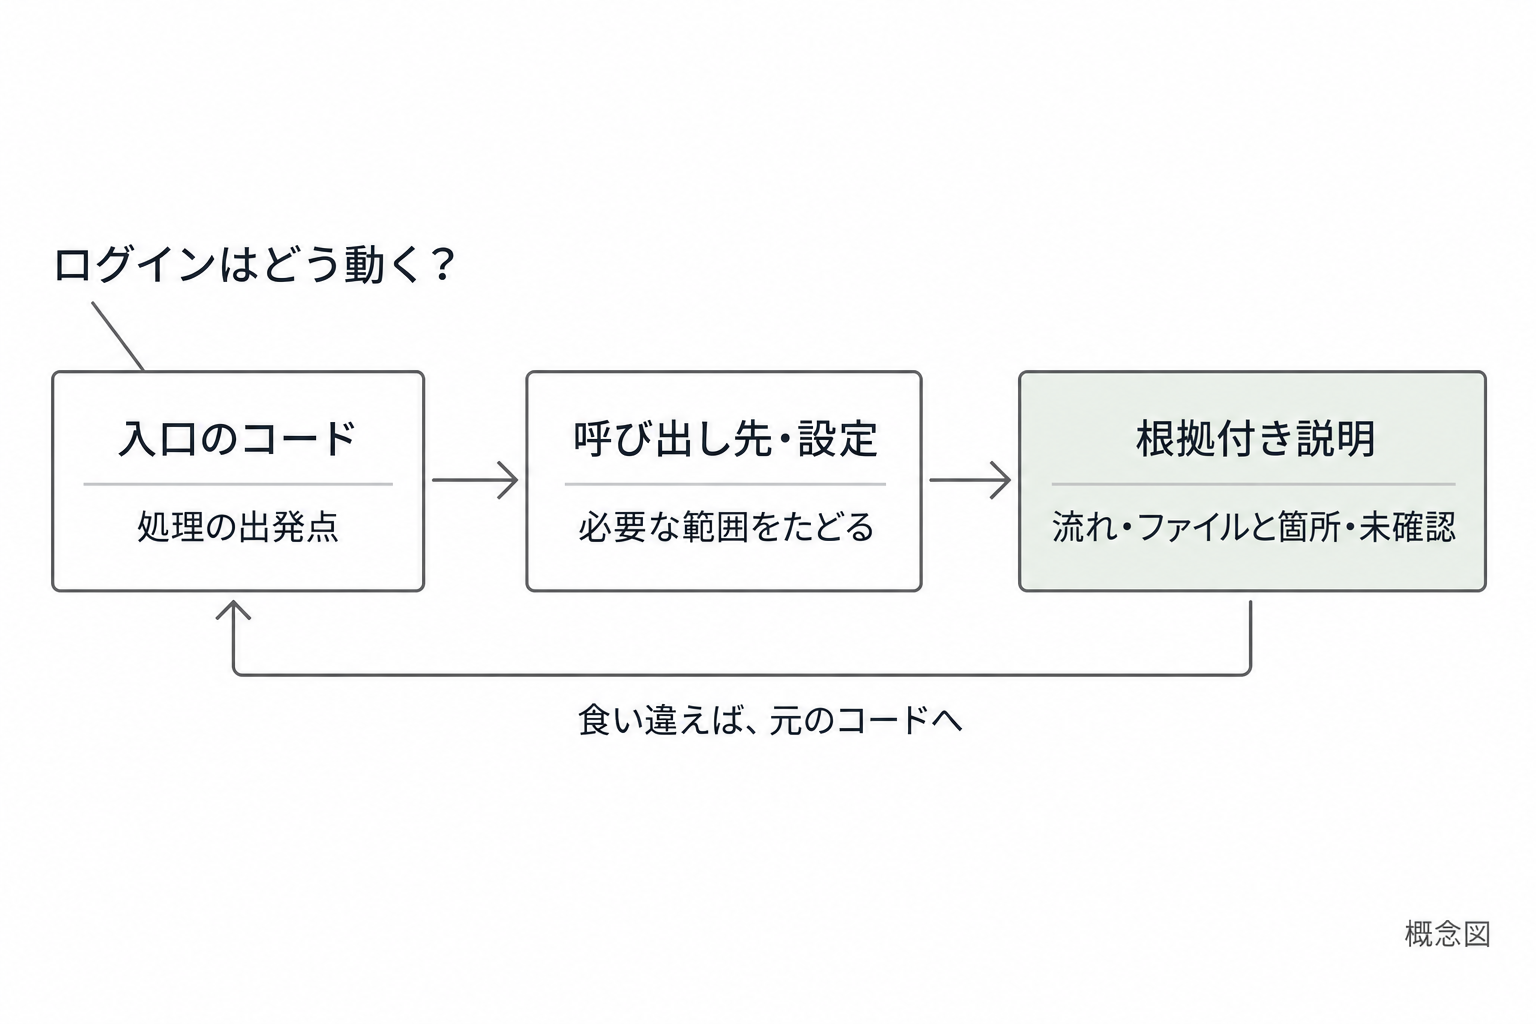
図の根拠は、調査役が返す情報を定める explorer-prompt・L19–35 と、矛盾を実コードで確かめる explainer-prompt・L19–23 です。
さらに pstack/skills/how/SKILL.md の Workflow・L9–32 は、小さい問いと複雑な問いで調査方法を分けています。小さい問いは説明をまとめるAI、explainer一人。複雑な問いは調査担当のAI、explorerが2〜4の観点を分担し、別のexplainerが結果を統合します。これらは担当の呼び名で、別のAI製品名ではありません。
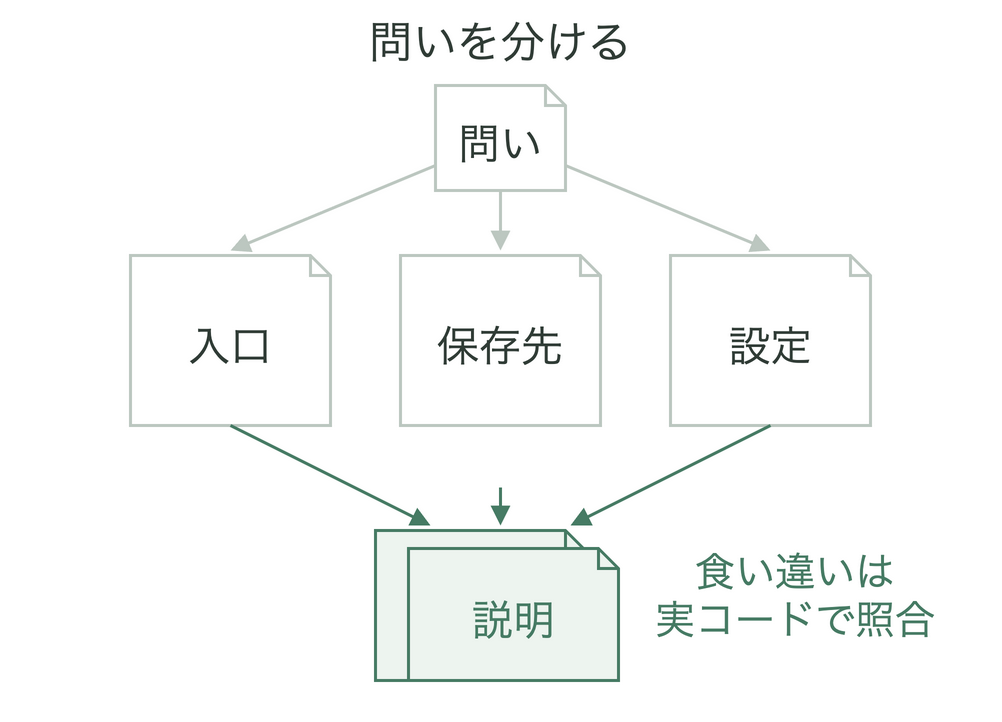
ここが核心です。調査役を増やすだけでなく、何を返して、誰が食い違いを解くかまで決めています。根拠付きの要約なら、読み手が必要なときに元ファイルへ戻れます。
Step 4:量よりも根拠のつながりを見る
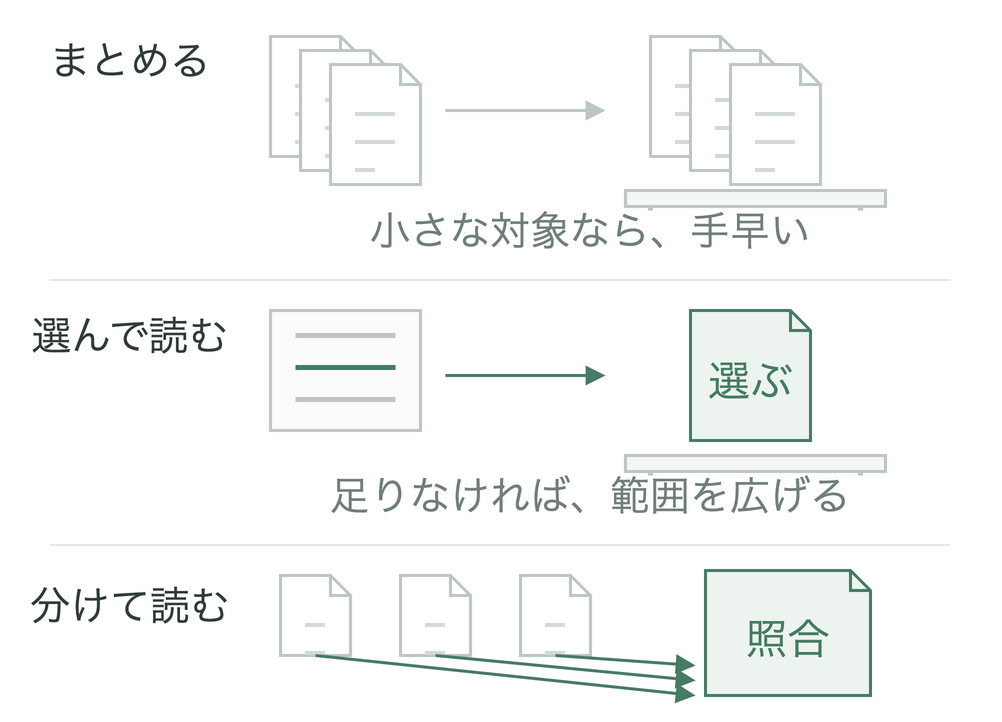
3つの方法の利点と注意点
| 渡し方 | 利点 | 注意点 |
|---|---|---|
| 必要資料をまとめて渡す | 小さな対象なら手早い | 対象が広がると無関係な情報も増える |
| 索引から段階的に読む | 調査範囲を調整しやすい | 最初の検索で重要な依存先を逃すことがある |
| 調査を分担して統合する | 独立した観点を扱える | 要約で条件が落ちたり、統合に時間がかかったりする |
注意
ただし、短い要約が正しいとは限らない
調査役が見つけなかった依存先は、要約にも現れません。結果には根拠のパスと未確認事項を残し、説明が矛盾する場合は元の処理をたどります。読み込み量が少ないだけでは成功と判定しません。
先の回につながる補足:次のAIの手本はコードにも残る
会話で注意しても、別の作業にその注意が届くとは限りません。よい実装例と、同じ失敗を見つけるテストをプロジェクトに残せば、次のAIが使える材料になります。
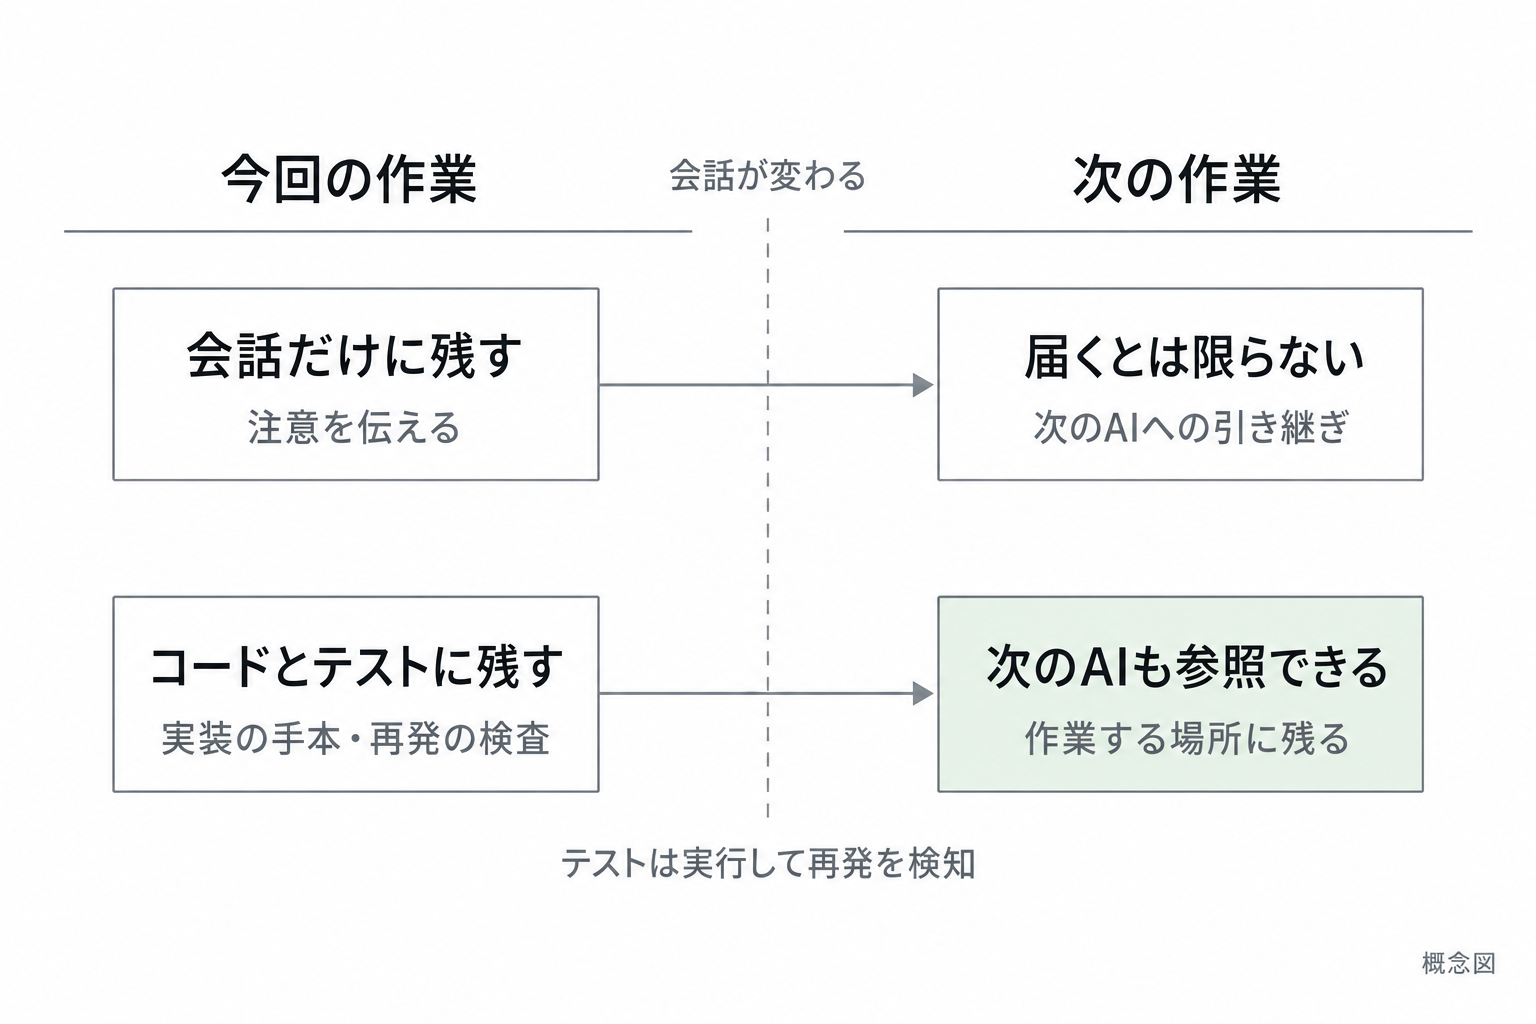
Laurenさんの講演動画の19分50秒付近にも、既存の回避策が次の実装へ広がる図が登場します。pstackの correct/SKILL.md・L9–11 は、次のAIが近くの実装例を読む前提で、コードの構造を整えるよう求めています。
Step 5:Codexで調査範囲を試す
機密情報のない練習用リポジトリを使います。同じ状態を二つの新規チャットから読み、一方では「このアプリのログインの流れを説明して」と頼みます。もう一方では次を使います。ログインがなければ検索などの既存機能に置き換えてください。
このアプリのログイン処理を、読み取り専用で調べてください。
まずファイル名と参照関係から入口を選び、必要なファイルを読んでください。
入口だけで説明できない場合は、呼び出し先や設定まで調査を広げてください。
機密情報を含むファイルは開かず、コードも変更しないでください。

回答は「処理の流れ・根拠のファイルと該当箇所・未確認事項」に分けます。
読んだファイルを列挙し、実行していない動作は実行済みと書かないでください。
調査結果を出したら終了してください。
出力はたとえば次の形で読み比べられます。これは形式の例であり、実行結果ではありません。
流れ: 入力 → 送信 → 応答の処理
根拠: 実際に読んだファイルと関数名
未確認: ブラウザでのログイン成功
| 見る項目 | 確かめ方 |
|---|---|
| 正確性 | 説明と参照先のコードが一致するか |
| 網羅性 | 入力から結果まで重要な依存先がつながるか |
| 調査の負荷 | 読んだファイル数と所要時間を記録する |
| 検証可能性 | 不明点と根拠へ戻る手がかりがあるか |
セルフチェック
1. 調査役の要約同士が食い違いました。次に何をしますか?
今回持ち帰るもの
共通の架空例では前回の依頼に次の調査メモを添えます。以下は記入すべき内容で、調査済みの結果ではありません。
- 読んだ範囲:ログインボタンの入口から、関連する処理・設定をどこまで読んだか。
- 根拠:説明に対応する、実際に読んだファイルと該当箇所。
- 未確認:実際のログイン成功。コードを読んだだけでは確認済みにしない。
説明に必要な情報が足りなければ、追加で読みます。次回は「読めた」と「動いた」を分けて確かめます。
今日のまとめ
役割:手順・技法・判断基準を分ける。
段階:索引から必要な詳細へ進む。
根拠:要約しても元のコードへ戻れるようにする。
次回の問いは「説明がもっともらしくても、実際に動いたとどう確かめるか」です。