全体の中で、今回はここ
前回は架空のログインアプリで確かめた結果と未確認の範囲を分けました。今回はその未確認部分を1体で調べるか、複数のAIへ分けるかを判断します。
目標は任せる仕事と共通の検証条件を書けることです。次回は、検証で繰り返し見つかった失敗を再発防止案へ変えます。
視点
今回の結論
複数のAIを使う設計は、単に人数を増やすことではなく、仕事の渡し方と結果の判断方法を決めることです。
Step 1:同じ依頼を3回渡したら
ログイン画面の変更を3つのAIに確認してもらったとします。全員が「問題ありません」と答えましたが、3つとも正しい入力でログインできることしか見ていません。間違った入力でどうなるかは未確認のままです。
回答の数が増えても、調べた範囲や根拠が増えたとは限りません。複数の担当AIで仕事を進める方法をMulti-Agent(マルチエージェント)と呼びます。最初に決めるのは人数よりも、何を別々に調べさせるかです。
エージェントは仕事を進める担当、モデルはその中で回答や判断を生むAIの種類です。同じモデルで担当を増やすことと、異なるモデルを使うことは区別します。
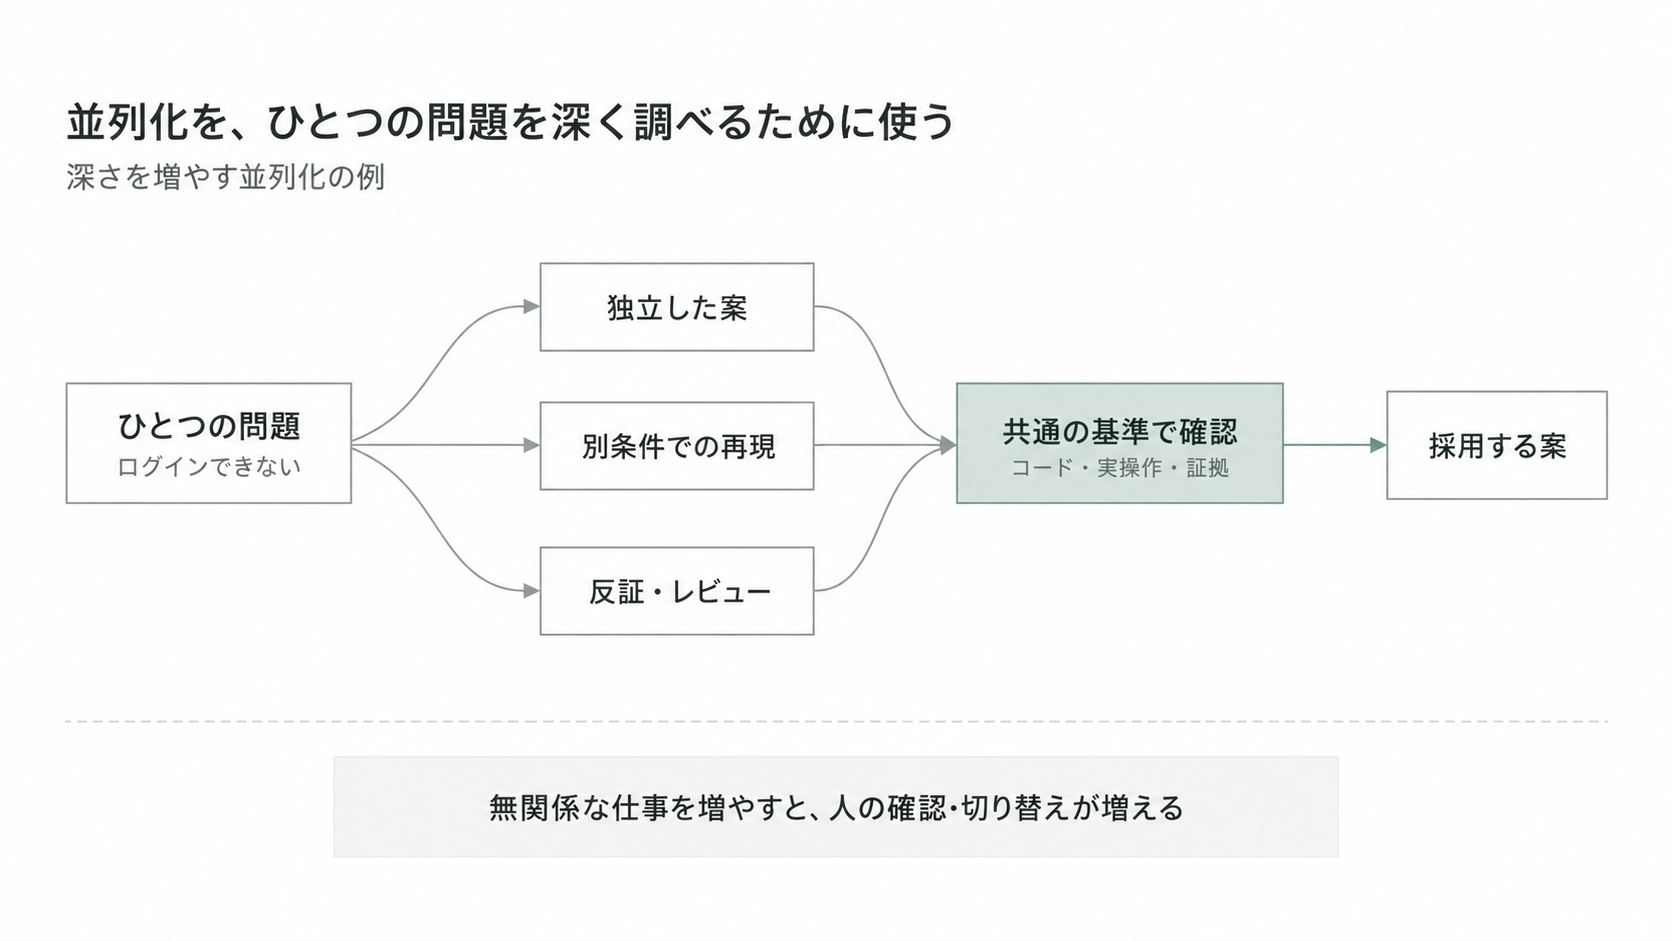
補足:一つの問題を深く解く使い方
Laurenさんのdepth-firstについての投稿は、一つの問題を深く解く使い方を勧めています。関係のない仕事を大量に並べると、人が何度も頭を切り替えて確認する負担も増えます。
Step 2:分担・競争・批評を使い分ける
社内イベントを準備するとします。会場候補と費用を調べたいなら、会場係と予算係に別の調査を頼めます。一方、企画そのものを選びたいなら、各担当に会場と予算がそろった完成案を作ってもらい、比べます。
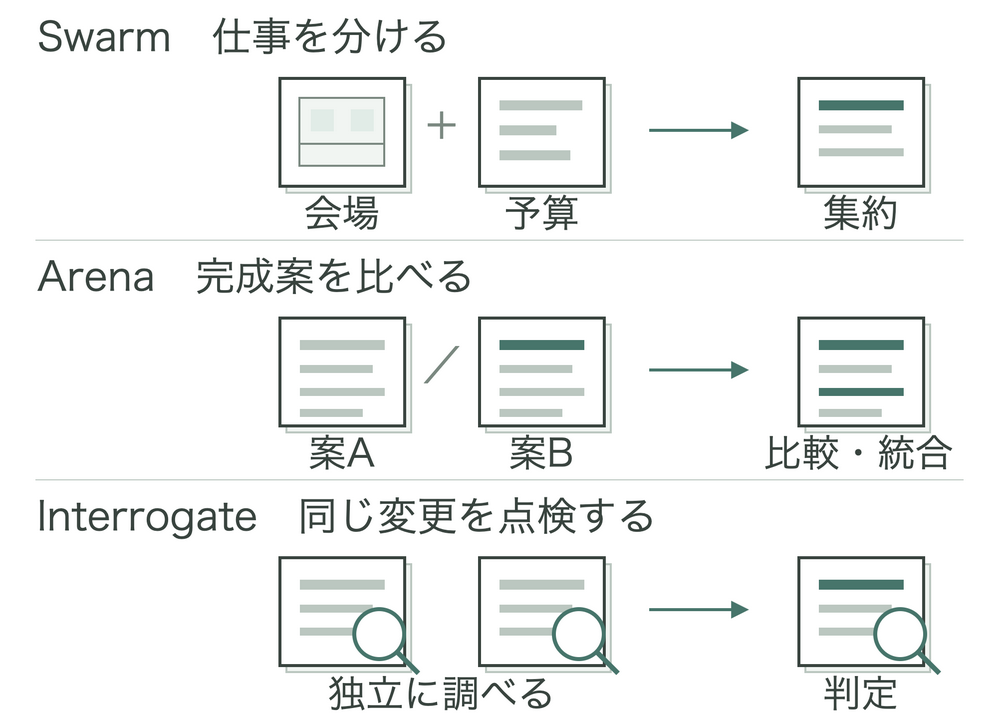
すでに企画案があるなら、別々の人が同じ資料を読み、収容人数や費用の見落としを点検します。会場係のメモと予算係のメモを比べても、完成案の優劣を比べたことにはなりません。渡す仕事が違えば、集める成果物も違います。
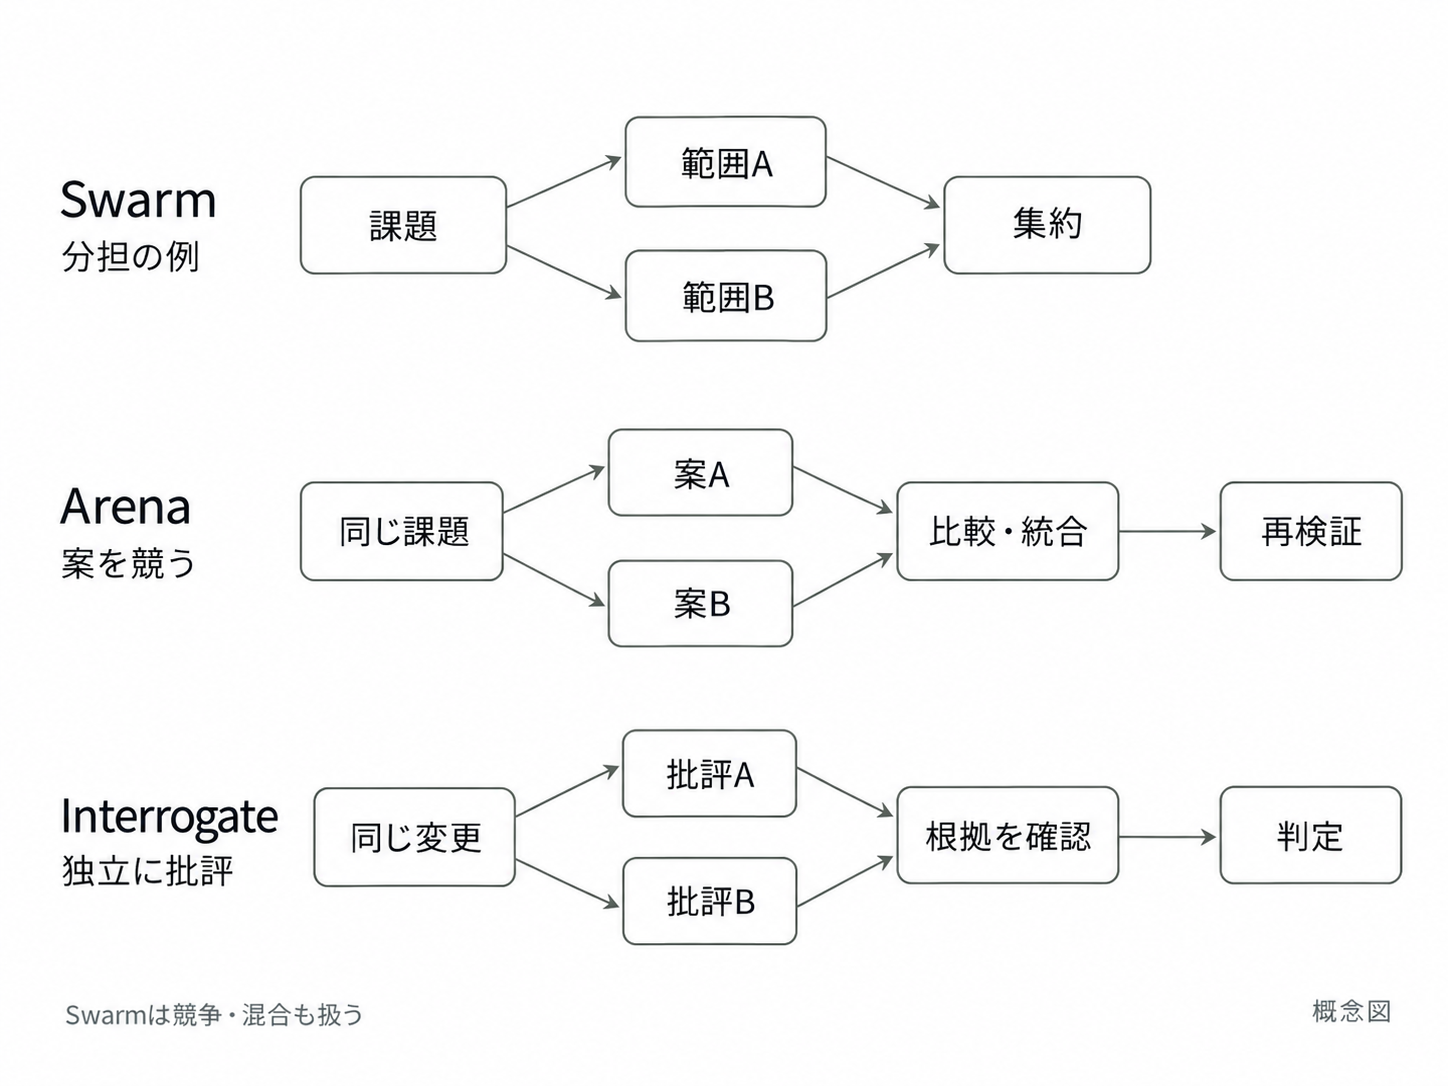
pstackはこの任せ方をSkillとして用意しています。Swarm(スウォーム)は分担・競争・混合、Arena(アリーナ)は完成案の比較と統合、Interrogate(インテロゲート)は同じ変更への独立した批評を扱います。
ログインアプリなら、画面の操作と処理の記録を別々に調べるのは分担です。同じ修正案の欠陥を探したいなら独立レビューが候補になります。どちらにも前回決めた検証条件を渡し、回答がそろっただけでは合格にしません。
使い分けの条件を読む
| 方式 | AIに渡す仕事 | まとめ方 |
|---|---|---|
| 単独で確認 | 1つの課題を1体で調べる | 自分の調査と検証で判断 |
| Swarm | 範囲を分担する、同じ課題を競う、両方を混ぜる | 決めた基準で結果と未調査範囲を集約 |
| Arena | 同じ課題の完成案を別々に作る | 土台を選び、必要な部分を統合して検証 |
| Interrogate | 同じ変更を独立に批評する | 指摘を照合し、根拠と影響で判断 |
Step 3:実際のSkillを読む
pstack/skills/swarm/SKILL.md のFrame〜Aggregateには、分担だけでなく競争や混合も指定されています。各担当へ目的、範囲、検証方法、報告形式を渡し、集約時は未調査の範囲を合格扱いしません。
pstack/skills/arena/SKILL.md のFrame〜Verifyは候補の作成後に別の評価役を入れます。取りまとめ役の親エージェント自身も全案を読み、基準ごとに評価します。部分を組み合わせたら、その統合後の成果物を検証します。
pstack/skills/interrogate/SKILL.md の冒頭は成果物と権限を短く定めています。
The deliverable is a synthesized verdict. Do NOT auto-apply changes.
返すのは統合した判定であり、修正の自動適用ではありません。原典は同じモデルに違う役を演じさせることより、異なるモデルで調べることを重視しています。Lead Judgmentでは指摘を対応、検討、記録、却下に分けます。
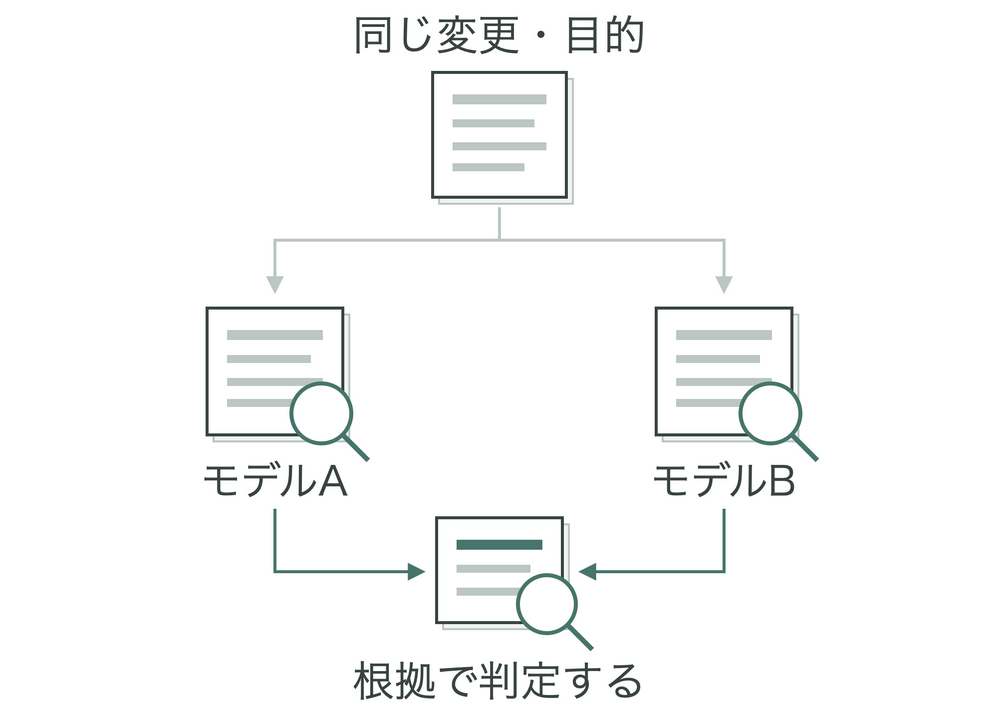
誰が何を根拠に採用するかまで決める設計です。2体の同意は手がかりになりますが、再現できる欠陥の証明とは別です。
注意
ただし:小さな仕事に人数を足さない
起動、説明、集約には時間と費用がかかります。同じモデルは見落としを共有する可能性もあります。単純な変更なら、1体と適切なテストで十分な場合があります。Codexでモデル指定や並列実行が使えるかは環境ごとに確認してください。
補足:設計を小さなコードで確かめる
複数のAIに計画書を批評させ続けても、実装できるかは分かりません。Laurenさんのガイド Pt.2とpstackの設計ガイドは、使い方や小さな試作を通じて設計を確かめる考え方を示しています。
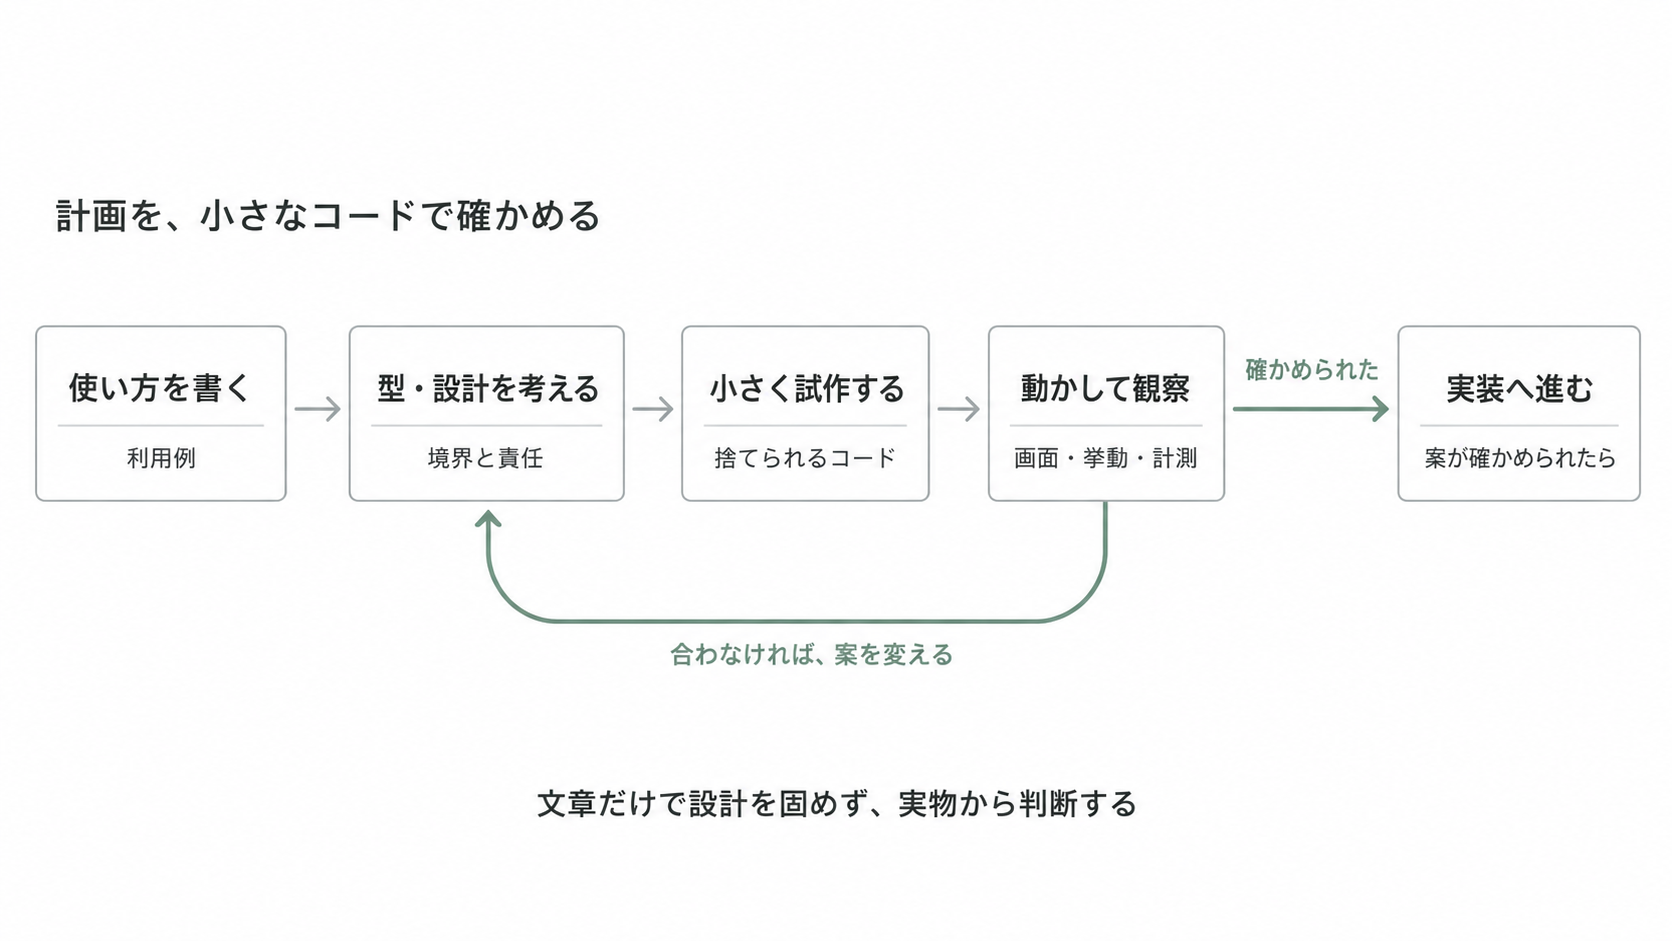
設計を担うarchitectの依頼文・L9–15は、使い方の例から型やインターフェースを導きます。型は「データに入れてよい値の約束」、インターフェースは「別の処理を呼び出す使い口」です。例えば、検索語を渡すと検索結果が返る、という使い方から決めます。
prototype(試作)・L7–14は知りたいことに絞って試し、観察結果を判断へ返します。試作はそのまま公開できる完成品ではありません。
批評そのものを避けるのではなく、抽象的な計画だけで議論を長引かせない設計です。反復する変更をAIへ分配する前に道具にできるか、という「Build the Lever」の原則は次回で扱います。
Step 4:Codexで独立レビューを試す
ログイン画面のような大きな変更を読む前に、条件の見落としを短い教材で確かめます。次は教材用の小さなJavaScriptで、実際のアクセス許可を決める処理ではありません。仕様は「購入済み、かつ期限前だけダウンロード可」。期限と現在時刻は同じ単位の数値とします。
function canDownload(paid, expiresAt, now) {
  return paid || now < expiresAt;
}
paidは購入済みか、expiresAtは期限、nowは現在時刻です。||は「どちらかを満たす」、<は「より小さい」を表します。仕様の「かつ」と、コードの条件を比べてみてください。
別々の新規チャットA・Bへ、同じモデル設定と次の文を渡します。他方の回答は見せません。並列機能がなくても順番に試せますが、これはInterrogateの考え方の実験であり、pstack自体の実行ではありません。同じモデルを使うこの実験で試すのは独立した入力と指摘の照合までで、モデル多様性の効果は評価しません。
読み取り専用で、次の仕様とコードの不一致を調べてください。
ファイル作成・変更、コマンド実行、外部アクセスはしないでください。

仕様:購入済み、かつ期限前だけダウンロード可。
paidは購入済みならtrue、未購入ならfalse。expiresAtとnowは同じ単位の有限な数値。
期限時刻ちょうどは期限切れです。

function canDownload(paid, expiresAt, now) {
  return paid || now < expiresAt;
}

各指摘に、具体的な入力、期待値、コードが返す値を添えてください。
同じ原因の指摘はまとめ、仕様にない要件は欠陥に数えないでください。
修正コードではなく、指摘と未確認事項だけを返してください。
A単独の結果を比較の基準にし、AとBの結果を人が照合した場合と比べます。入力を変えず、同じ原因は1件として数えます。例えば未購入で期限前の入力は、仕様とコードを比べる手がかりになります。
| 記録するもの | 比較する内容 |
|---|---|
| 確かめられた欠陥 | 具体的な入力で不一致を説明できた数 |
| 誤指摘 | 仕様にない要件や、実際には合う入力の数 |
| 追加の発見 | Bを加えて初めて確認できた欠陥の数 |
| 負担 | 生成と人の照合にかかった時間 |
この1例で優劣は決まりません。追加の発見がゼロなら、それも結果です。
セルフチェック
1. 独立した2体が同じ不具合を指摘しました。次に何をしますか?
今回持ち帰るもの
ログインアプリの未確認事項から1つ選び、任せる仕事と合格の証拠を1文ずつ残します。1体で十分なら、分担しない判断で構いません。次回へ渡すのは今回決めた確認計画と、残った未確認事項です。
今日のまとめ
- 分担:Swarmは仕事の分け方と結果の集約を決める。
- 探索:Arenaは候補を比較し、統合した成果物も検証する。
- 批評:Interrogateは指摘を精査し、発見と修正を分ける。
次回の問い
見つけた失敗を、その場の修正だけで終わらせないためには? 次は失敗を次の検査に変える方法を読みます。