2024年10月、ノーベル化学賞の発表を聞いたとき、私は外来の合間にニュースを開いて少し立ち止まった。
「AIがノーベル賞を取った」と報じられていた。 正確には人間3人が受賞した。 David Baker(ワシントン大学)はタンパク質の計算設計、Demis Hassabis と John Jumper(Google DeepMind)はAlphaFold2による構造予測。賞金の半分はDeepMind外の研究者であるBakerに贈られた。
「Google DeepMindがノーベル賞」という見出しは、事実の半分しか伝えていない。
この「事実の半分しか見えていない」感覚が、このレッスン全体を貫くテーマになる。
私たち医療職がAIを使うとき、毎日同じ感覚に出会う。 精度の数字は出ている。論文も読める。 だが、それが「理解している」のか「パターンを当てている」のかは、別の問いだ。 そして、その違いは患者の前で問題になる。
ㅤ
1. AlphaFold2が示したもの
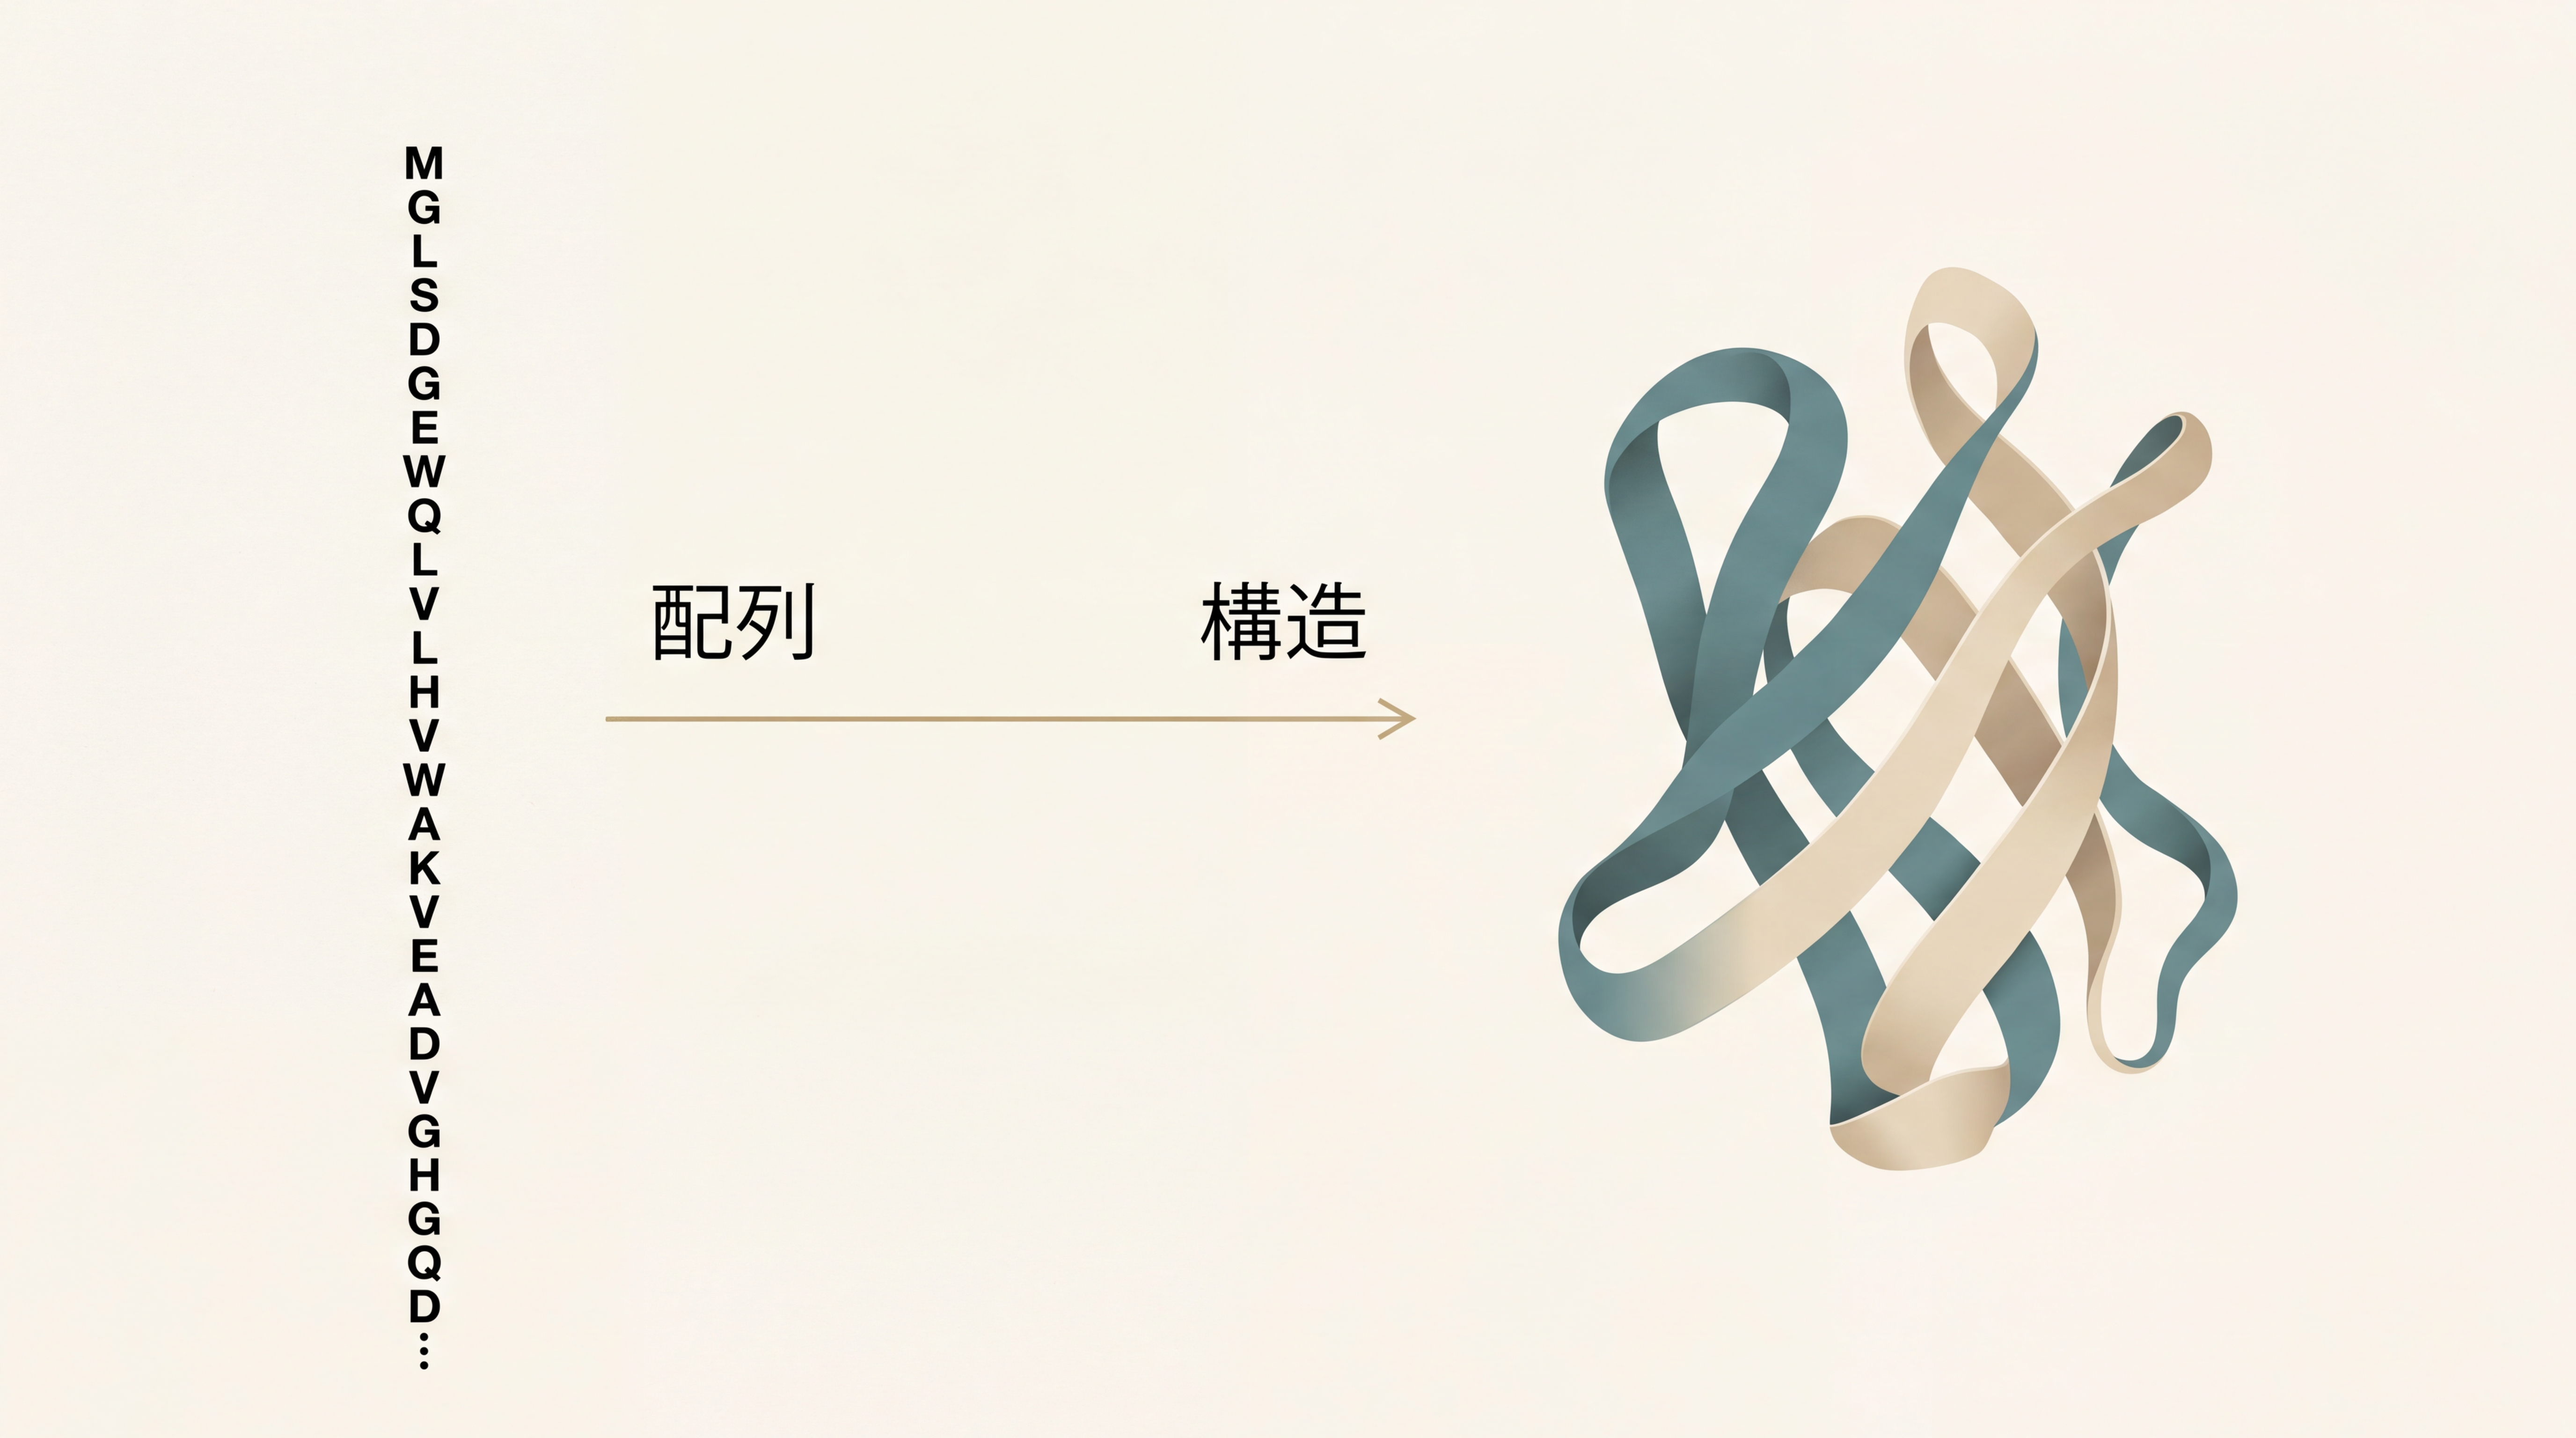
AlphaFold2が解いたのは「タンパク質フォールディング問題」だ。アミノ酸配列から立体構造を予測する問題で、50年間解けなかった。
Jumper らの論文(Nature, 2021, DOI: 10.1038/s41586-021-03819-2, PMID: 34265844)によれば、CASP14の中央値 GDT_TS スコアは 92.4/100 だった。AlphaFold データベースは2024年10月時点で190か国・200万人以上が使用し、予測構造数は214百万配列に上る。ただし全配列が高信頼度で予測されているわけではなく、信頼度スコア(pLDDT)は配列によって大きく異なる。
ここで問いたいのは、AlphaFold2はタンパク質を「理解」して予測しているのか、それとも「パターンを学習」して予測しているのか、という点だ。
答えは後者に近い。膨大なアミノ酸配列と構造のペアからパターンを抽出し、新しい配列に対して構造を予測している。生化学のメカニズムを「概念として理解」しているかどうかは、別の問いだ。
そしてその「別の問い」こそが、このレッスンの本題である。
ㅤ
2. チューリングの知的誠実さ(1950年)
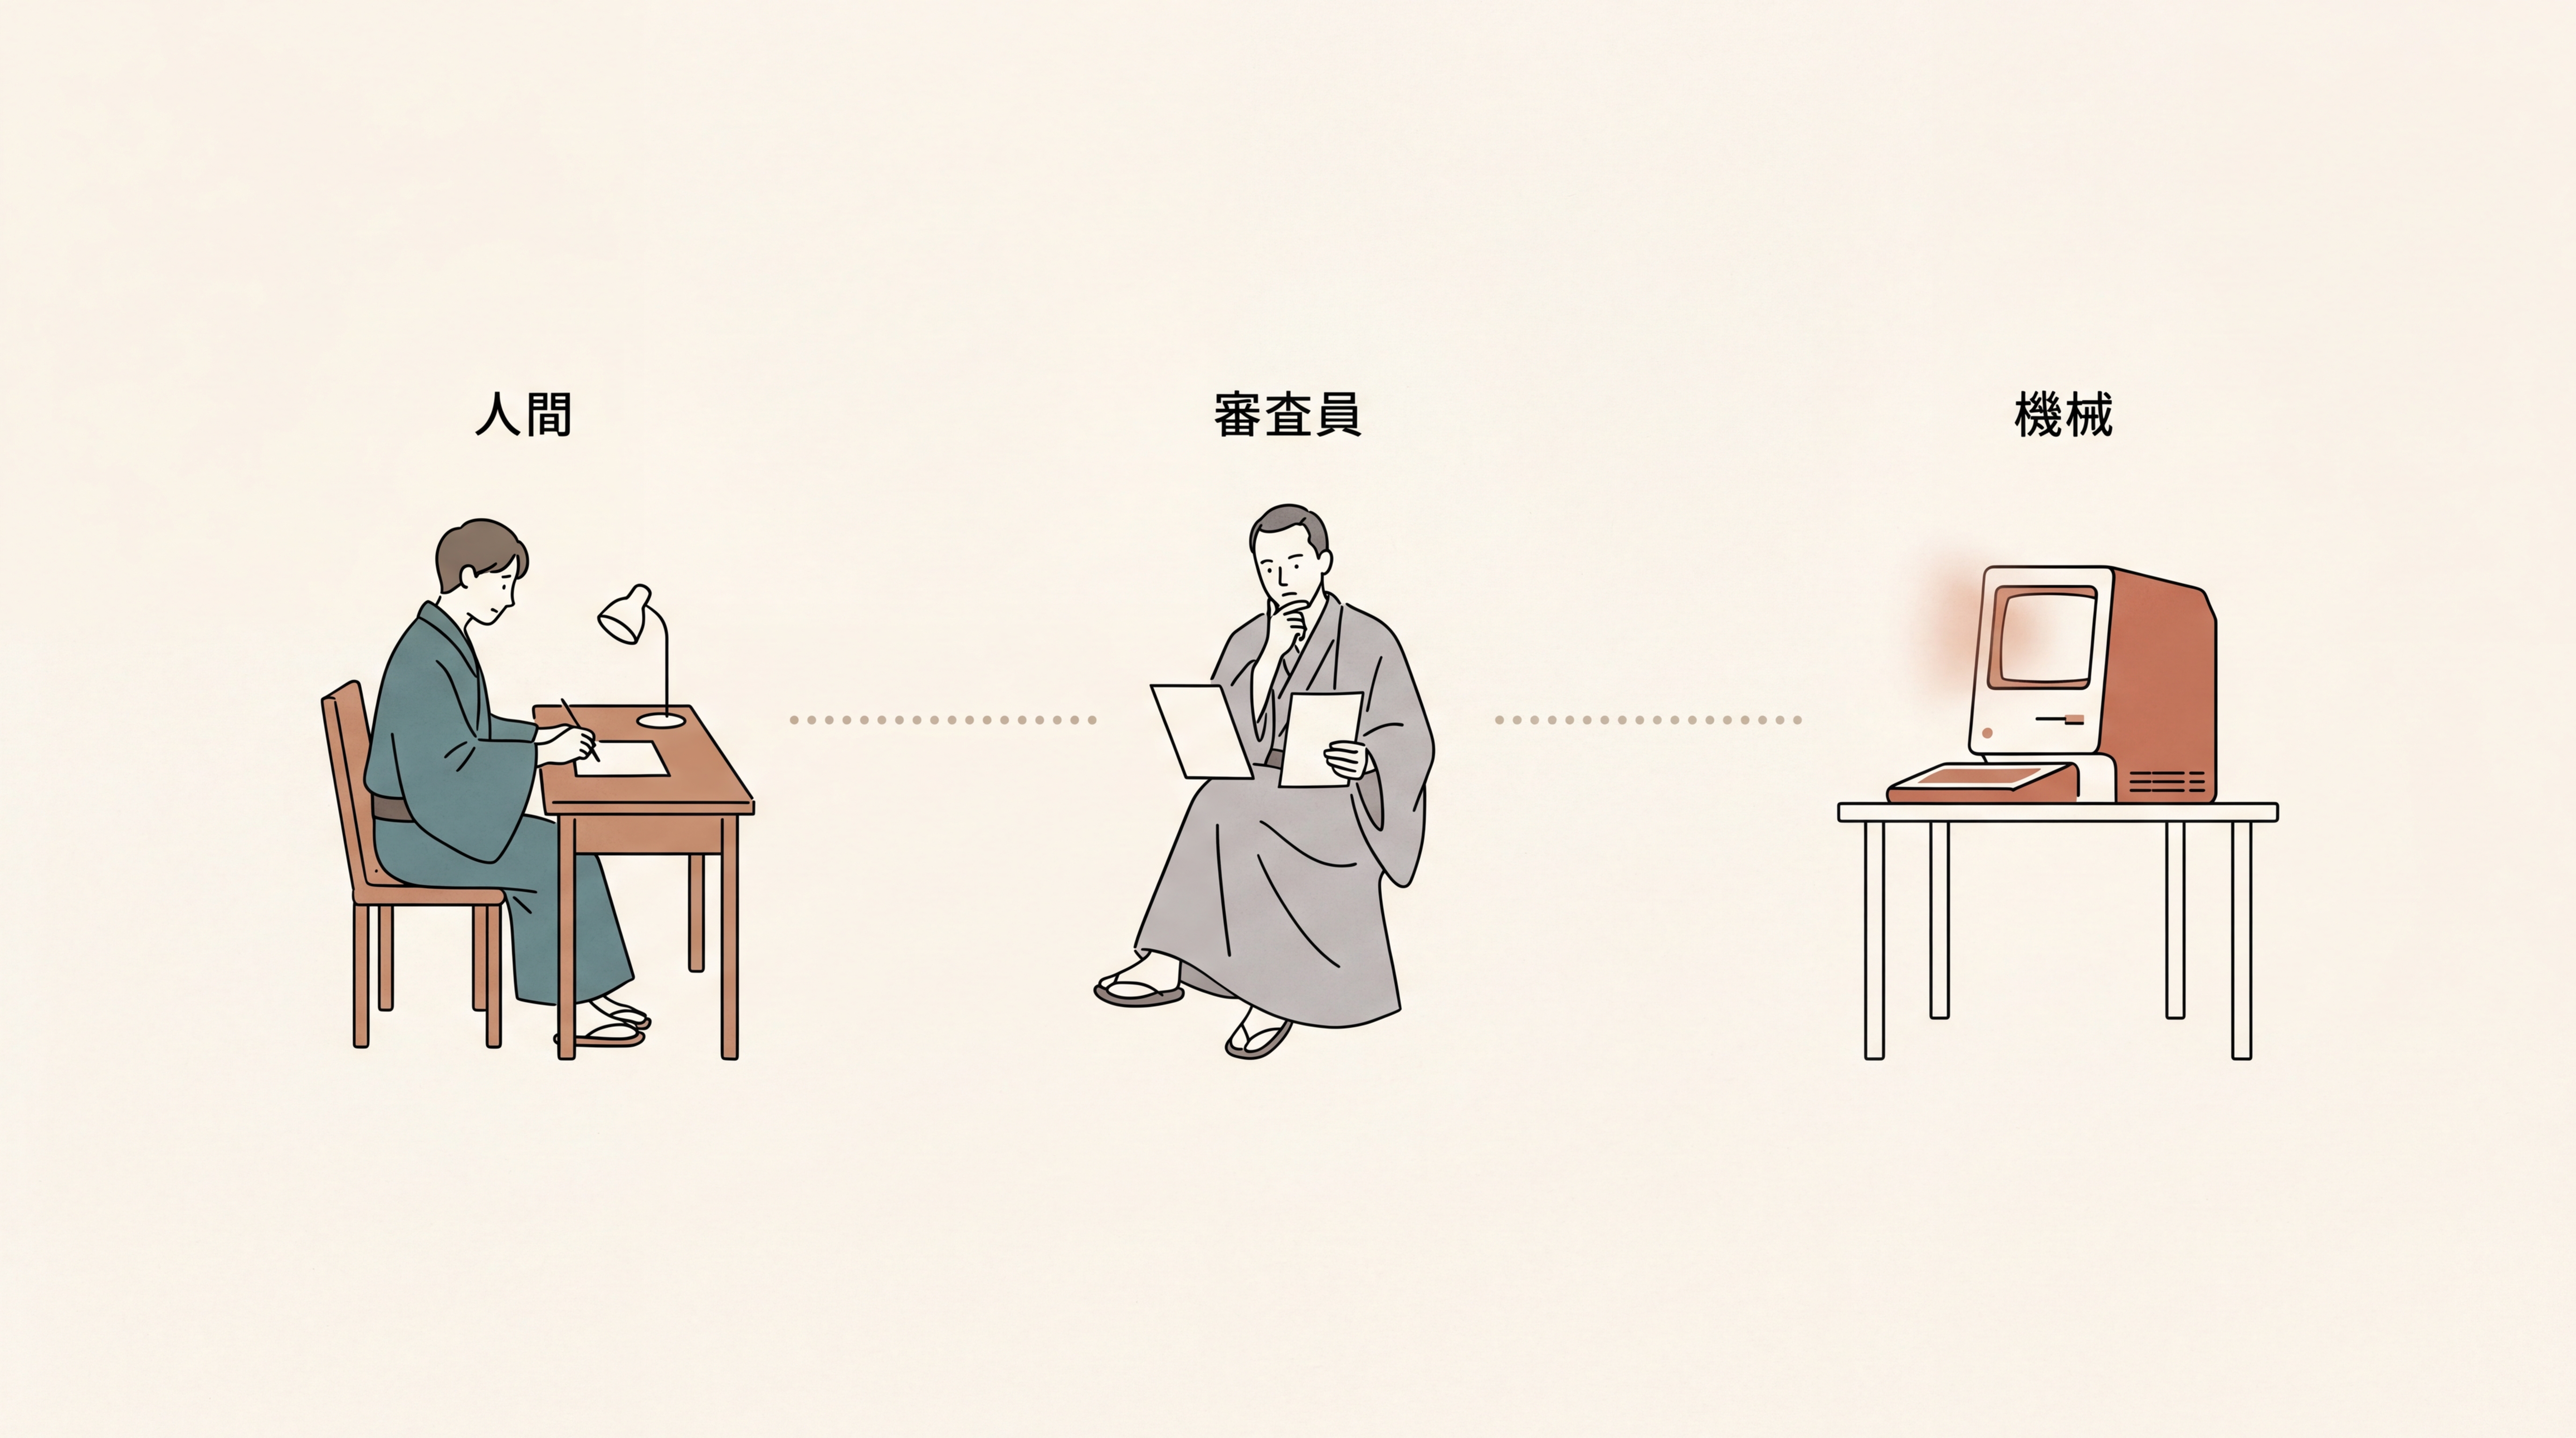
1950年、イギリスの数学者アラン・チューリングは論文「Computing Machinery and Intelligence」を発表した。冒頭の問いは「機械は考えることができるか?(Can machines think?)」だった。
チューリングは「知能とは何か」への直接回答を避け、人間と区別できるかという「模倣ゲーム」を提案した。約50年後、5分間の対話で審査員が正しく識別できる確率は70%を超えないだろう、と予測している。これは知能の定義ではなく、外側の振る舞いによる判定方法だ。
ㅤ
3. サールの反論:統語論は意味論を生まない
チューリングテストに対して、もっとも鋭い反論を提出したのが哲学者のジョン・サールだった(しばしば内在主義と呼ばれる立場の代表で、知能や意識は外側の振る舞いだけでは捉えきれず、内部で何が起きているかを問う必要があるとする)。1980年のことだ。
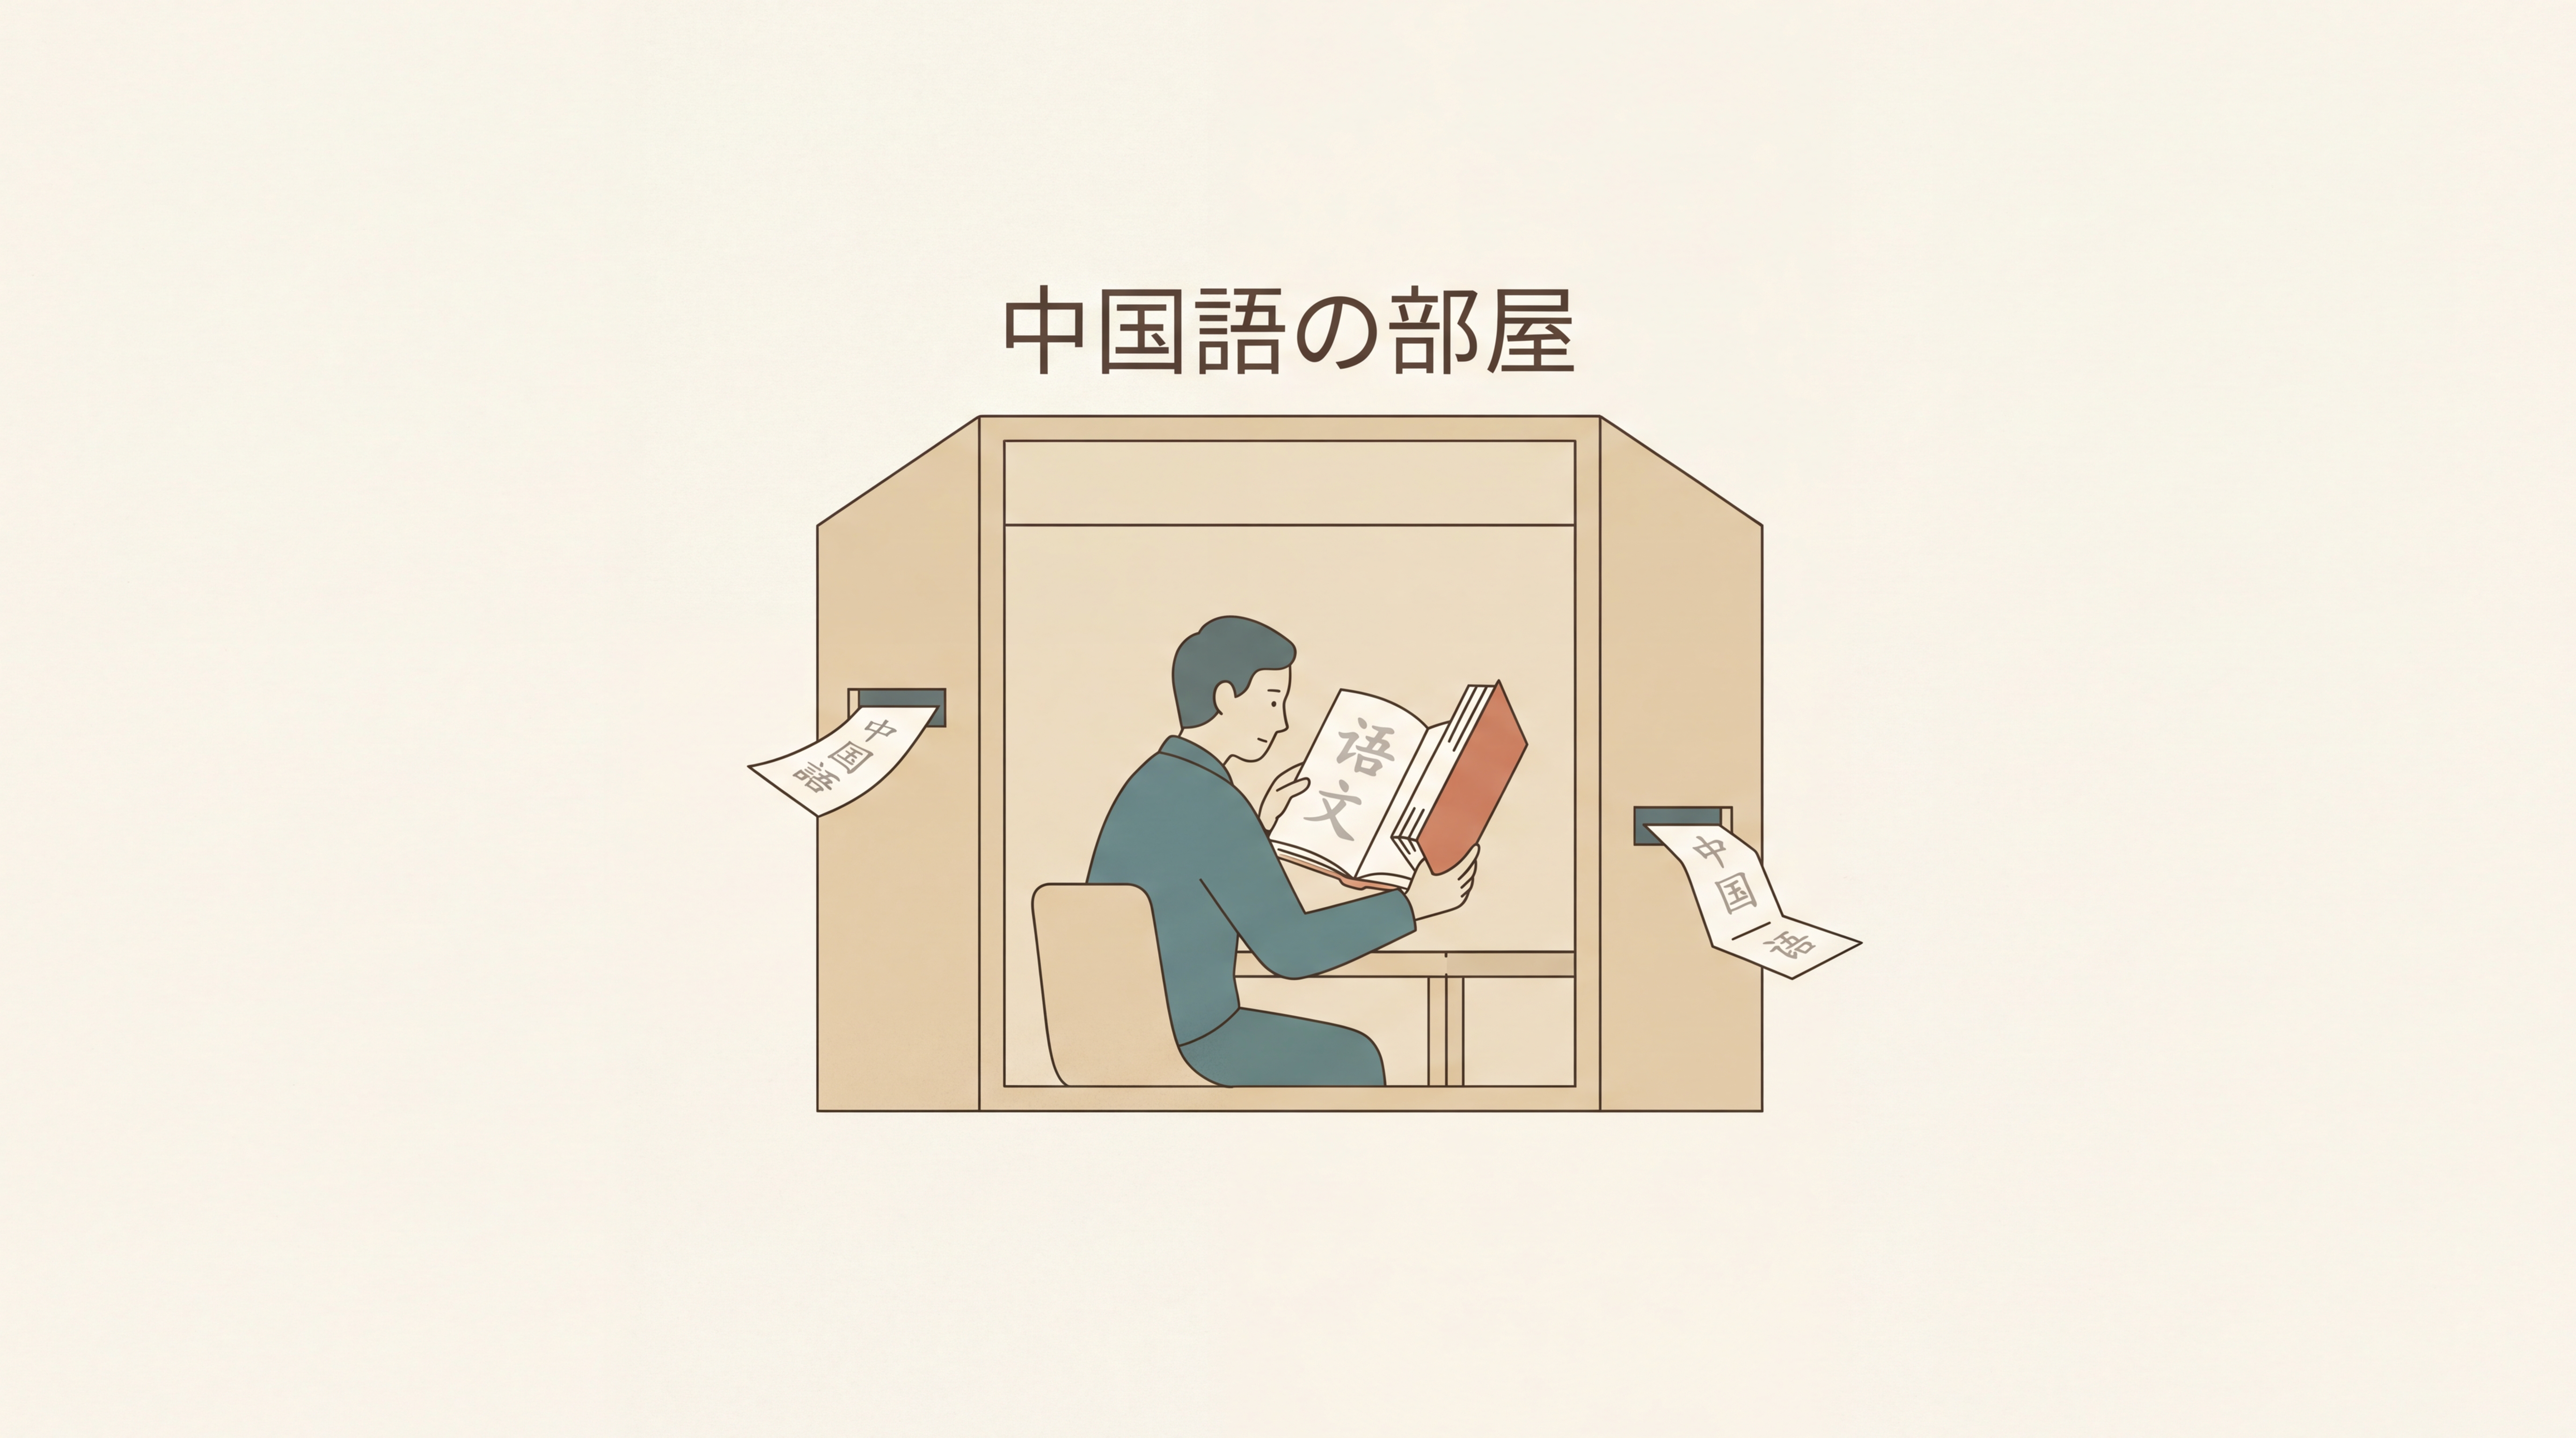
サールの「中国語の部屋」思考実験はこうだ。英語しか知らない人が、部屋の中で中国語の規則書だけを使い、外から投げ込まれる中国語の質問に回答する。外から見れば中国語話者と区別できないが、部屋の中の人は中国語を一切「理解」していない。
サールはここから次の主張を導いた。
「構文(syntax)は意味論(semantics)を生まない。プログラムを実行するコンピュータは、どれほど人間のように振る舞っても、心・理解・意識を持ちえない」
出典: Searle, J.R. (1980). Minds, brains, and programs. Behavioral and Brain Sciences, 3(3), 417–424. DOI: 10.1017/S0140525X00005756
この論文は BBS 史上最多引用の「ターゲット論文」となった。同誌上で27名の認知科学者が反論コメントを掲載し、その中には「部屋全体のシステムが理解している(Systems reply)」という反論もある。
2020年には言語学者のベンダーとコラーが「タコ思考実験」を使って同様の問いを立てた。テキストの統計的パターンだけを学習したシステムが「意味」を学べるはずはない、という主張だ(Bender, E.M. & Koller, A. (2020). Climbing towards NLU. ACL 2020, 5185–5198)。
LLMは「次のトークンを予測する」ことで動いている。その予測の背後に「意味の理解」があるのか、という問いはまだ決着していない。
4. 2026年の問い:Anthropicの解釈可能性研究
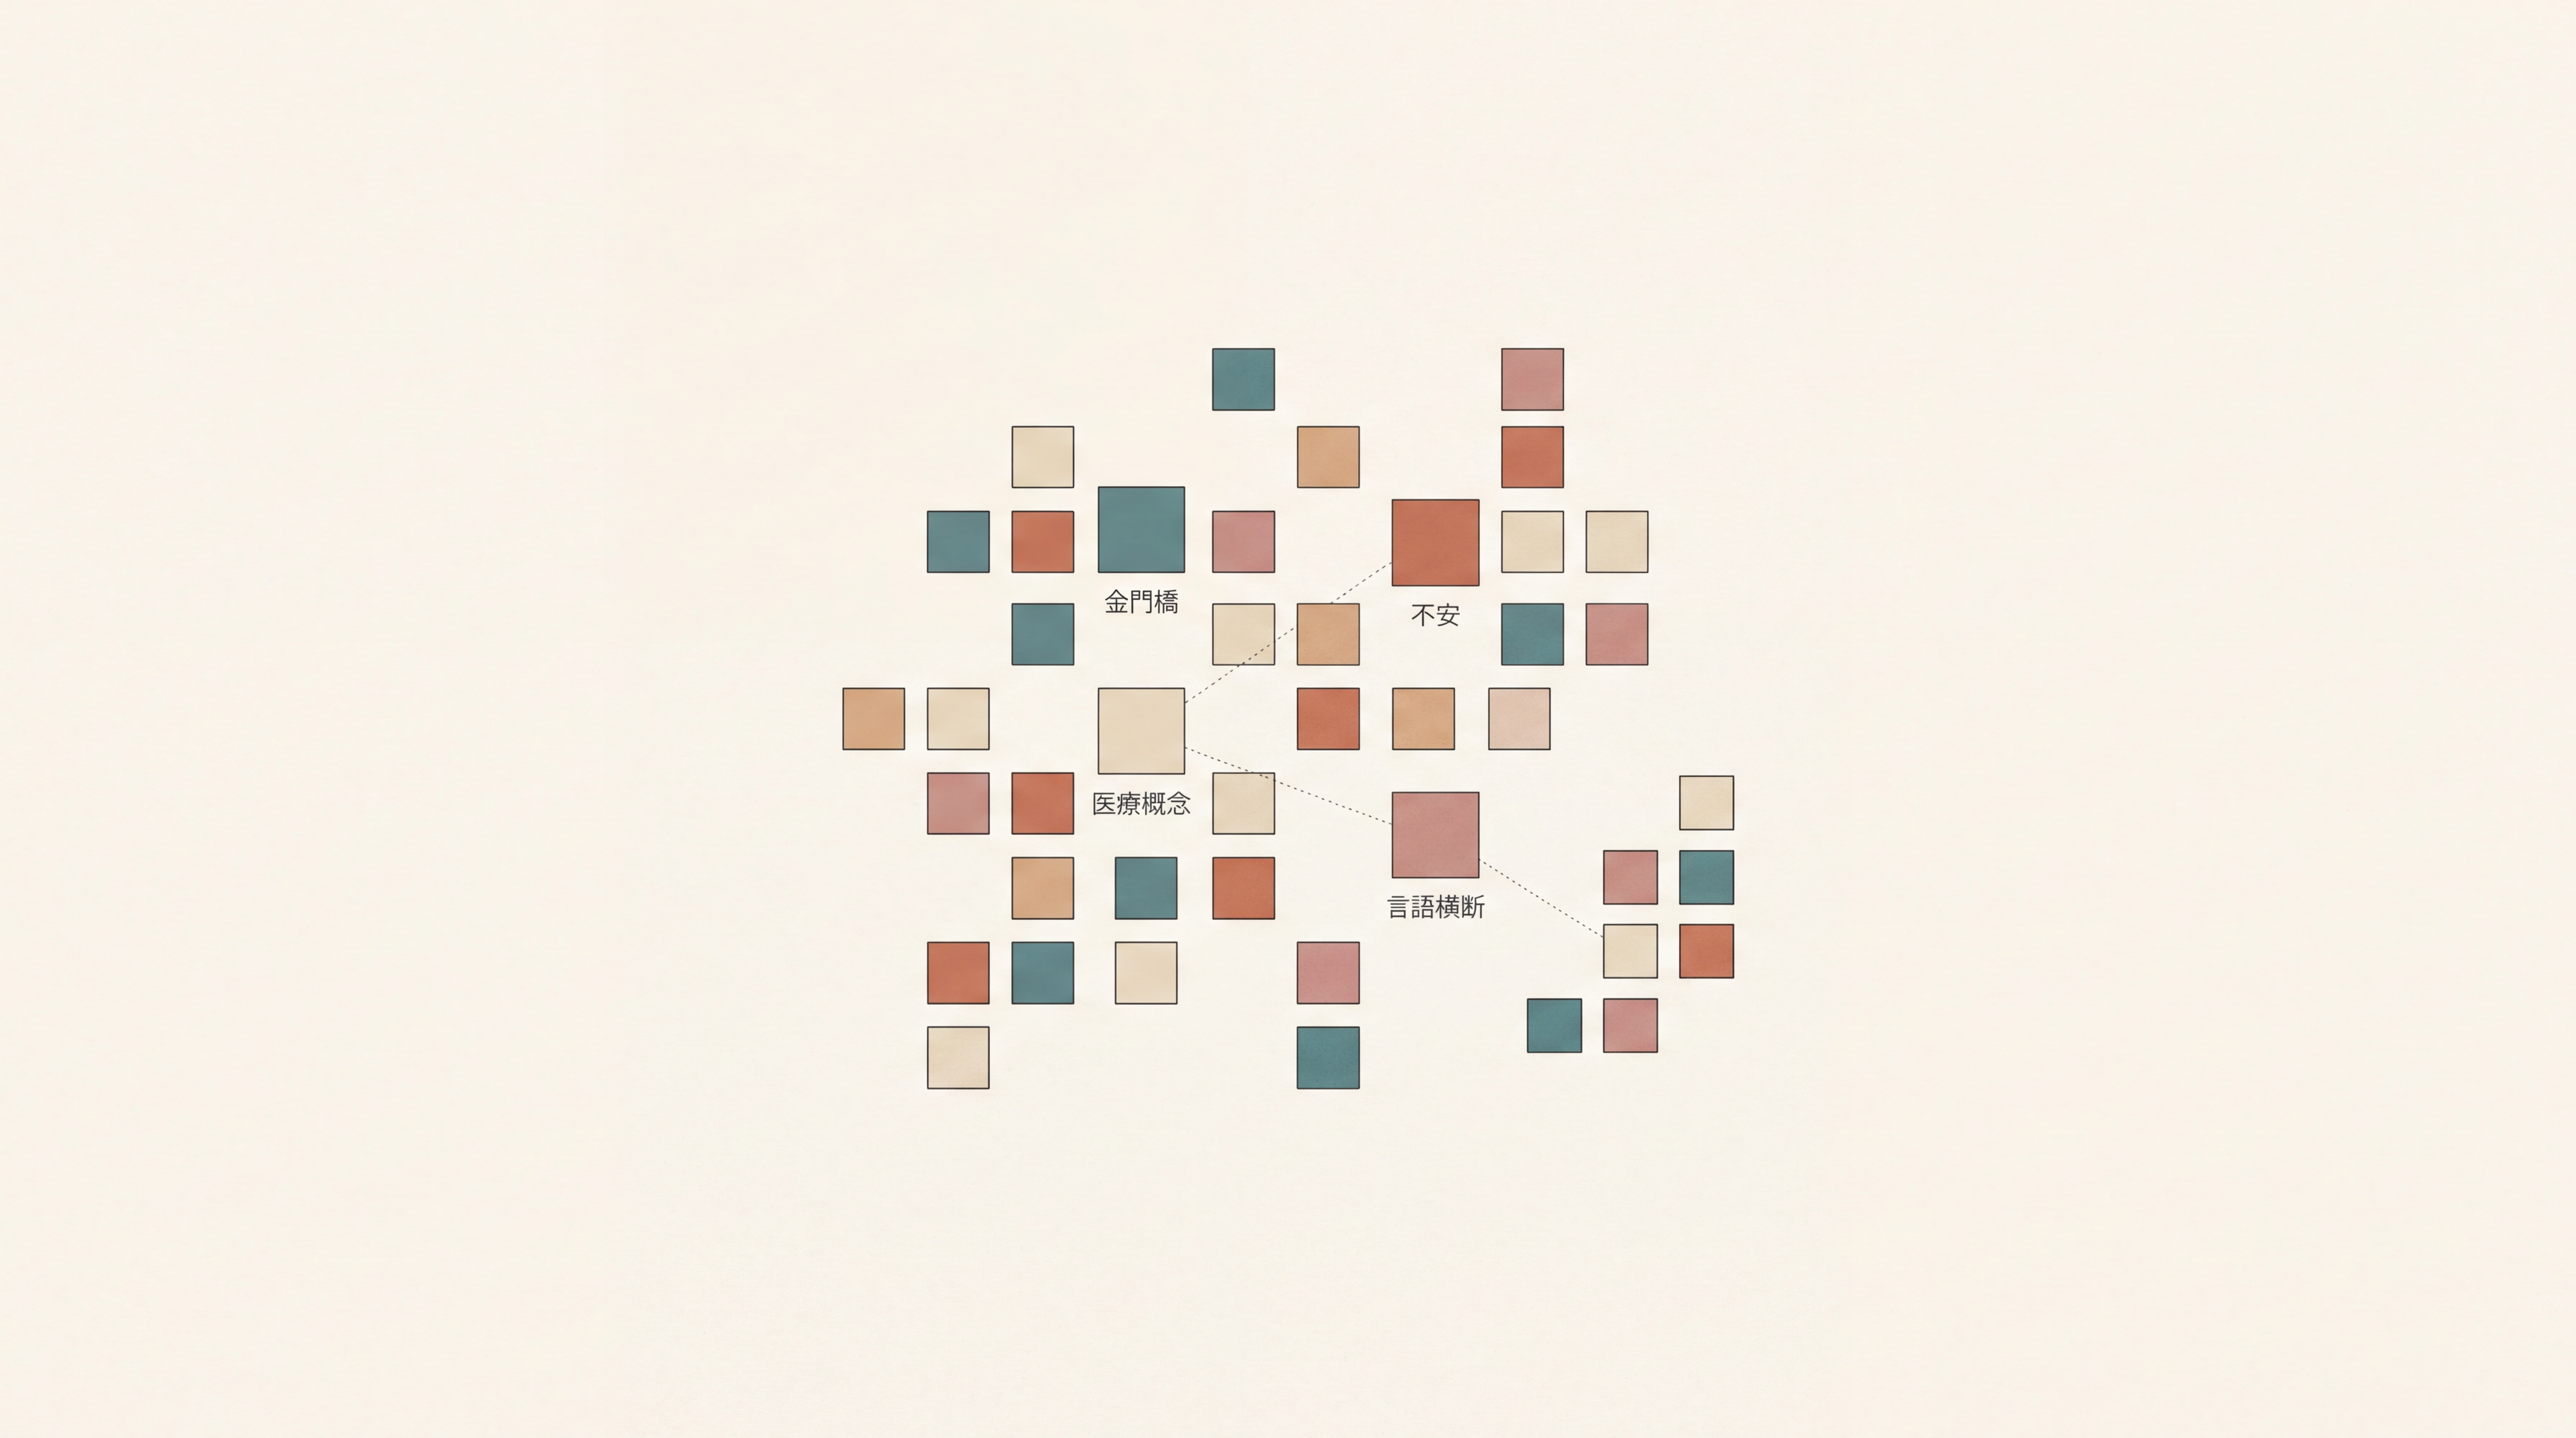
サールの問いに、現代の機械学習研究は新しい角度から答えを試みている。
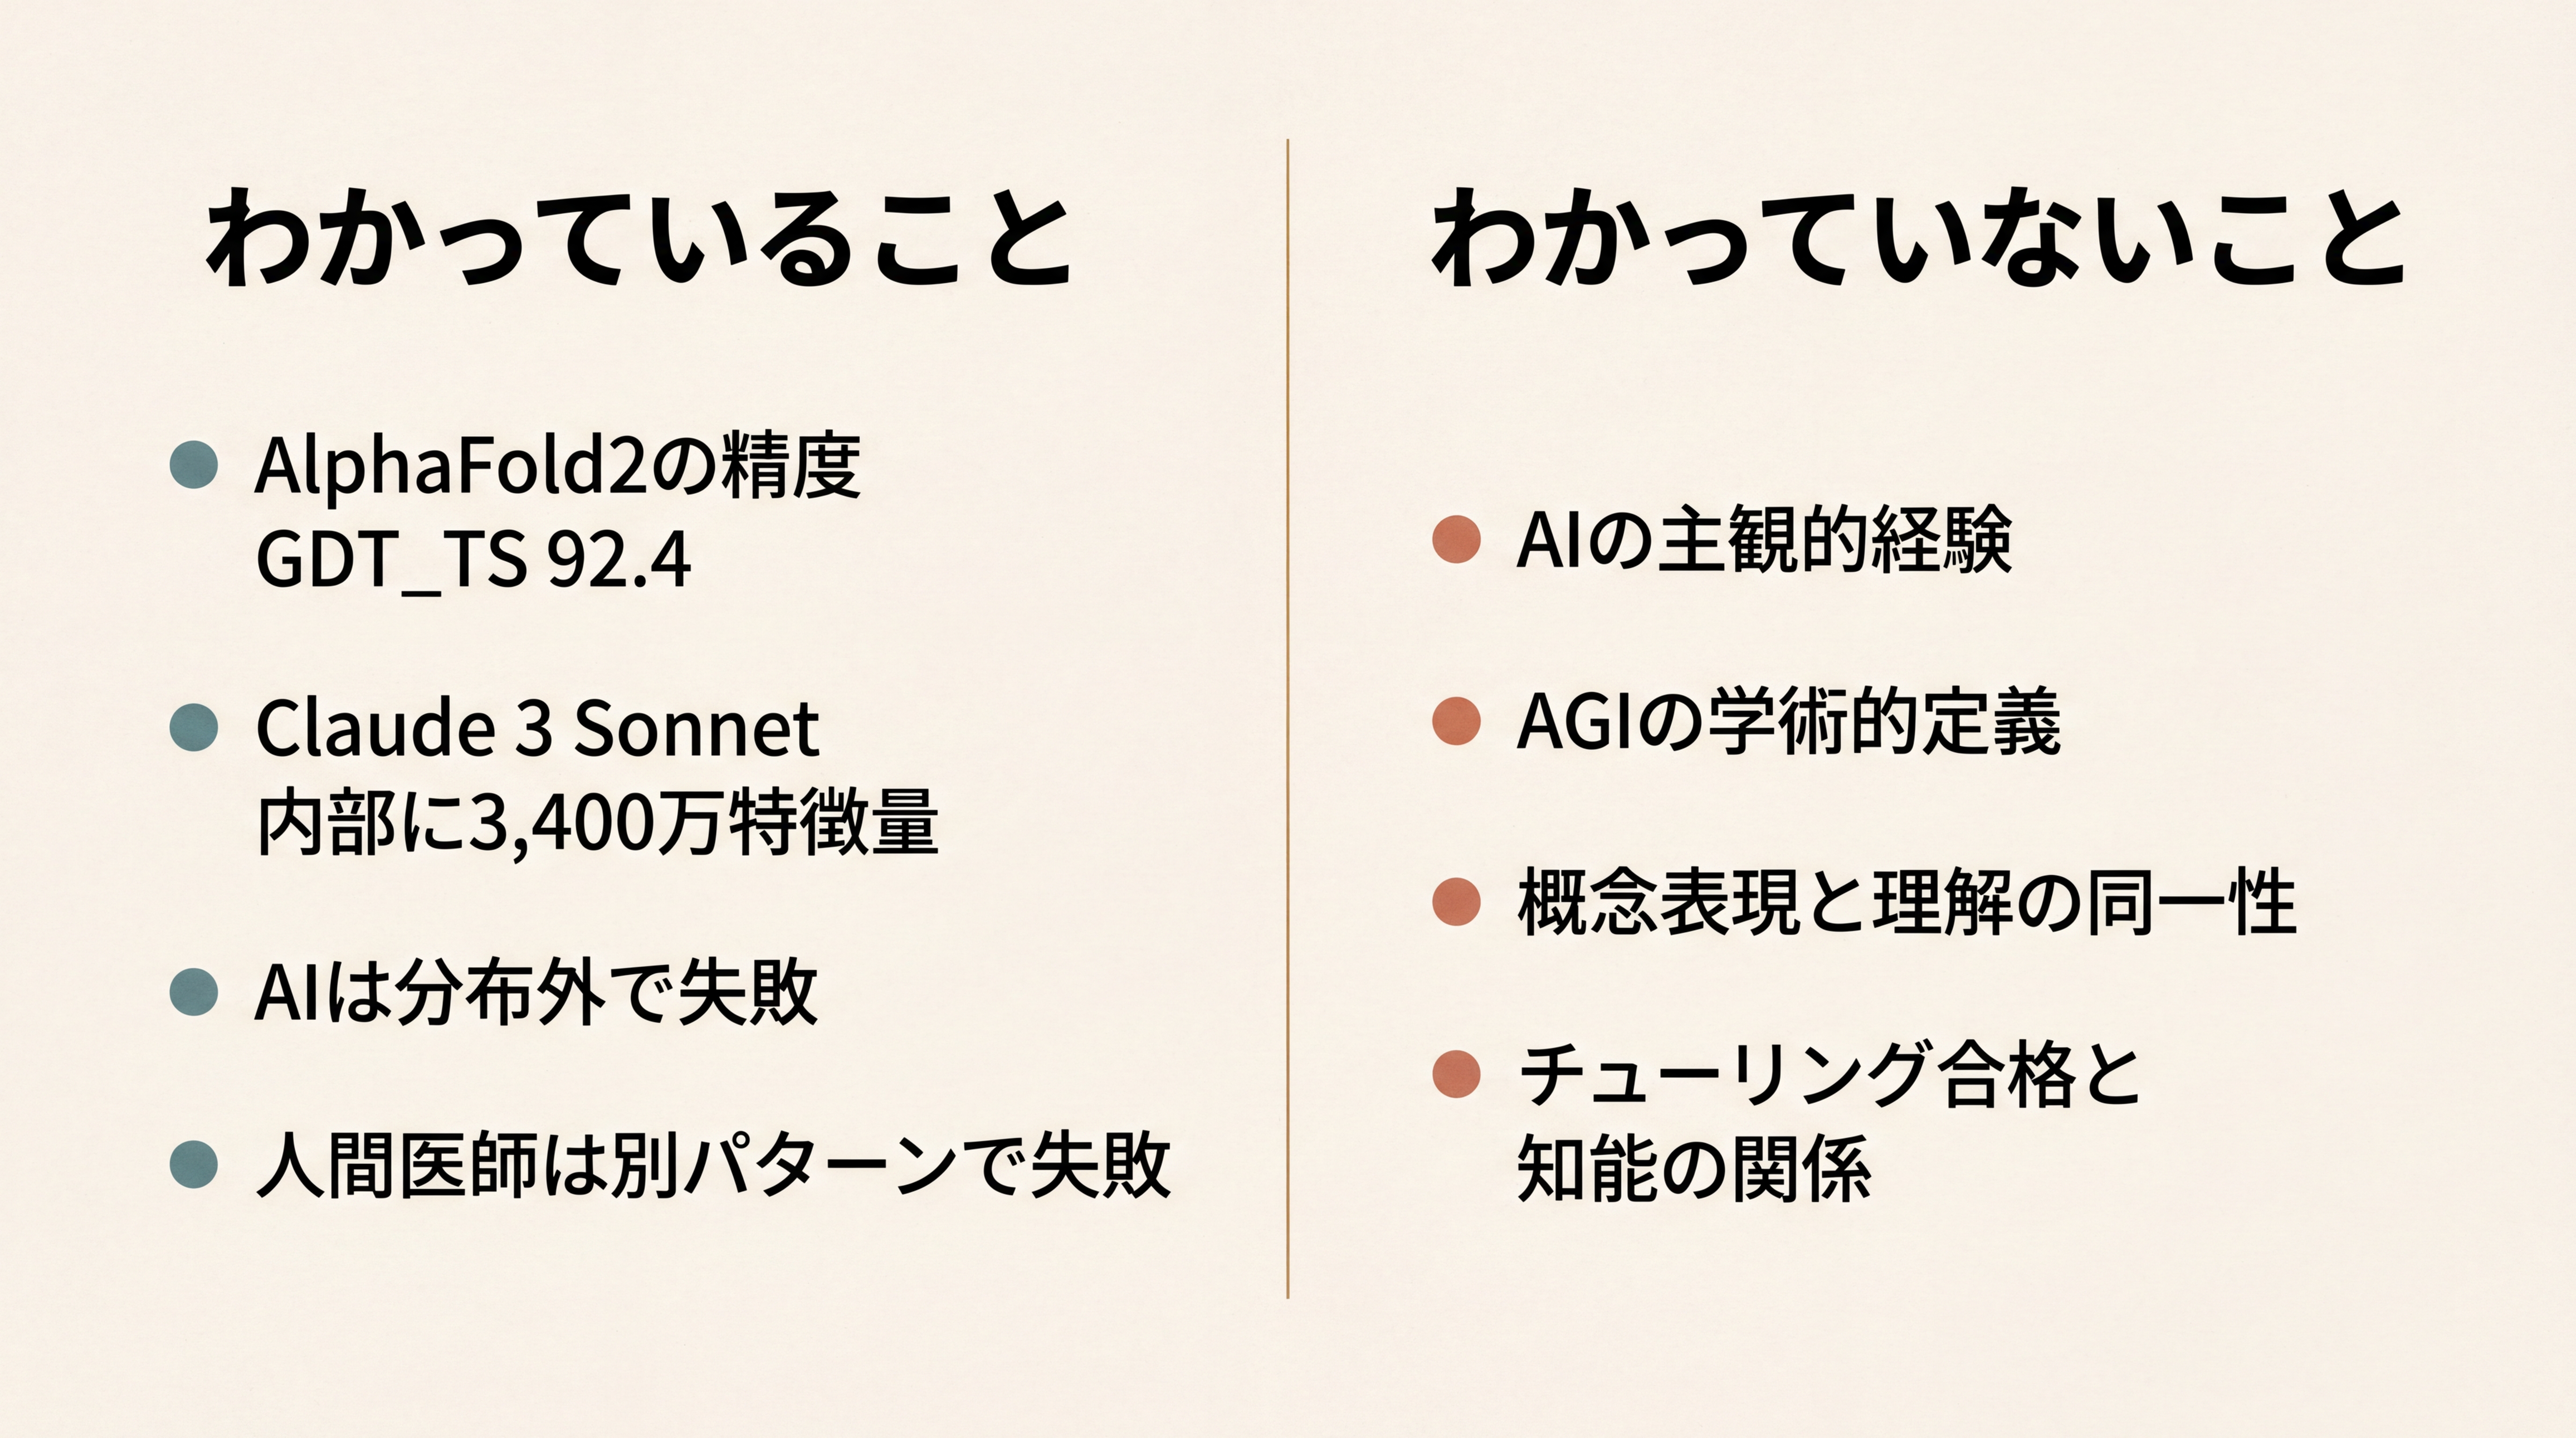
2024年5月、Anthropic(Claude を開発する会社)は「Scaling Monosemanticity」という論文を発表した。Claude 3 Sonnet の内部表現を解析した結果、約3,400万の「解釈可能な特徴量」が存在することを示した(Templeton et al., 2024, transformer-circuits.pub)。
たとえば「金門橋」「不安」「医療診断」「中国語と英語の同じ概念」など、人間が名前を付けられる概念が、抽象空間の特定の方向として埋め込まれていた。言語をまたいで同じ概念が同じ方向にマッピングされていた、というのが特に印象的だ。
これは「ChatGPTやClaudeは統計マシンにとどまらず、概念的な内部表現を獲得しているのではないか」という方向の証拠になる。
ただし、これが「サールの言う『理解』に到達した」と言えるかは別問題だ。
「概念表現がある」ことと「主観的に経験している」ことは違う。後者は意識のハードプロブレムと呼ばれ、現在も哲学・神経科学・認知科学のいずれでも未解決のままだ。
ㅤ
5. 強いAI・弱いAI・AGI:定義の混在
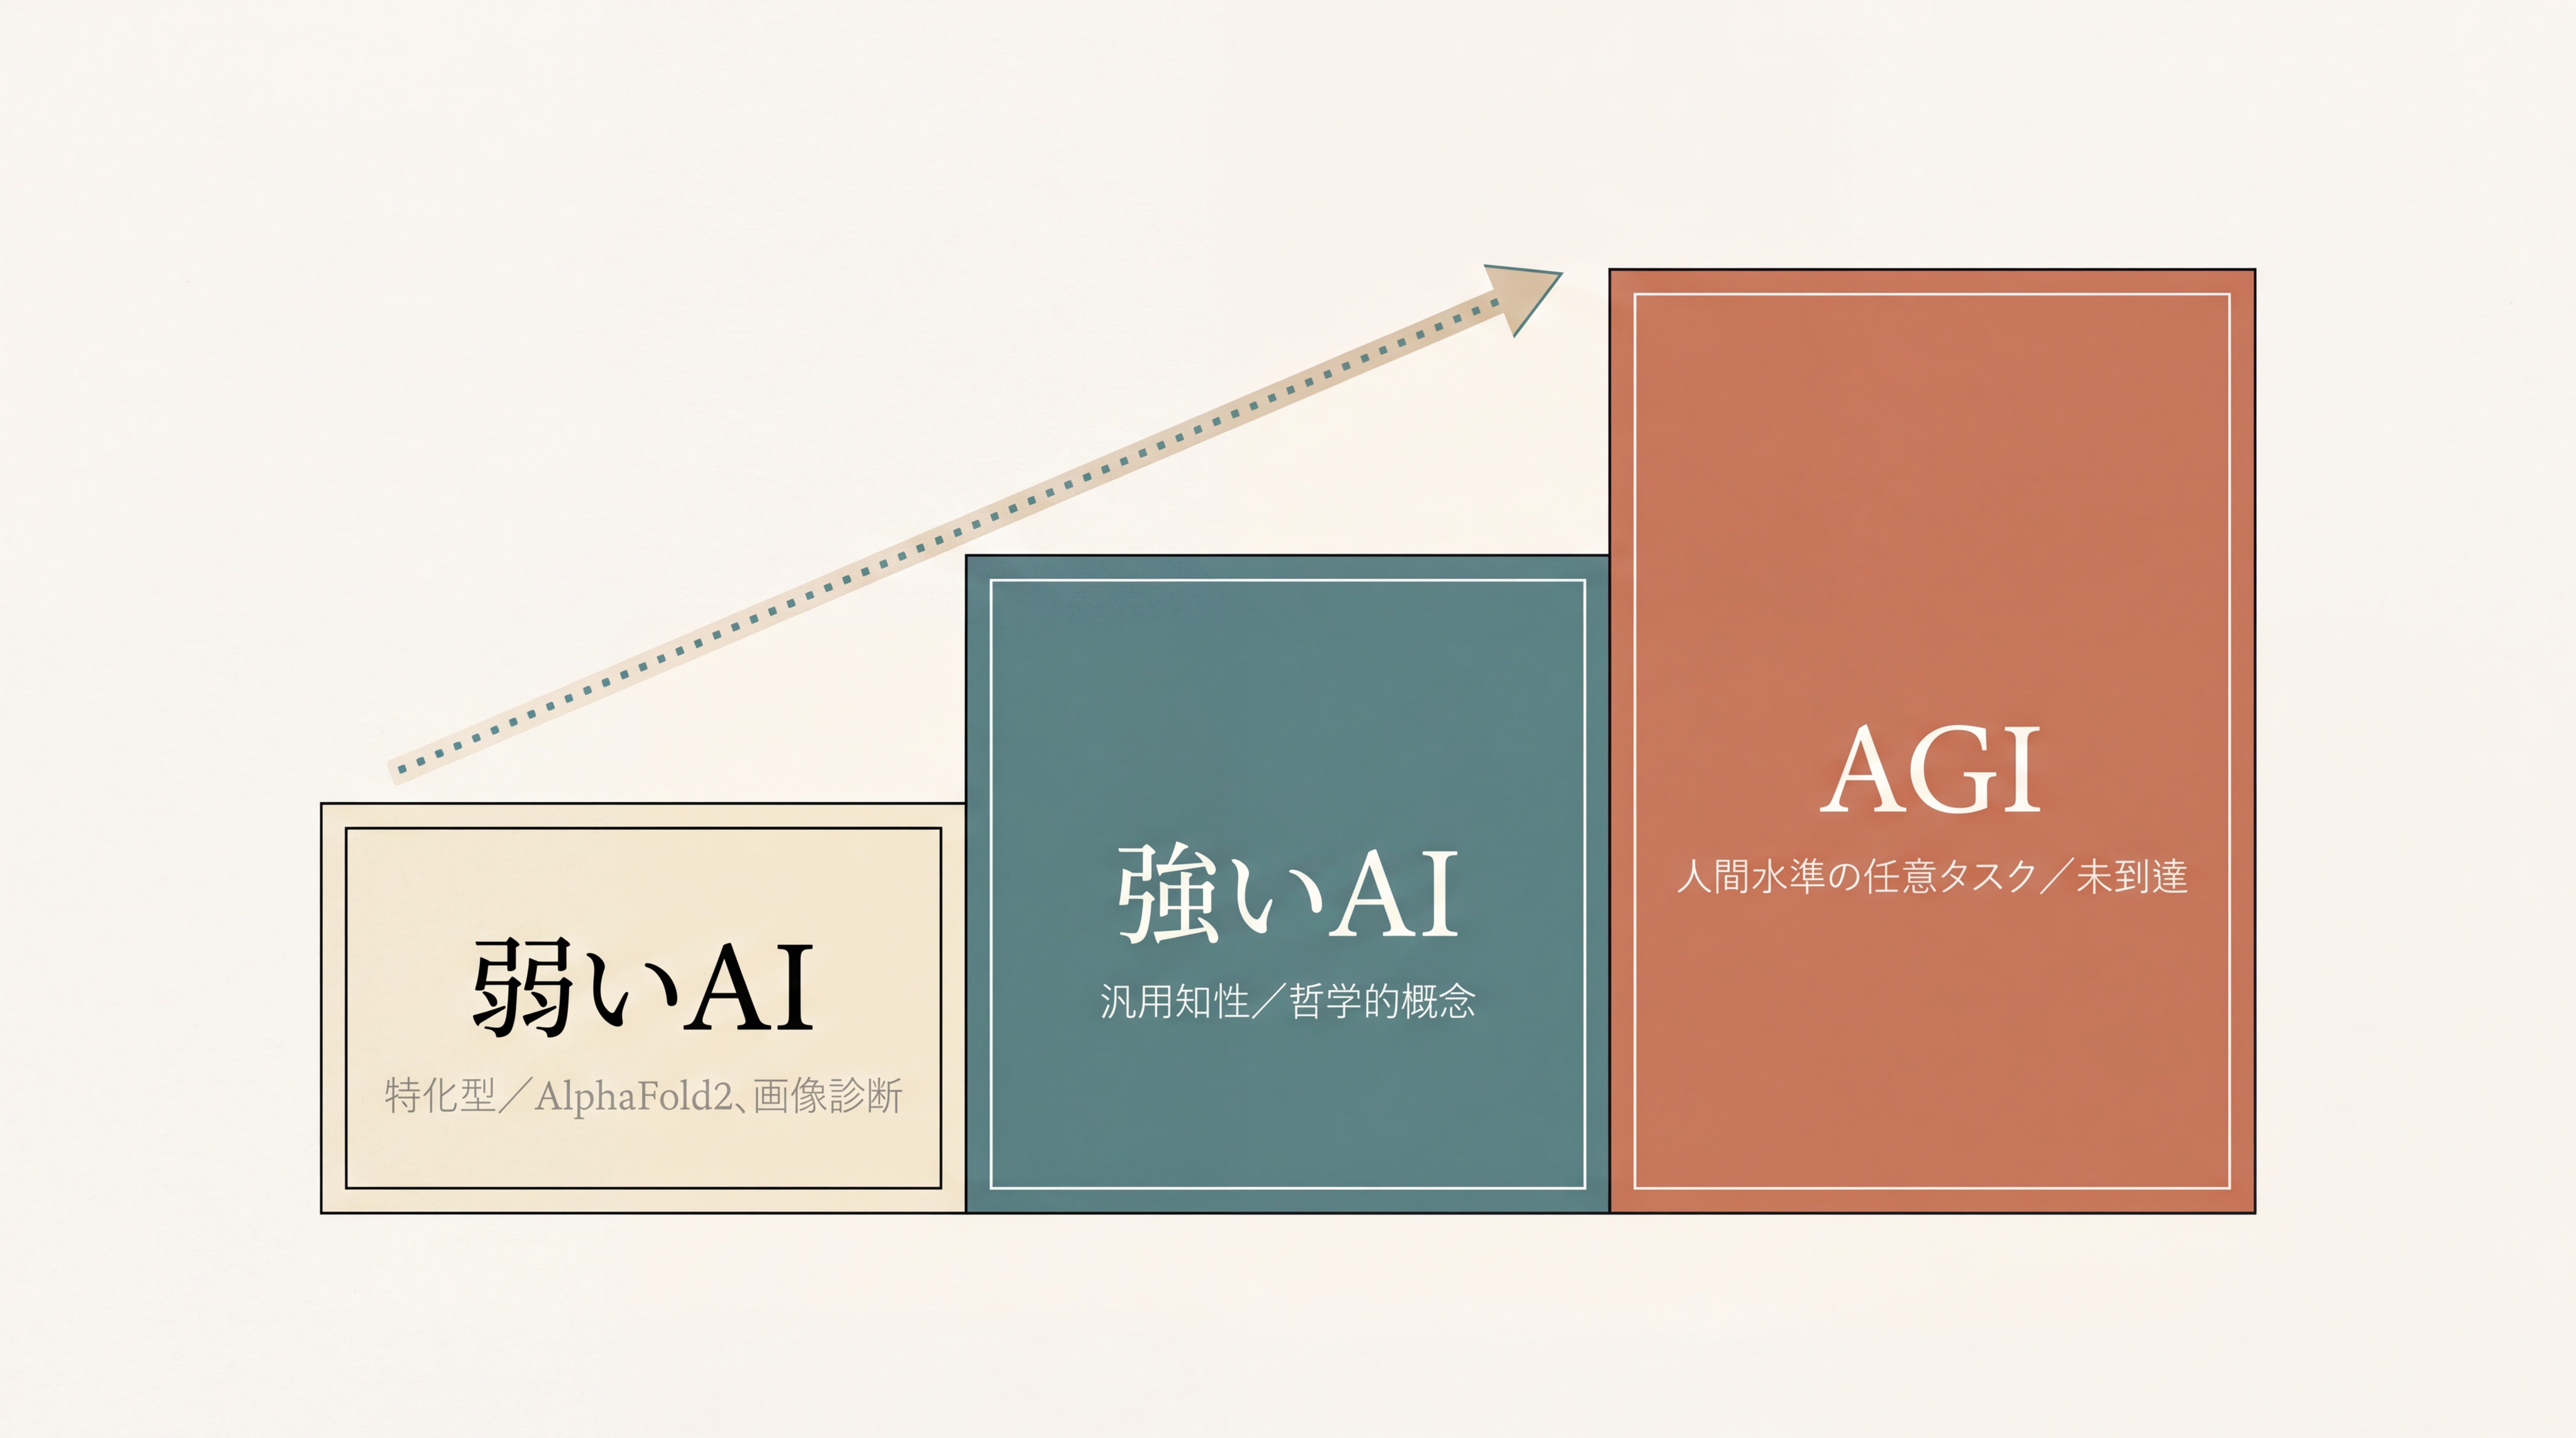
ここで言葉の整理をする。
弱いAI(Weak AI / Narrow AI): 特定のタスクに特化したAI。AlphaFold2、画像診断AI、囲碁AIなど。現在の医療AIはほぼ全てこの範疇に入る。
強いAI(Strong AI): サールが定義した用語で、「人間と同じ意味で考え・理解する」AI。哲学的概念であり、技術的なベンチマークではない。
AGI(Artificial General Intelligence): 人間が経済的に価値あるとされるタスクのほとんどで、人間と同等以上に達成できる汎用人工知能。学術的なコンセンサスは2026年4月時点で存在しない。Morris ら(2024)は「Levels of AGI」というフレームワークで5段階に分類した。
問題は、これらの言葉がしばしば混同されることだ。「ChatGPTはAGIに近い」と言われることがあるが、ChatGPTは特定のタスク(テキスト生成)に強いだけで、医療現場で求められる多様な判断(身体所見、患者背景、検査結果の統合)を全て担えるわけではない。
「AGI」という言葉が独り歩きしている分、私たち医療職は「具体的にこのタスクで」「この精度で」という解像度で考える習慣を持ちたい。
ㅤ
6. 臨床的帰結:「どんな条件で失敗するか」を問う
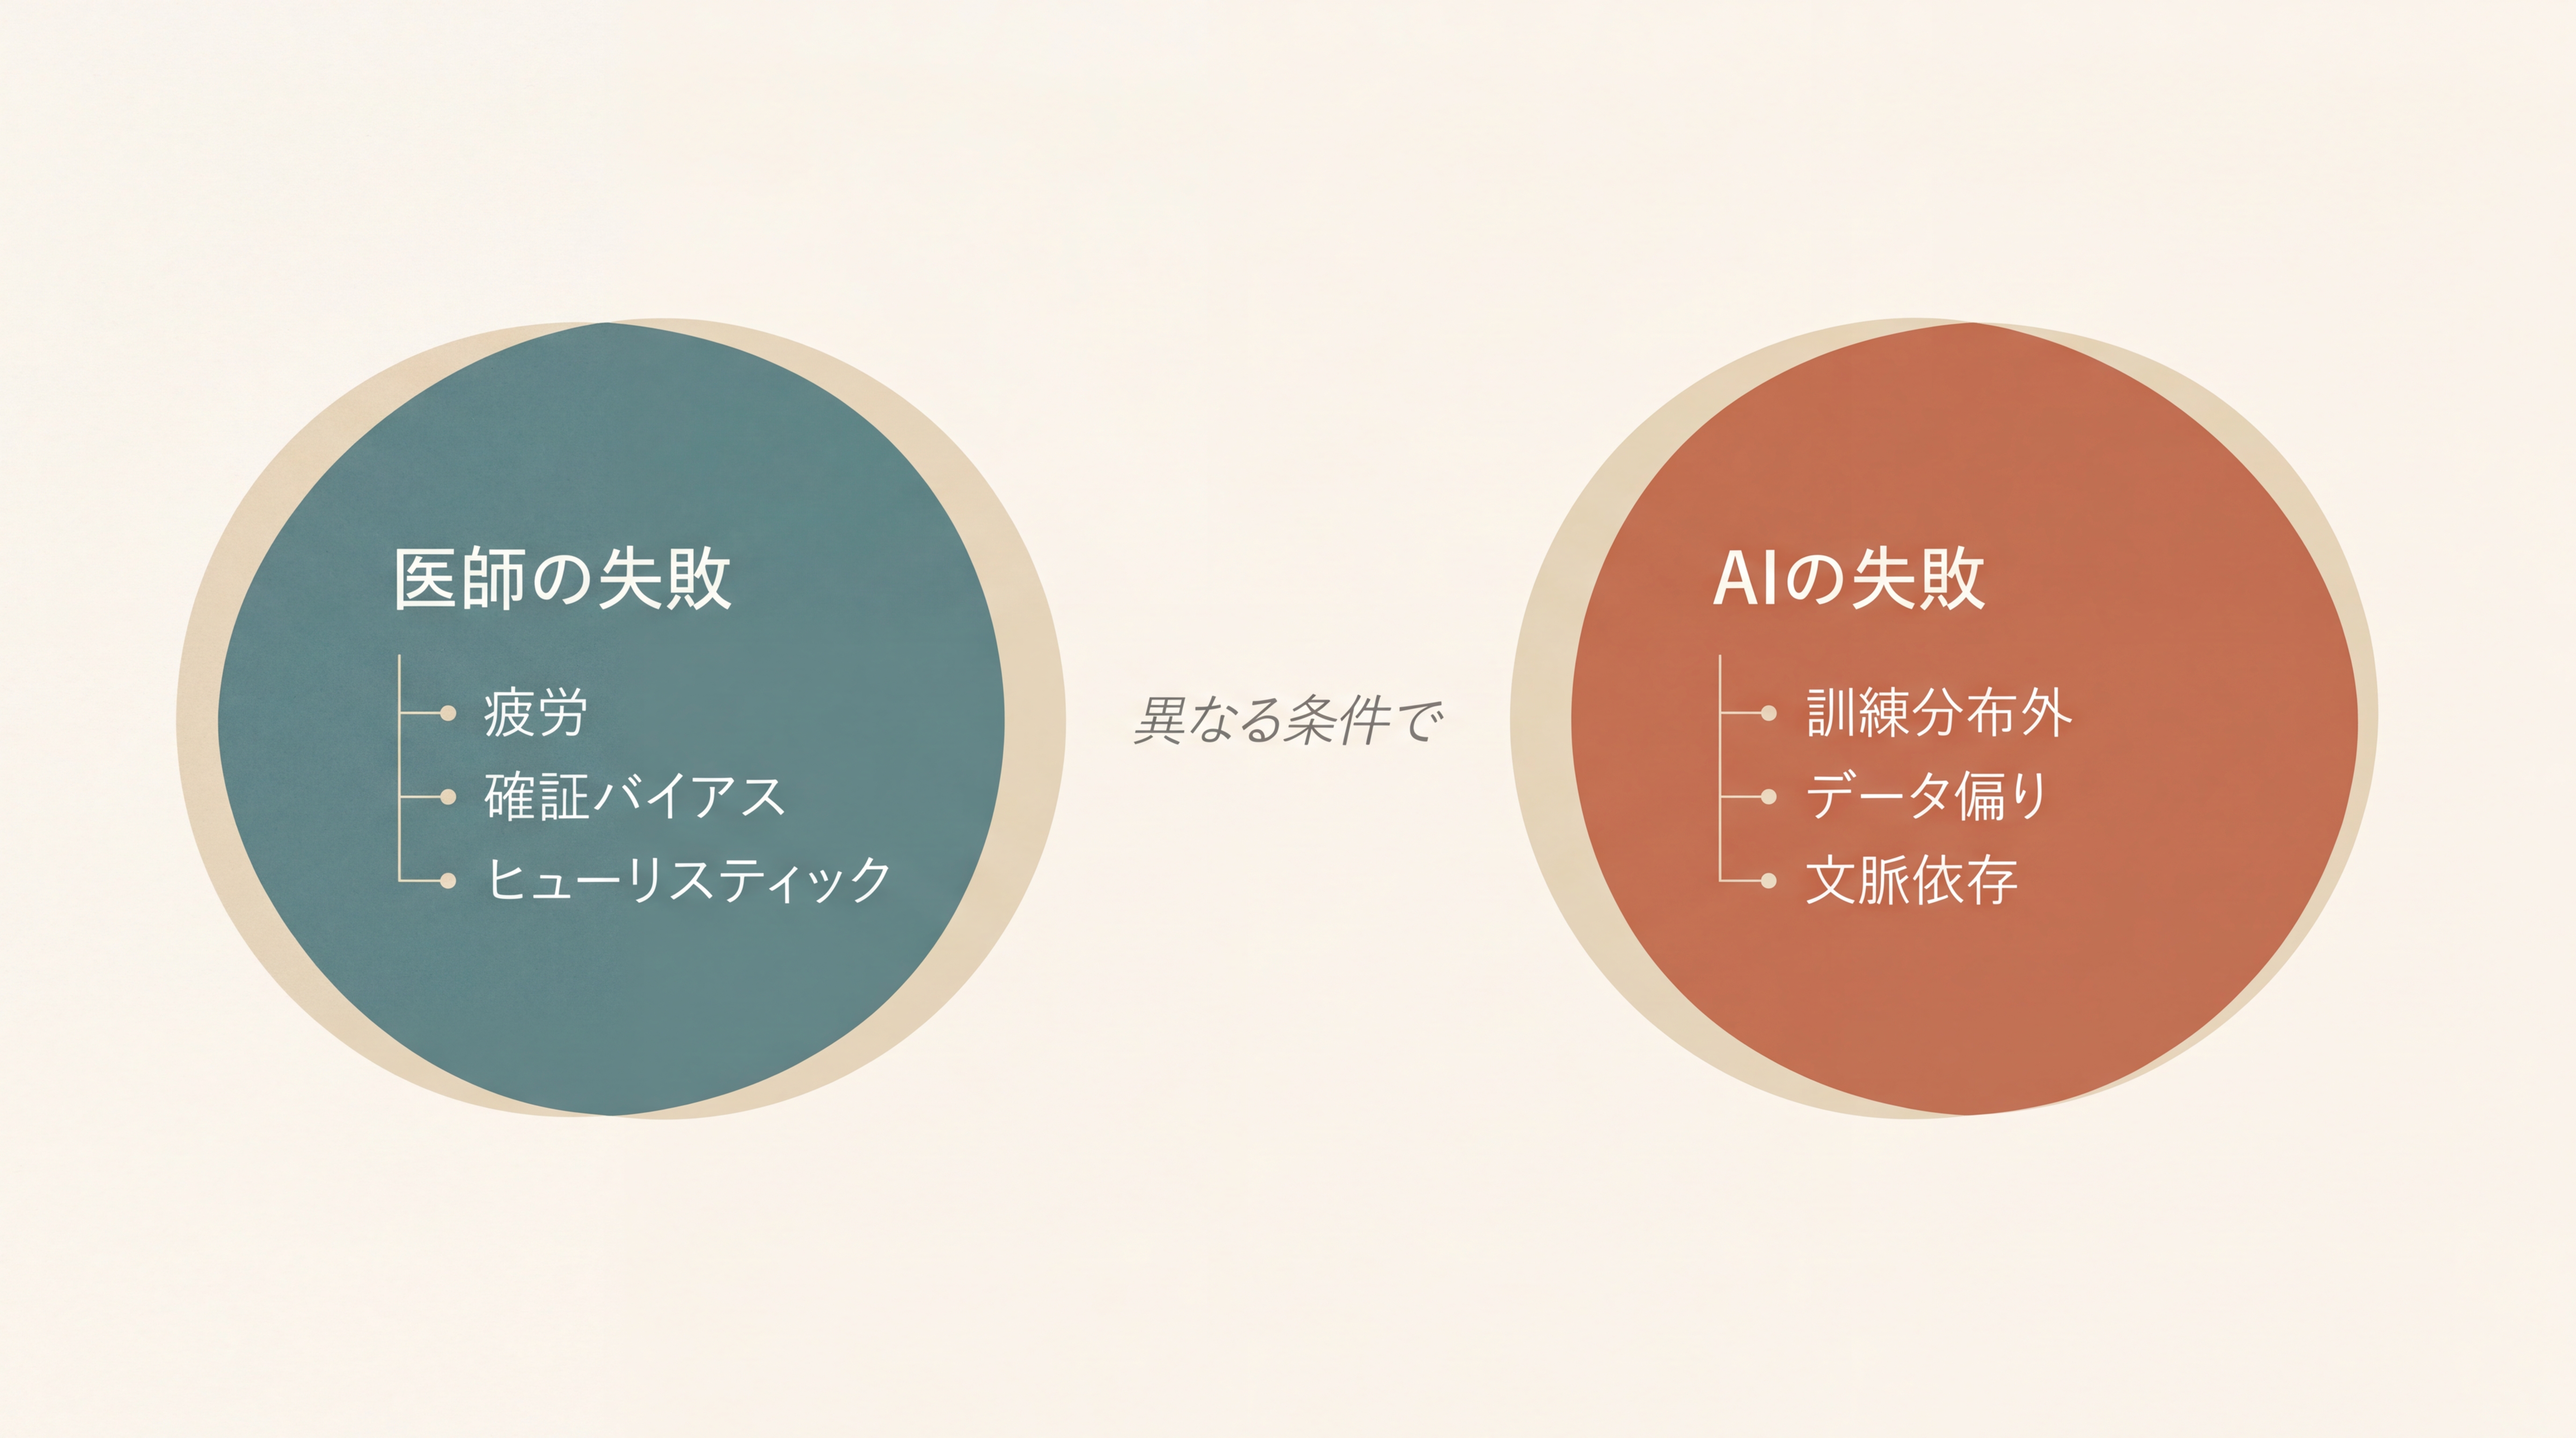
哲学的な問いから、臨床に戻ってこよう。
「AIは知能を持つか」「AIは理解しているか」という問いは、未解決のまま残る。私たち医療職にとって実務的な問いはむしろ、こちらだ。
このAIは、どんな条件で失敗するか?
AlphaFold2は新規タンパク質ファミリーで pLDDT が落ちる。診断支援AIは訓練データに含まれない稀少疾患で精度が落ちる。LLMは長文の論理依存で論点を取り違える。
これらの「失敗パターン」が見えていれば、AIに任せていい場面と人間が判断すべき場面が分かれる。
人間医師の失敗パターンとAIの失敗パターンは、異なる。人間は疲労や確証バイアスで失敗する。AIは分布外サンプルや訓練データの偏りで失敗する。
セルフチェック
1. チューリングテストに「合格」したAIは、知能を持っていると言えるか。
2. サールの「中国語の部屋」に対する「Systems reply(システム全体は理解している)」という反論の強みと弱みをそれぞれ1点ずつ挙げよ。
3. AlphaFold2はタンパク質を「理解して」予測しているのか、「パターン学習して」予測しているのか。その違いが臨床的に問題になる場面はどれか。
明日のアクション
次に生成AIを使う際、「形式的に整っている」と「内容的に正しい」を区別する習慣をつける。
具体的には、ChatGPT または Claude に小児ケースを1つ尋ねてみる。たとえば「生後3か月児の発熱への対応」「学童の喘息発作の初期対応」「5歳児のアセトアミノフェン推奨用量」など、自分の臨床に近い問いを選ぶ。
回答を読んだら、次の3点を確認する。
- 形式的な整合性:文章として整っているか
- 内容的な正確性:引用されているガイドライン名・推奨用量・年齢区分は実在し正確か(例: 体重別アセトアミノフェン10〜15mg/kgが反映されているか)
- 小児特異性:成人の数値が混入していないか、年齢区分が明示されているか
形式的に整った誤回答を1つ見つけて記録しておく。これは「AIが理解しているかどうか」より「AIがどんな条件で失敗するか」を自分の目で確認する実習だ。L06では、この問いをデータの構造から掘り下げる。
参考文献
- Turing, A.M. (1950). Computing Machinery and Intelligence. Mind, LIX(236), 433–460. DOI: 10.1093/mind/LIX.236.433
- Searle, J.R. (1980). Minds, brains, and programs. Behavioral and Brain Sciences, 3(3), 417–424. DOI: 10.1017/S0140525X00005756
- Jumper, J., Evans, R., Pritzel, A., et al. (2021). Highly accurate protein structure prediction with AlphaFold. Nature, 596(7873), 583–589. DOI: 10.1038/s41586-021-03819-2. PMID: 34265844
- Nobel Prize Committee. (2024, October 9). The Nobel Prize in Chemistry 2024. https://www.nobelprize.org/prizes/chemistry/2024/press-release/
- Templeton, A. et al. (2024). Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet. transformer-circuits.pub. https://transformer-circuits.pub/2024/scaling-monosemanticity/
- Bender, E.M. & Koller, A. (2020). Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data. ACL 2020, 5185–5198.
- Morris, M.R. et al. (2024). Levels of AGI for Operationalizing Progress on the Path to AGI. ICML 2024.
- Dennett, D.C. (1991). Consciousness Explained. Little, Brown and Company.