Geminiは画像を「見て」答えられる
画像をアップロードして、テキストと組み合わせて質問できる。これがマルチモーダル。
ChatGPTも画像対応してますが、Googleは医療画像AI研究に最も投資してるプレイヤー。Med-Gemini研究ではX線、病理、皮膚、眼、CT/MRIまで対応しています [1]。
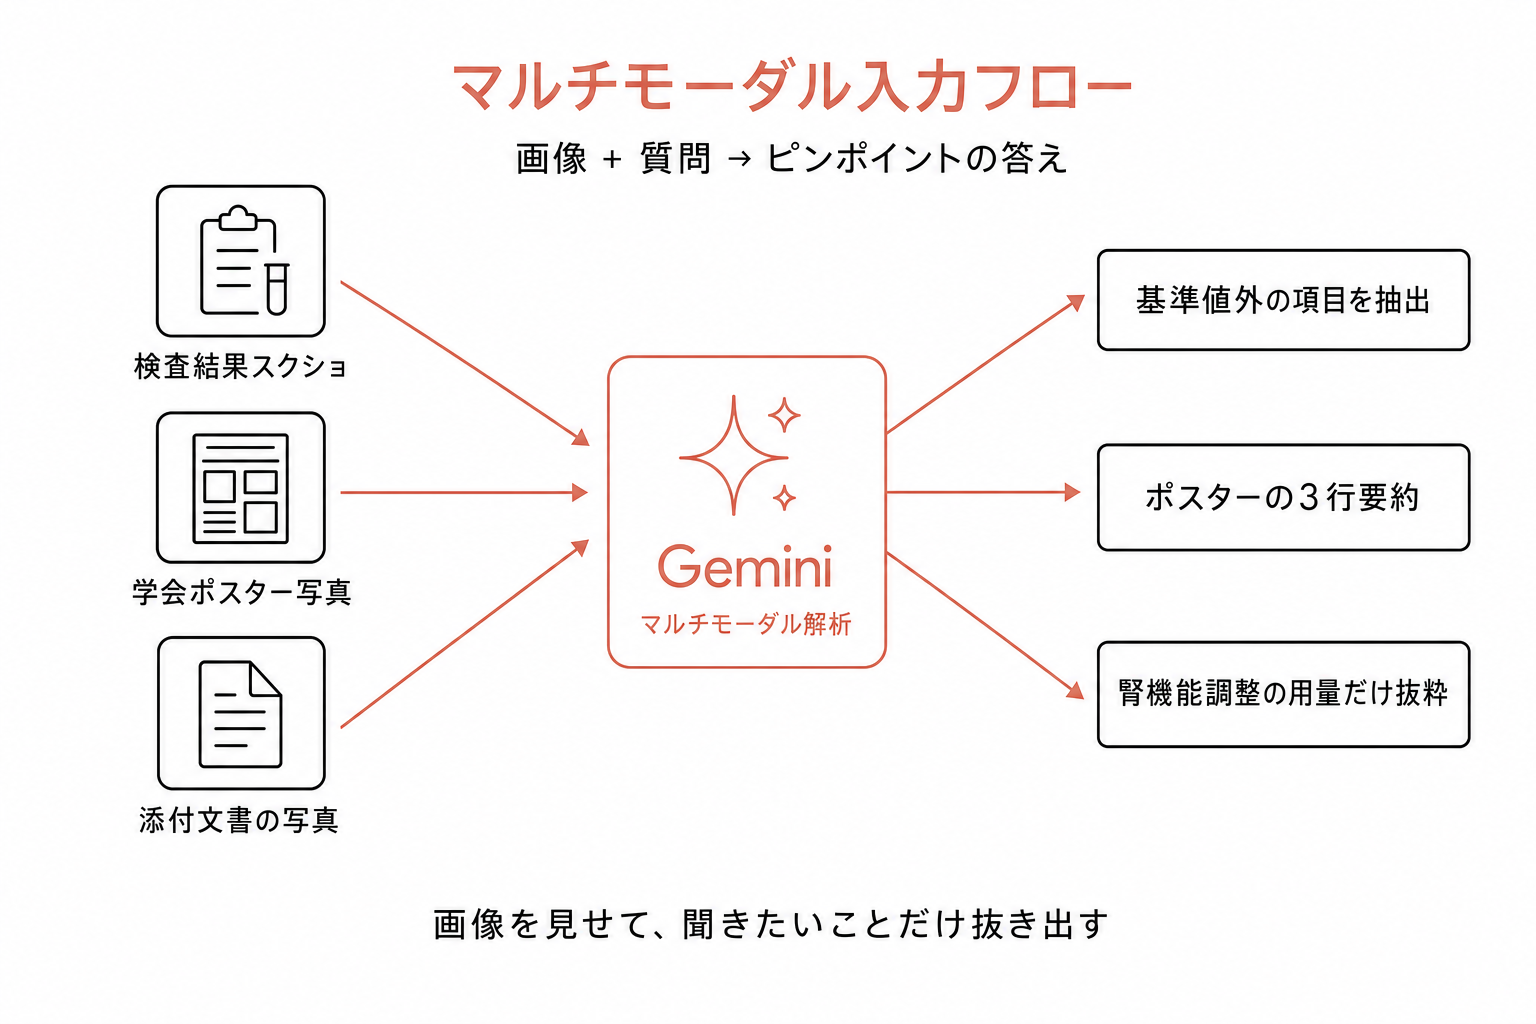
日常で使える3つの例
1. 検査結果のスクショを送る
手書きメモ・印刷された結果でもOK。写真撮ってアップすれば分析できる。
カルテシステムから取り出せない値を、スマホで撮って確認する使い方がリアル。
2. 学会ポスターを撮る
学会会場で気になるポスターを撮っておいて、後でまとめてGeminiに要約させる。
全部じっくり読む時間がない時に、先に要約を読んで深掘り対象を選ぶ使い方ができる。
3. 添付文書を撮る
添付文書を端から端まで読まなくていい。ピンポイントで欲しい情報だけ抜き出せる。
雑誌・紙資料のレイアウトもそのまま読める
Geminiは雑誌の特集ページや学会のプログラム冊子のような複雑なレイアウトにも強い。
日経トレンディ 2026年4月号 の比較企画では、紙面の旅行特集ページ(地図・行程・店舗情報がレイアウトされた誌面)をそのまま画像で渡して旅程プランを作らせたところ、ChatGPTが行程に矛盾を出した一方で、Geminiは正確に組み上げたと報告されています [3]。
医療現場でも、
- 学会抄録集のページ写真 → 関心セッションの抽出
- 院内マニュアルの紙資料 → デジタル要約に再構成
- 海外ガイドラインのフローチャート画像 → 日本語説明+判断ポイント
のように、「紙でしか手に入らない情報を構造化する入口」として効きます。
研究レベルで進んでること(参考)
一般版Geminiとは別ですが、Med-Gemini(研究版)で分かってること [1]:
胸部X線
- 正常症例の96%が放射線科医と同等以上のレポート
- 異常症例でも65%が同等以上
3D CT/MRI
- 3Dボリュームを直接解釈する初の大規模LLM
- 放射線科医が見落とした病変を検出した事例も報告
ゲノム(多遺伝子リスクスコア)
- 従来の線形モデルを8つのアウトカムで上回る
これらがMedGemmaとしてオープンソース化も始まってる [2]。臨床に降りてくるのは時間の問題。
注意
診断に直接使わない
一般ユーザーが使うGeminiは医療機器ではない。
画像を見せて質問はできるけど、その回答を診断の根拠にはしない。あくまで学習・参考目的。
医療機器として認証されたAIを臨床で使う流れが、これから本格化します。それまでは補助ツールとして。
Deep Research: もう一段進んだ機能
Google AI Pro(旧 Gemini Advanced)には Deep Research という機能があります。
複雑な質問に対して、自動で複数のウェブサイトを調査して、構造化レポートを作る機能。
2型糖尿病患者におけるGLP-1RAとSGLT2阻害薬の併用療法について、
2024-2025年に発表されたRCTを調査し、
心血管アウトカムと腎アウトカムに分けてまとめてください。
10分くらいかけて、ウェブを調べまくって、引用付きのレポートを返してくる。
NotebookLMとの違い
- NotebookLM: 自分の資料から答える
- Deep Research: ウェブ全体から調査してレポート
用途が違うので、併用するのが一番強い。知ってるソースはNotebookLM、新情報はDeep Research。
参考文献
- Saab K, et al. Med-Gemini. arXiv:2404.18416, 2405.03162. 2024.
- Google DeepMind. MedGemma. Hugging Face, 2025.
- 日経トレンディ. 「生成AI Gemini vs ChatGPT 7番勝負」特集. 2026年4月号.