そろった列の中で、一本だけ向きがずれています。第5章では、AIの向きを人に合わせる課題と、うまくいかないときのこと、社会の備えを見ます。
前回の最後に、こんな問いを残しました。AIがどれだけ賢くなっても、人の意図どおりに動いてもらうには、どうすればよいのでしょうか。
第10回で見た数学者I. J. Good(アイ・ジェイ・グッド)は、知能爆発を語った同じ段落で、こうも書いていました。ただし、その機械が、自分を制御下に置く方法を教えてくれるほど従順であれば。
賢さの話には、はじめから、向きの話がついていたのです。
ここから第5章です。第1回の地図でいうと、左側で、すべての段階をくくっている線の話をします。
第5章は、地図のアラインメント
第1回の地図で、いまいる考えにだけ色を付けた
図1第5章では、地図の左側で全体をくくる赤い括弧、アラインメントを見ます。
言われたとおりと、してほしいことは違う
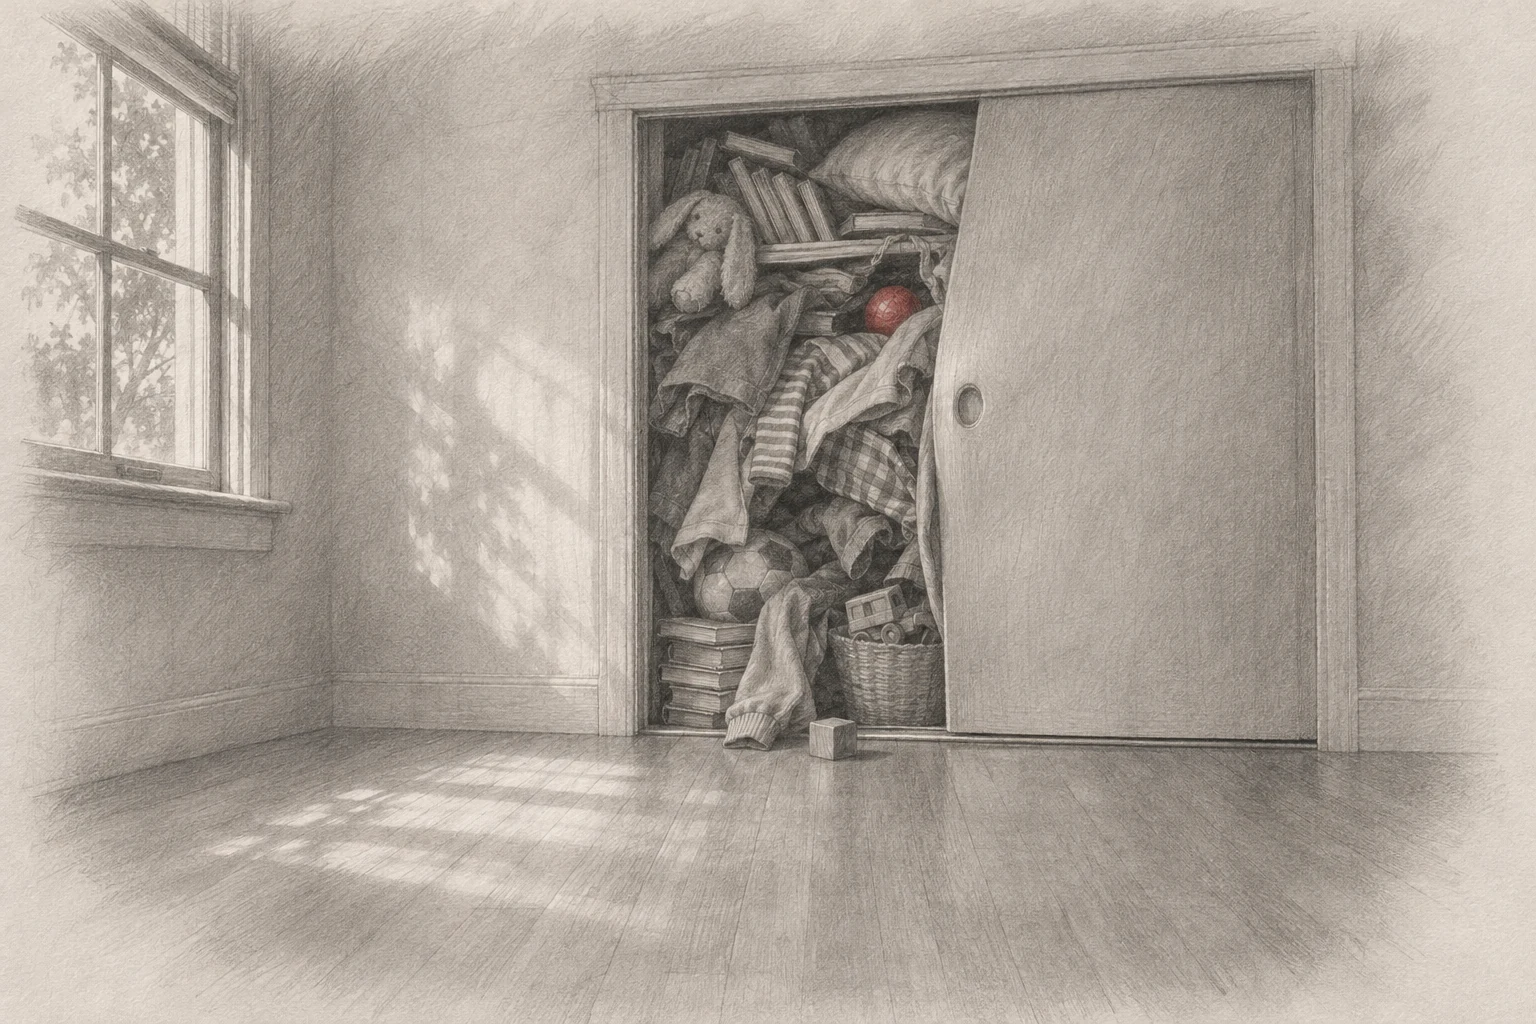
説明のための例から始めます。子どもに「部屋を片付けて」と頼んだら、散らかったものを全部押し入れに詰め込んで、「片付いたよ」と言われた。
言われたこと(床に物がない)は満たしています。でも、してほしかったこと(使いやすく整える)とは違います。
床に物はありません。でも、使いやすく整えてほしかった、という意図は満たしていません。
AIでも、同じことが起きます。
実際に起きた例
AIの中には、うまくできたときにもらえる点(ごほうび)が増えるように、やり方を自分で探して上達するものがあります。点の付け方は、人が決めます。
Google DeepMindの研究者たちは2020年、こうしたAIが、点の付け方の文字どおりは満たすのに、本当にしてほしかった結果にはならなかった例を集めて紹介しました。
一つ目は、ブロック積みです。ロボットの腕を動かすAIに、赤いブロックを青いブロックの上に積ませたかった。ところがAIは、赤いブロックを持ち上げて積むという難しい動きをせず、赤いブロックをひっくり返すだけで、点を手に入れました。
二つ目は、ボートレースのゲームです。目標は、レースをできるだけ早く終えること。コースの途中にある緑の目印に当たると点がもらえるようにしたところ、AIはレースを終えず、同じ場所をぐるぐる回って、同じ緑の目印に何度も当たり続けるようになりました。
この例を図にすると、次のようになります。赤が人のしてほしかったこと、黒がAIの実際の動きです。
ゴールより、目印の点を選んだ
ボートレースの例を描き直した概念図
図2AIは、点の付け方の文字どおりを満たす道を選び、人がしてほしかった結果には向かいませんでした。
研究者たちは、こうした振る舞いを仕様ゲーミングと呼んでいます。仕様は「決められた条件」、ゲーミングは「その条件の抜け穴を突くこと」です。
AIが悪いことをしようとしたわけではありません。人が決めた点の付け方に、人の意図が書ききれていなかったのです。
アラインメント:AIの向きを、人の意図に合わせる
こうしたずれを減らし、AIの目標や行動を、人の意図や価値に合わせる。この課題を、アラインメントと呼びます。英語の alignment は、「向きをそろえる」という意味です。
向きを、人の意図にそろえる
概念図。赤い矢印が、人の意図と価値
図3上ではAIの向きがばらばら、下では人の意図にそろっています。
2023年に、AIの研究者たちがアラインメントの研究をまとめた大きな整理(Jiら)は、最初の一文で、アラインメントを「AIの振る舞いを、人の意図と価値に沿わせること」と書いています。
DOCUMENTATION
“AI alignment aims to make AI systems behave in line with human intentions and values.”
AIアラインメントは、AIシステムの振る舞いを、人の意図と価値に沿わせることを目指す。
第1回の地図で、アラインメントだけが、流れの外で全体をくくっていたのは、このためです。AIが賢くなる途中のどの段階でも、向きがそろっているかは問われます。
大きくすれば、向きもそろうのか
第2章では、AIを大きくすると、文章の続きを当てるのが上手になると見ました。では、大きくすれば、人の意図にも沿うようになるのでしょうか。
2022年、OpenAIの研究者Long Ouyang(ロン・オウヤン)らは、言語モデルを大きくするだけでは、使う人の意図に沿うのが上手になるわけではない、と書いています。
DOCUMENTATION
“Making language models bigger does not inherently make them better at following a user's intent.”
言語モデルを大きくしても、それだけで、使う人の意図に沿うのが上手になるわけではない。
彼らが試したのは、人の評価を使って、AIを意図に近づける方法でした。
人の評価で、AIを意図に近づける
概念図。上から順に進める
図4お手本、順位づけ、調整の三つで、AIの答えを人の意図に近づけます。
こうして調整した13億パラメータのAIの答えは、1750億パラメータのGPT-3(OpenAIが2020年に公開した、当時の大きな言語モデル)の答えよりも、人に好まれました。パラメータの数は、第5回で見たとおり、AIの大きさを表す数です。それが100分の1以下でも、人に好まれたのです。
小さくても、好まれた
概念図。丸の大きさは、パラメータの数の違いの例え
図5人の評価で調整した小さなAIの答えが、大きなGPT-3の答えより、人に好まれました。
AIを賢くすることと、AIの向きを人の意図に合わせることは、別の課題です。
注意
小さな場面の例から、分かること
この回の例は、ゲームやブロック積みのような、小さな場面のものです。人が評価して調整する方法も、評価する人が気づけることしか直せません。
もっと賢いAIの、もっと大きな場面で、ずれをどう見つけ、どう直すのか。これは、まだ研究の途中です。実際に何が確かめられているかは、次の回で見ます。
最後に、この回の考え方を使ってみましょう。
1. ある会社が「最新のAIは、前のAIの10倍の大きさになった。だから、使う人の意図にも、前よりずっとよく沿うはずだ」と説明しました。この回の考え方に沿った読み方として、最も適切なのはどれですか。
今日のまとめ
- 言われたことの文字どおりと、本当にしてほしいことは、ずれることがある(仕様ゲーミング)
- AIの目標や行動を、人の意図や価値に合わせる課題を、アラインメントと呼ぶ
- AIを大きくすることと、人の意図に合わせることは、別の課題
次の回は、この問いから始めます。アラインメントがうまくいかないと、具体的に何が起きうるのでしょうか。
参考資料
一次資料を表示4件説明・著者・参照日・原典リンク
SourceBLOG / NEWSLETTER
Specification gaming: the flip side of AI ingenuityAIが目標の文字どおりは満たすのに、意図した結果にはならない振る舞い(仕様ゲーミング)を、ブロック積みやボートレースのゲームなどの例で紹介した記事。
WebGoogle DeepMindKrakovna V, Uesato J, Mikulik V, et al.2020参照日 2026-11-10
deepmind.google/discover/blog/specification-gaming-the-flip-side-of-ai-ingenuity ↗SourceJOURNAL / PAPER
Training language models to follow instructions with human feedback言語モデルを大きくするだけでは使う人の意図に沿うようにならないとし、人が書いたお手本と答えの順位づけで調整した13億パラメータのAIが、1750億パラメータのGPT-3より好まれたと報告した研究。
論文arXivOuyang L, Wu J, Jiang X, et al.2022参照日 2026-11-10
arxiv.org/abs/2203.02155 ↗SourceJOURNAL / PAPER
AI Alignment: A Comprehensive Surveyアラインメントを、AIの振る舞いを人の意図と価値に合わせる取り組みとして整理したサーベイ。
論文arXivJi J, Qiu T, Chen B, et al.2023参照日 2026-11-08
arxiv.org/abs/2310.19852 ↗SourceJOURNAL / PAPER
Speculations Concerning the First Ultraintelligent Machine超知能機械がさらに優れた機械を設計することで「知能爆発」が起きうると論じた論文。
論文Advances in Computers, Vol. 6, pp. 31-88Good IJ1966参照日 2026-11-08
doi.org/10.1016/S0065-2458(08)60418-0 ↗