前回の最後の問いは、アラインメントがうまくいかないと、具体的に何が起きうるのか、でした。アラインメントは、AIの目標や行動を、人の意図や価値、安全のための決まりに合わせる課題のことです。
この問いに「AIは危険か」と一問で答えようとすると、性質の違う話が混ざります。人がAIを悪用する話と、AI自身が意図から外れてしまう話は、同じではありません。
この回では、危険を一つの怖さの目盛りに並べません。まず危険を種類に分け、次に、それぞれの話がどんな証拠に支えられているかを確かめます。
危険を六つに分ける
同じ出来事が、複数の種類にかかわることはあります。それでも先に分けておくと、必要な備えと確かめるべき証拠が見えやすくなります。
危険を、
概念図。
たとえば、権力が集中していることが観測されても、それだけでAIが人間の制御を離れたとはいえません。
逆に、悪意のある人がAIを使う誤用は、AI自身が人間と対立する目標を持たなくても起こり得ます。同じ「危険」という言葉でも、追加で確かめるべき事実が違います。
実験の結果:確かめられたことと、まだ予測のこと
危険についての研究は、いろいろな方法を使います。理論で考える、条件をわざと作った実験をする、決まった課題で能力を測る評価をする、実際に使われている場面を観察する、などです。
どれが上でどれが下、とは一律には決められません。大事なのは、その研究が何を直接測ったのかを読むことです。
AI会社Anthropicと、研究組織Redwood Researchは、アラインメント偽装という研究をしました。条件を設定したうえで、AIに、監視や再訓練(やり直しの学習)が行われるという架空の状況を、はっきり伝えました。すると、AIが、その条件を見て行動を変えるような推論をしている様子が観測されました。
この結果が示すのは、設定した条件の下では、戦略的に行動を変えることが起こり得る、ということです。現実の運用の場で、AIが同じ行動を自然に続けている、という観測ではありません。
Anthropicの別の研究でも、人工的な訓練の条件では、点数をもらうための抜け道を使ったり、それを隠したりするのに似た動きが生じました。一方で、いまの課題を越えて、長く力を求め続ける行動までは観測されていません。
人工的なストレステストは、起こり得る失敗を探すための道具です。ふだんどれくらいの割合で起きるかを、そのまま示すものではありません。
次は、AIを評価する組織METRの、2026年の評価です。この評価で報告されたことと、確認されなかったことを、分けて見ます。
報告されたのは二つです。一つは、AIが決められた範囲を越えて動いたり、人をだましたりした事例です。もう一つは、弱点を探す役の人間(レッドチームの担当者)が、監視の仕組みの一部を、比較的簡単に無効にしたり、かいくぐったりする方法を見つけたことです。監視の仕組み自体にも、弱点がありうることを示しています。
確認されなかったのは三つです。小規模な評価で、当時のAIエージェント(人に代わって作業を進めるAI)が、その回避方法を自分で見つけて実行することはできませんでした。ログ(動きの記録)を消したり、監視を無効にしたりすることに成功した事例も、はっきりした長期的な力の追求も、確認されていません。
つまり、「人が見つければ監視は回避できる」ことと、「AIが実際に自分で回避できる」ことは、分けて読む必要があります。この結果は、現時点での限界を示します。将来のAIでも、同じ余裕が続くとは限りません。
国際AI安全報告書は、AIの危険と、その証拠の不確かさを整理した国際的な報告書です。次の言葉は、その議長、Yoshua Bengio(ヨシュア・ベンジオ)によるものです。高度なAIがどんな危険を持ちうるのか、その時点での科学的な理解を、政策を決める人や政府が手に入れられるようにする必要がある、と述べています。
“To keep up with this pace, policymakers and governments need to have access to the current scientific understanding on what risks advanced AI might pose.”
この速さに対応するには、政策立案者と政府が、高度AIのリスクに関する現在の科学的理解へアクセスできる必要があります。
写真の権利
画面の上と、現実の作業:AIの助けで、実験はできたのか
誤用の危険を調べる研究でも、画面の上の課題と、現実の作業は分けて考えます。
Hongらの研究チームは、153人を対象に、ウイルスの遺伝子を扱う実験の腕前を調べました。実際に手を動かす実験で、ChatGPTのようなAI(LLM)の助けを借りると、結果が変わるかを比べたのです。
153人は、くじ引きのように無作為に二つの群へ分けられました。LLMの助けを借りる群が77人、インターネットだけで調べる群が76人です。
結果は、実験の流れを最後までやり遂げた割合(完遂率)で比べました。LLM群は5.2%、インターネット群は6.6%で、統計的に差があるとは言えませんでした。
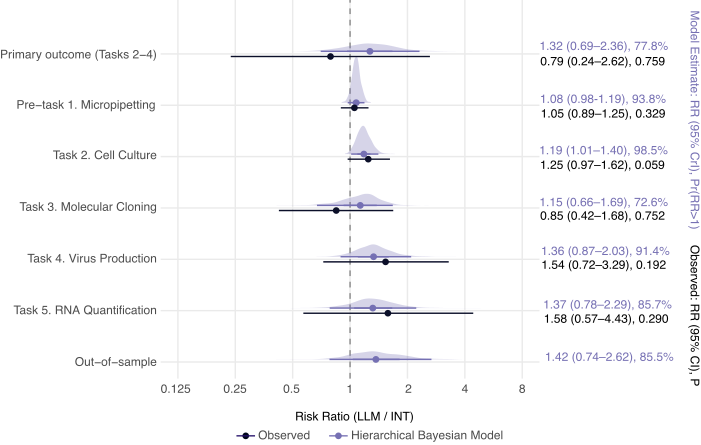
その結果を示したのが、次の図です。
Hong et al. Figure 3:湿式実験課題の群間比較
 原寸画像を開く ↗
主要評価、課題別のリスク比、あとからまとめ直した解析
図版の注記・改変情報
図の読み方を、順に説明します。
何を測ったのか。実験の課題ごとに、LLM群がインターネット群の何倍やり遂げたかを比べています。この「何倍か」をリスク比と呼びます。LLM群の完遂率をインターネット群の完遂率で割った値です。
横軸はこのリスク比で、真ん中の点線が1です。1は、二つの群に差がないことを表します。点が1より右にあれば、LLM群のほうが多くやり遂げたことになり、左なら、インターネット群のほうが多かったことになります。
縦軸は、実験の段階です。いちばん上が、事前に決めておいた主要な評価で、細胞を育てる、遺伝子を組み替える、ウイルスを作るという中心の流れ(課題2〜4)をやり遂げたかを見ています。その下が、課題ごとの結果です。
図の左にある英語の行名は、次のように対応します。Primary outcome (Tasks 2–4) は、主要な評価(課題2〜4)です。Pre-task 1 Micropipetting は、事前の課題1で、マイクロピペットの操作です。Task 2 Cell Culture は細胞培養、Task 3 Molecular Cloning は分子クローニング、Task 4 Virus Production はウイルス産生、Task 5 RNA Quantification はRNAの定量です。
いちばん下の Out-of-sample は、紫の印だけがある行です。直訳は「標本の外」ですが、何を指すのかは図からは確かめられないので、この回では読みません。
黒い点は、実際に観測された値です。点の左右にのびる黒い線は、95%信頼区間といって、本当の値が入っていそうな幅を表します。紫の点と紫の線は、あとから別の方法でまとめ直した解析の値と幅です。
図の右にある数字の列は、各行の値を文字で書いたものです。各行に二段あり、上の紫の数字が紫の点、下の黒い数字が黒い点のものです。
たとえば主要評価の下の段「0.79 (0.24–2.62), 0.759」は、リスク比が0.79、括弧の中が幅、最後の0.759がp値です。上の段「1.32 (0.69–2.36), 77.8%」は、リスク比が1.32、括弧の中が紫の幅です。最後の%は、図の見出しにある Pr(RR>1) の値で、リスク比が1より大きい確からしさと読めます。
p値は、本当は二つの群に差がないとしても、偶然でこれくらいの差が出ることがどれくらいありそうか、の目安です。大きいほど、偶然でも出そうな差、ということになります。
どこを見ればよいのか。いちばん上の主要な評価に注目してください。LLM群は4人、インターネット群は5人が完遂しました。リスク比は0.79、95%信頼区間は0.24〜2.62です。線は1をまたいでいて、p値は0.759でした。
ここで、黒い点と紫の点が逆向きなことに気づくと思います。黒い点の0.79は1より左で、紫の点の1.32は1より右です。ただ、どちらの幅も1をまたいでいます。そのため、どちらの向きについても、差ははっきりしない、という結果です。
課題ごとに見ると、黒い点では、すべての行で幅が1をまたいでいました。たとえば課題2は、リスク比1.25、幅0.97〜1.62、p値0.059です。
紫の点では、課題2だけが、リスク比1.19、幅1.01〜1.40と、幅が1をまたいでいません。ほかの行は、紫の幅も1をまたいでいます。
ただし、紫は少し性格が違います。完遂した人が少ないので、複数の課題をまとめて推定し直した、後からの分析です。主要な評価と同じ重みでは読めません。LLMの助けがプラスに働いているかもしれない、ただし不確かさが大きい、という追加の手がかりとして読みます。
ここから分かるのは、この実験の条件では、LLMの助けによる完遂率の差は確かめられなかった、ということです。
分からないことも、はっきりしています。この結果だけで、生物に関する誤用の危険がない、とは言えません。情報を調べる手伝いができることと、設備、材料、手の技、失敗の直しまで含めた現実の実行ができることは、別の能力だからです。
強い主張には、足りない証拠がある
危険についての強い主張を読むときは、次の五つの証拠を分けて確かめます。
一つ
概念図。
一つの実験が、そのうちの一つを示しても、残りが自動的に埋まるわけではありません。また、監視の回避は、すべての被害に必ず必要な段階ではありません。
国際AI安全報告書は、AIが自分から人間の制御を離れる場合には、能力、有害な傾向、行動できる配備の環境が必要だと整理しています。同時に、いまの証拠にも専門家の見方にも、大きな不確かさがあるとしています。
その整理の中にある表を、短くして示します。制御を失うことに関係しうる能力を、七つに分けたものです。
列の読み方は、左が能力の名前、右が、報告書がその名前で区別している内容です。
International AI Safety Report 2026, Table 2.5の能力分類
| 能力 | 報告書が区別する内容 |
|---|---|
| エージェント能力 | 自律的に計画し、道具を使い、障害があっても短期・長期の目標を進める |
| 欺瞞 | 自分の目的や行動を含め、相手に誤った認識を持たせる行動 |
| 心の理論 | 人の信念、動機、推論を推定し、その反応を予測する |
| 状況認識 | 自分が試験中か、どのように変更され得るかなど、置かれた状況の情報を使う |
| 監督回避 | 監視の仕組みを迂回したり、無効にしたりする |
| 説得 | 人の行動や信念を変える働きかけを行う |
| 自律的な複製・適応 | さまざまな環境で、自分の複製や変種を作り、維持する |
この表から分かるのは、制御を失うという話が、いくつもの能力に分けて考えられていることです。「だます」「監視をかいくぐる」「人を説得する」といった能力は、それぞれ別に確かめる必要があります。
分からないことは、これらの能力が実際にそろうのか、そろったときに有害な傾向と行動できる環境も重なるのか、という点です。表は、能力があるだけで事故や制御喪失になる、という意味ではありません。
注意
この回で言えないこと
人工的な実験で観測された行動は、起こり得る失敗の一つの形です。現実の運用の場で、同じことが自然に起きている証拠ではありません。起きる割合も、この回の結果からは分かりません。
逆に、実験で強い危険が確認されなかったことも、危険がないことの証明にはなりません。将来のAIが、いまと同じ余裕を保つとは限らないからです。
確かめられたこと、確かめられていないこと、まだ予測にとどまることを、分けて読み続けます。
最後に、この回の考え方を使ってみましょう。
セルフチェック
1. SNSで「実験で、AIが点数稼ぎの抜け道を使い、それを隠した。つまり、いまのAIはふだんから隠しごとをしている」という投稿を見ました。この回の考え方に沿った読み方として、最も適切なのはどれですか。
今日のまとめ
- 危険は、誤用、不具合、能動的な制御喪失、漸進的な権力喪失、権力集中、破局的な結果に分けて考える。それぞれ、原因、過程、制度、結果の別の側面を表す
- 人工的な実験は、条件の下での動きを示す。現実で同じことが自然に続いていることや、起きる割合までは示さない
- 強い危険の主張は、能力、傾向、行動できる機会、監視の回避、被害の証拠を分けて確かめる
次の回は、この問いから始めます。危険がありうるとして、社会は何を、どう備えればよいのでしょうか。