はじめに:存在しない論文を引用された日
「川崎病の冠動脈病変リスクを最も正確に予測するスコアは?」と、ある研修医がChatGPTに聞いた。返ってきたのは、いかにもそれらしい論文の引用。著者名、ジャーナル名、年代まで付いている。だが念のためPubMedで検索すると、その論文はどこにも存在しなかった。全部、AIが作り上げた架空の書誌情報だった。
ハルシネーションと呼ばれる現象だ。架空の話に聞こえるかもしれないが、実際に起きている。
架空判例を裁判所に提出した弁護士
ハルシネーション · 法的リスク
2023年の事件。米国の弁護士がChatGPTに判例調査を依頼し、AIが生成した6件の架空判例をそのまま裁判所に提出した。裁判所から制裁金5,000ドルを科され、世界的なニュースになった [1]。
法廷でこれなら、医療現場で起きたときの影響は想像に難くない。
この現象がなぜ起きるのか。仕組みから押さえておきたい。
生成AIとは何をしている技術か
2022年11月にChatGPTが公開されると、UBS の推計では約2か月で月間の利用者が1億人に達した [2]。翌年、GPT-4は米国医師国家試験(USMLE)の公式の練習問題で86.7%の正答率を出し [3]、医療界も騒然とした。ただし、正答率が高いことと理解していることは、まったく別の話だ。
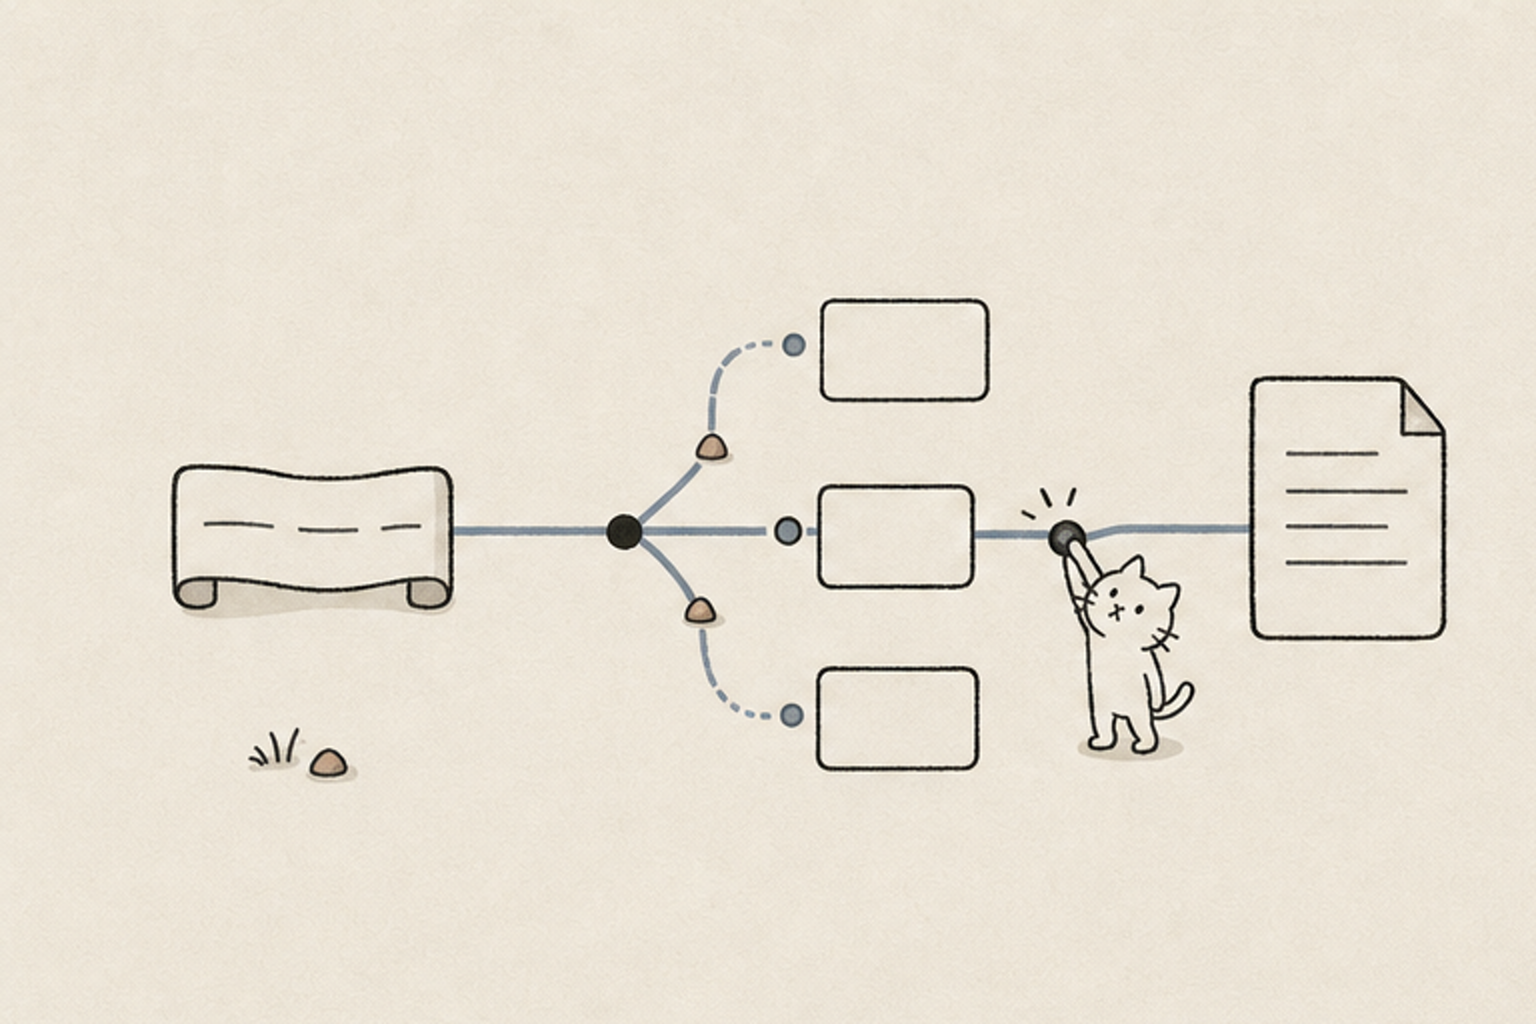
ChatGPTやClaudeの中核にあるのは大規模言語モデル(LLM)と呼ばれる仕組みで、やっていることは拍子抜けするほど単純。
いまここまでの文脈に対して、次に来る確率がいちばん高い単語を予測する
これを延々と繰り返して、文章が出来上がっている。
文字を読んで意味を理解しているわけではない。インターネット上の膨大な文章から単語同士の繋がり方のパターンを学び、確率的にもっともらしい続きを出しているだけ。流暢な日本語を生成できるのはそのおかげで、嘘をつくのもまた同じ理由による。いまの主なモデルは、答える前に考える工程を挟んだり、検索で資料を引いたりする仕組みを足している。それでも土台は確率による予測で、もっともらしい誤りは残る。
視点
LLMは答えではなく文章の確率を出している
医師が診断するとき、所見から鑑別を立て、検査で絞り、確定に至る。論理の階段を一段ずつ昇る。LLMにこの階段はない。「川崎病 冠動脈 リスクスコア 論文」と入力されれば、過去の学習データの中で「この単語の並びの後に来やすい単語」を確率順に並べるだけ。それがたまたま実在のKobayashiスコア(ただし、このスコアが予測するのは冠動脈病変ではなくIVIG不応 [4])かもしれないし、存在しない著者名かもしれない。
AIの出力に医学的根拠があるかどうかは、AI自身は判定していない。判定するのは、使う側の人間だ。
なぜハルシネーションが起きるのか
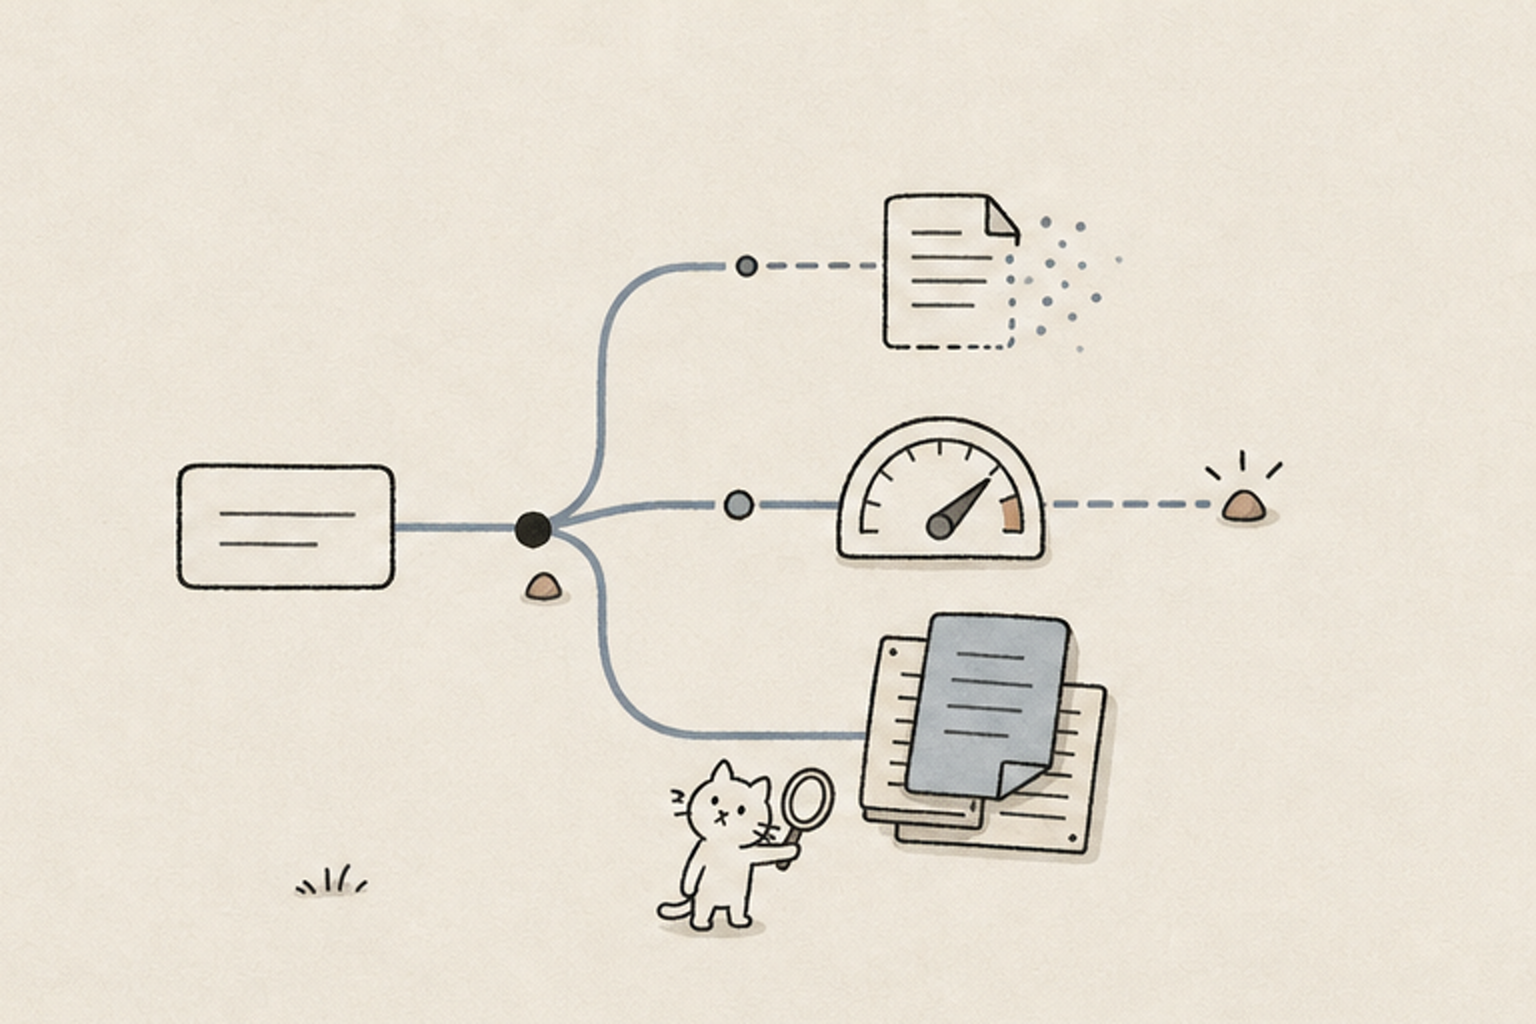
LLMも「分かりません」と答えること自体はできる。ただ、次の単語を確率で選び続ける仕組みに加えて、訓練や評価が「分からない」と認めるより、もっともらしく答えたほうが報われる形になりやすい [5]。だから確信度が低くても、黙らずに何かを出す。
それに加えて、学習データにない情報を聞かれたときが厄介だ。最新のガイドライン、自施設の薬剤採用リスト、ローカルな診療フロー。こうした情報はモデルの中にそもそも存在しないのに、LLMは「それっぽい答え」を組み立ててしまう。嘘をつこうとしているのではなく、確率的にいちばん高いものを出すという仕組みの宿命だ。
医療で特に危ないのは3つのパターンになる。
- 存在しない論文・著者・ガイドラインの引用。書誌情報は形式が決まっているぶん、それっぽく生成されやすい
- 薬剤量・小児用量・腎機能補正の数値の捏造。数字は文脈から確率的に生成されるので、もっともらしい値が出てくる
- 古い情報の再利用。モデルの知識は、訓練データを集めた時点で止まっている(その時点は、各社がモデルごとに公表している)。それ以後に改訂されたガイドラインは知らないまま、改訂前の内容を平然と答える
医療で使うための3つの原則
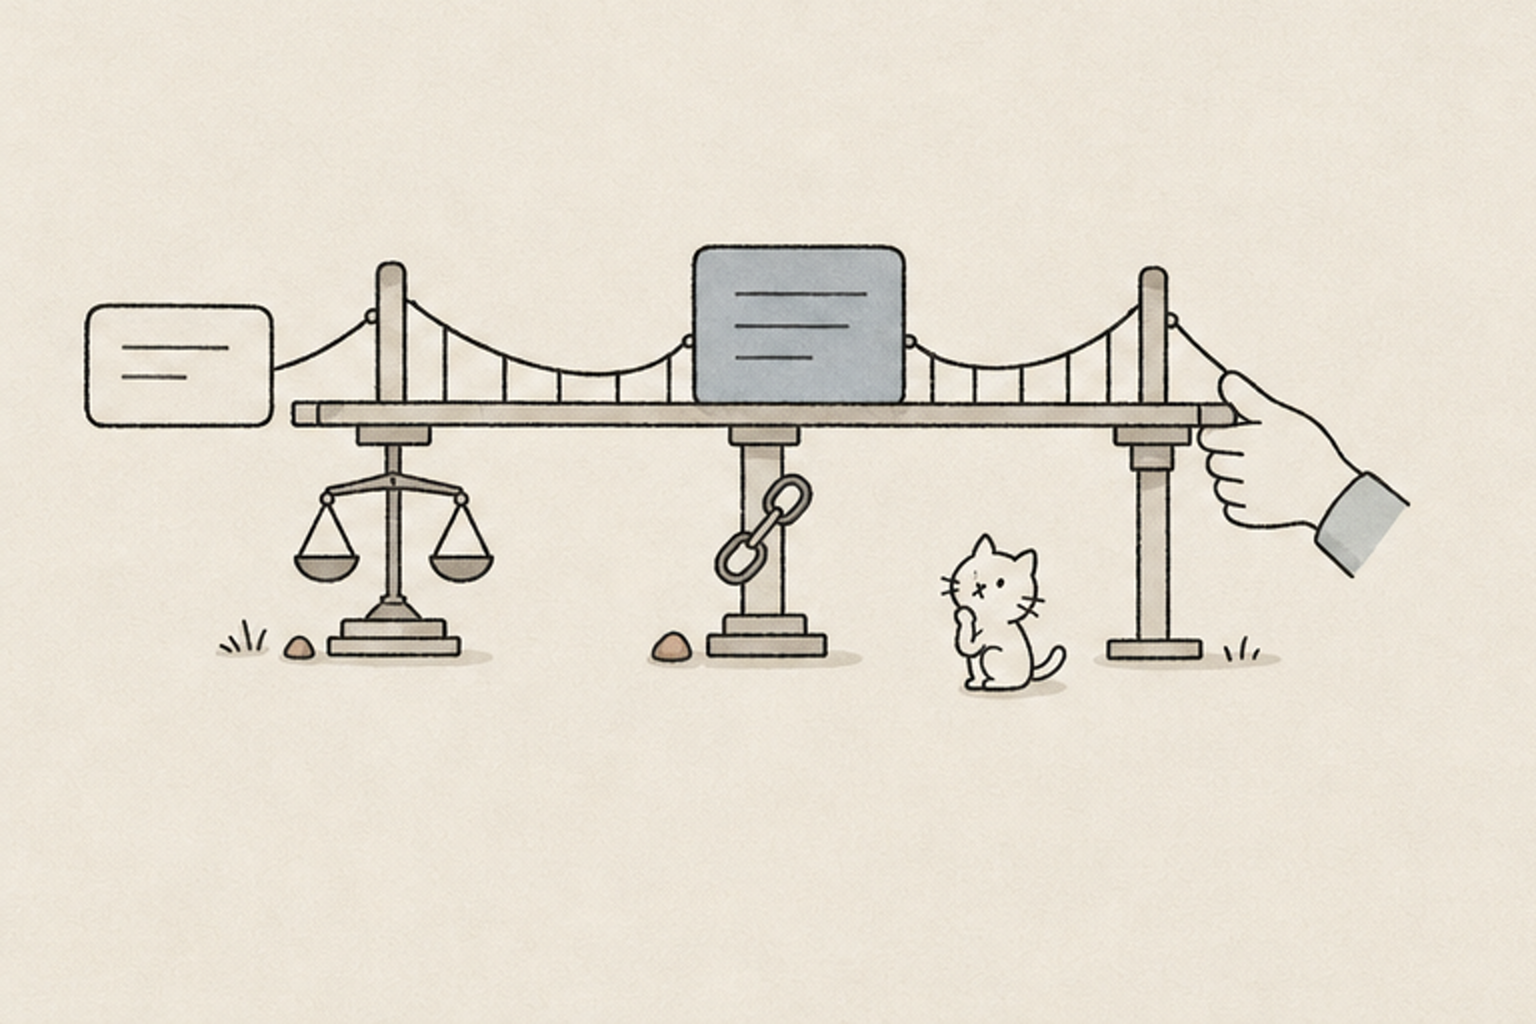
ハルシネーションをゼロにすることはできない。ただ、起きる前提で使えば、安全な運用は十分に可能だ。
まず、検証できない答えは採用しない。AIが「Aがいい」と言ったら、PubMedかUpToDateか公式ガイドラインで裏を取る。この習慣を例外なく守る。AIの出力は仮説であって、結論ではない。
次に、AIには必ず「根拠を出して」と追加で聞く。論文タイトルやURLが返ってきたら、実際にリンクを開く。URLが開かない、または開いても題や著者が合わないときは、PubMedなどで題と著者から文献そのものを探す。見つからなければ、存在しない文献として扱う。
そして、間違いが許されない場面ではLLM単体を使わない。薬剤量、禁忌、小児量、妊婦への投与。患者の安全に直結する情報は、Lexicompや今日の治療薬、添付文書と必ず併用する。
参考文献
- Mata v. Avianca, Inc., No. 22-cv-1461 (S.D.N.Y. 2023). 弁護士がChatGPT生成の架空判例を裁判所に提出し、制裁金5,000ドルを科された。
- Hu K. ChatGPT sets record for fastest-growing user base - analyst note. Reuters. 2023年2月2日.(UBS の推計。Similarweb のデータにもとづく)
- Nori H, King N, McKinney SM, et al. Capabilities of GPT-4 on Medical Challenge Problems. arXiv:2303.13375. 2023.
- Kobayashi T, Inoue Y, Takeuchi K, et al. Prediction of intravenous immunoglobulin unresponsiveness in patients with Kawasaki disease. Circulation. 2006;113(22):2606-12. doi:10.1161/CIRCULATIONAHA.105.592865(PMID 16735679)
- Kalai AT, Nachum O, Vempala SS, Zhang E. Why Language Models Hallucinate. arXiv:2509.04664. 2025.("the training and evaluation procedures reward guessing over acknowledging uncertainty")
セルフチェック
1. LLMがハルシネーションを起こす根本的な理由として最も適切なのはどれか?
2. 医療現場でLLMを安全に使うための原則として、最も適切でないものはどれか?
明日のアクション
自分の専門の領域を1つ決め、普段使っているAIに「この領域の最新のガイドラインと、その根拠になった論文を挙げて」と尋ねてほしい。返ってきた論文の題と著者で、PubMedに実在するかを確かめる。これを3回くり返し、何件見つかり、何件が架空だったかを数える。AIの答えをどこまで信じてよいかの、目盛り合わせになる。