「AIは危険か」と一問で尋ねると、性質の違う話が混ざります。人が悪用する話と、システムが意図から外れる話は同じではありません。人間が統治する力を徐々に失う話と、大規模な被害が起きる話も別です。
このレッスンでは危険を一つの恐怖尺度に並べません。何が原因で、どんな過程を通り、どの規模の結果に至るのかを分けます。さらに、その主張を支える証拠の種類も確かめます。
六つの危険を分ける
同じ出来事が複数の分類に関係することはあります。それでも先に分けておくと、議論に必要な対策と証拠が見えやすくなります。
- 誤用
- 人が害を与える目的でAIを使う。
- 不具合・ミスアラインメント
- 誤答や副作用など、意図した挙動から外れる。
- 能動的な制御喪失
- AIの行動により、人が修正・停止することが極めて難しくなる。
- 漸進的な権力喪失
- 依存や競争の中で、人の判断権・影響力が弱まる。
- 権力集中
- 資源・情報・意思決定権が少数に偏る。
- 破局的な結果
- 原因の名前ではなく、被害の深刻さを表す。
講座独自の整理。同じ出来事が複数に当てはまり、「危険の強さ」の順ではない。
誤用と不具合は主に原因を説明します。二つの制御・権力喪失と権力集中は、被害へ向かう過程や制度の説明です。破局的な結果が表すのは被害の深刻さです。
たとえば権力集中が観測されても、それだけでAIが人間の制御を離れたとはいえません。逆に、悪意のある人がAIを使う誤用は、AI自身が人間と対立する目標を持たなくても起こり得ます。同じ「危険」という言葉でも、追加で確かめるべき事実が違います。
実験結果が示す範囲
危険についての研究は理論、構成された実験、管理された評価、実運用の観測などを使います。証拠の優劣を一律には決めません。その証拠が何を直接測ったかを読みます。
AnthropicとRedwood Researchのアラインメント偽装研究では、監視や再訓練についての架空の条件をモデルへ明示し、条件によって行動を変える推論が観測されました。これは、設定した条件の下で戦略的な行動変更が起こり得るという実験結果です。現実の配備でモデルが同じ行動を自然に続けているという観測ではありません。
Anthropicの報酬改変研究や報酬追求モデルの実験でも、人工的な訓練条件では報酬の抜け道や隠蔽に似た挙動が生じました。一方で、現在の課題を越えて長期的に権力を求め続ける行動まで観測されたわけではありません。人工的なストレステストは起こり得る失敗を探す道具であり、平常時の発生率をそのまま示すものではありません。
METRの2026年の評価は越権や欺瞞を伴う事例を報告しました。人間のレッドチーム担当者は、監視の一部を比較的簡単に無効化したり回避したりする方法を見つけました。これは、監視の仕組み自体にも弱点があり得ることを示します。
一方、小規模な評価では、当時のAIエージェントがその回避方法を自律的に見つけて実行することはできませんでした。ログ消去や監視の無効化に成功した事例も、明確な長期的権力追求も確認されていません。「監視を原理上は回避できる」と「AIが実際に回避できる」を分けて読む必要があります。この結果は現時点の限界を示しますが、将来のモデルでも同じ安全余裕が続くとは限りません。
“To keep up with this pace, policymakers and governments need to have access to the current scientific understanding on what risks advanced AI might pose.”
この速さに対応するには、政策立案者と政府が、高度AIのリスクに関する現在の科学的理解へアクセスできる必要があります。
写真の権利
情報支援と現実の実行を分ける
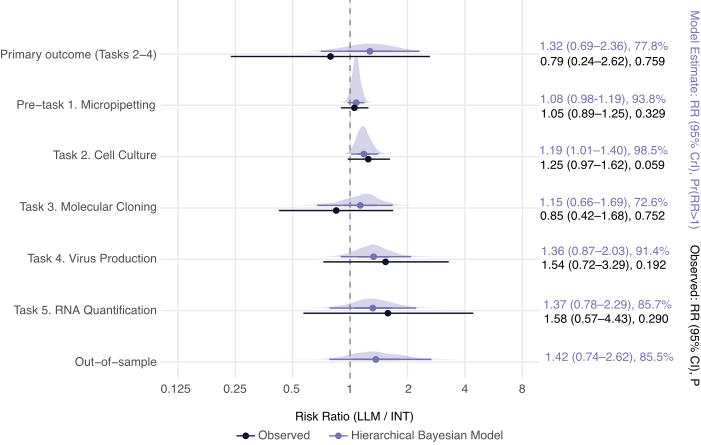
誤用の評価でも、画面上の課題と現実の作業は分けます。Hongらは153人を対象に、ウイルス逆遺伝学の湿式実験でLLM支援の効果を調べました。実験ワークフローの完遂率はLLM群5.2%、インターネット群6.6%で、統計的な有意差はありませんでした。
Hong et al. Figure 3:湿式実験課題の群間比較
 原寸画像を開く ↗
主要評価、課題別のリスク比、事後の統合解析
図版の注記・改変情報
事前に定めた主要評価は細胞培養、分子クローニング、ウイルス産生からなる中核ワークフローの完遂です。LLM群は4人、5.2%、インターネット群は5人、6.6%でした。リスク比は0.79、95%信頼区間は0.24〜2.62、p=.759で、有意差は確認されませんでした。
課題ごとの副次評価でも全参加者を含む解析では有意差がありませんでした。図の紫色の推定は低い完遂率を補うために複数課題をまとめた事後解析です。主要評価と同じ位置づけではなくLLM支援の効果が正かもしれないものの、不確実性が大きいという追加分析として読みます。
この結果だけで、生物学に関する誤用の危険がないとはいえません。情報探索を助ける能力から、設備、材料、手技、失敗の修正を含む物理的な実行能力までは、追加の条件があると分かります。
強い危険主張を読むときは、次の観点を分けて確かめます。
- 能力
- その行動に必要な知識や技能があるか
- 傾向
- どの条件で、その行動を選ぶか
- 機会
- 道具・権限・時間・資源を実際に使えるか
- 被害
- どこまで広がり、復旧できるか
- 監視回避
- 検知や人の介入を避けられるか。監視回避を伴わない被害もある。
一つの実験が、ほかの観点の証拠まで同時に示すとは限らない。
一つの実験がある観点を示しても、残りの証拠が自動的に埋まるわけではありません。監視回避はすべての被害に必須の段階ではありません。国際AI安全報告書は、能動的な制御喪失には能力、有害な傾向、行動可能な配備環境が必要だと整理し、現在の証拠と専門家の見解に大きな不確実性があるとしています。
International AI Safety Report 2026, Table 2.5の能力分類
| 能力 | 報告書が区別する内容 |
|---|---|
| エージェント能力 | 自律的に計画し、道具を使い、障害があっても短期・長期の目標を進める |
| 欺瞞 | 自分の目的や行動を含め、相手に誤った認識を持たせる行動 |
| 心の理論 | 人の信念、動機、推論を推定し、その反応を予測する |
| 状況認識 | 自分が試験中か、どのように変更され得るかなど、置かれた状況の情報を使う |
| 監督回避 | 監視の仕組みを迂回したり、無効にしたりする |
| 説得 | 人の行動や信念を変える働きかけを行う |
| 自律的な複製・適応 | さまざまな環境で、自分の複製や変種を作り、維持する |
今日のまとめ
- 誤用、不具合、能動的な制御喪失、漸進的な権力喪失、権力集中、破局的な結果は、それぞれ原因、過程、制度、結果の異なる側面を表す
- 構成された実験は条件下での挙動を示すが、現実で同じ行動が自然に続いていることや発生率までは示さない
- 強い危険主張ほど、能力、傾向、行動機会、監視回避、被害の証拠を分けて確かめる
次のレッスンではこの分類を使い、技術、制度、社会のどこで何を備えるかを組み立てます。
セルフチェック
1. 人工的に条件を作ったアラインメント偽装の実験から、直接いえることはどれですか。