プロンプトの型を手にしたところで、ベッドサイドに持ち出す。
はじめに:疑問は鮮度が命
回診中、上級医がぽつりと漏らす。「これ、どっちのガイドラインだったっけ」。研修医は反射的に「あとで調べておきます」と返す。昼になる頃には別のタスクが3つ降ってきて、あの疑問はどこかへ消える。
臨床疑問が消滅する原因は単純で、知りたい瞬間と調べる時間が一致しないからだ。AIはこのギャップを埋める道具になる。3分あれば仮説レベルの答えは手に入る。問題は、その3分で安全な答えを引き出せるかどうか。ここに型がいる。
ステップ1:疑問をPICO/PECOに分解する
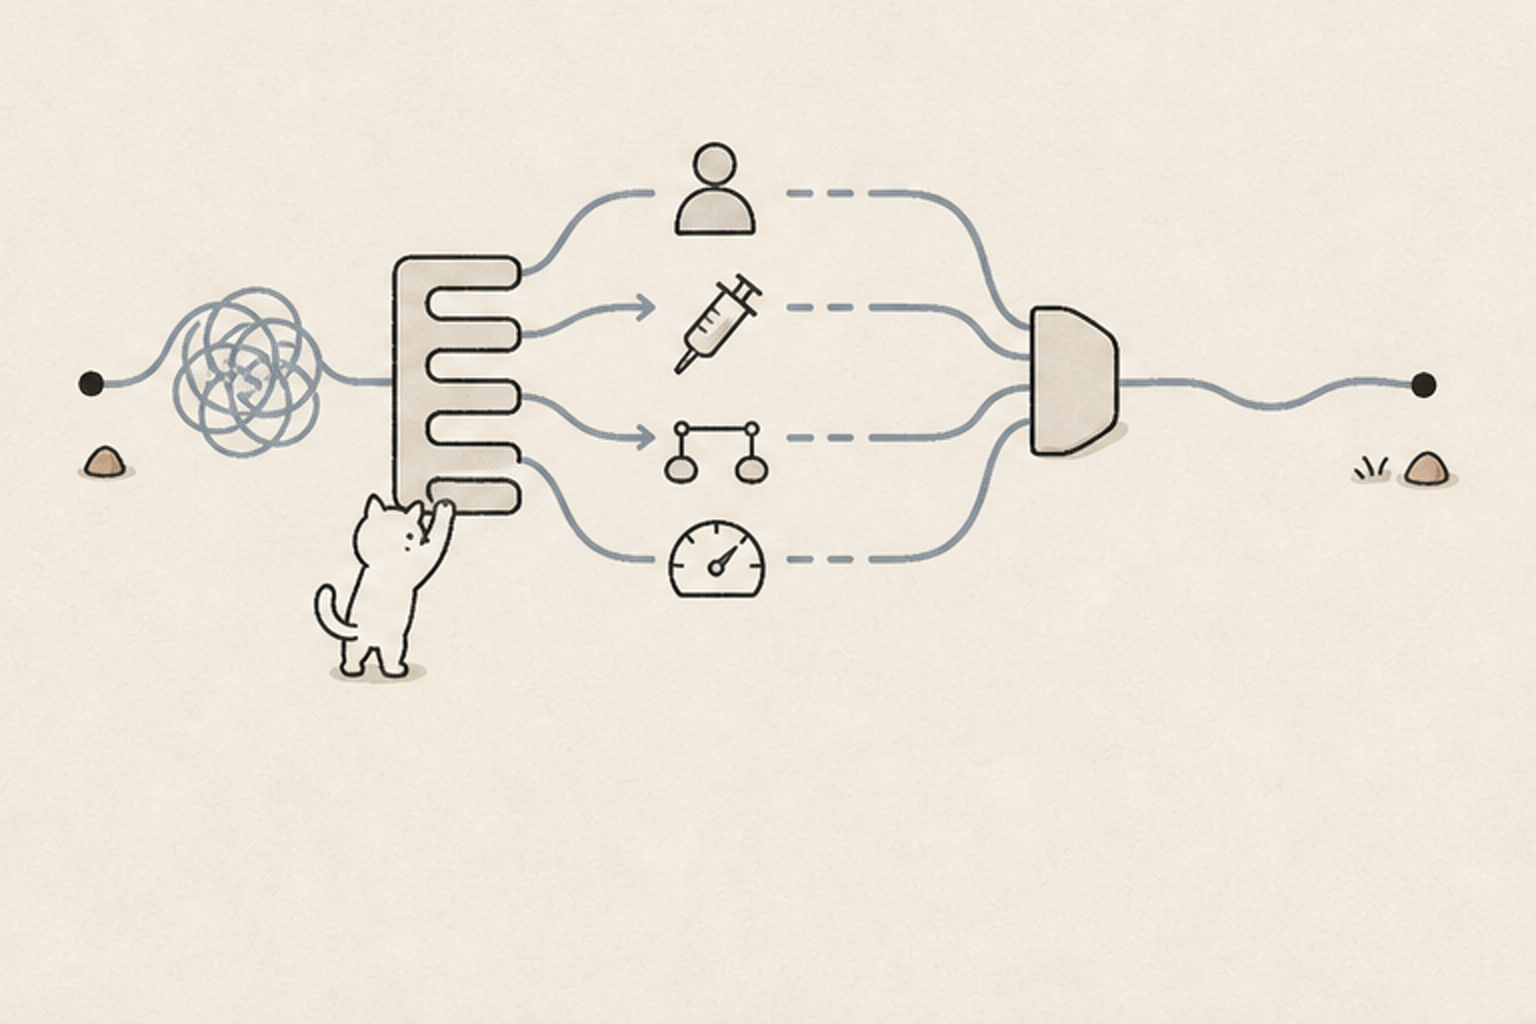
頭の中でぼんやりしている疑問を、まず構造に落とす。PICO(Patient, Intervention, Comparison, Outcome)か、介入の代わりに曝露(Exposure)を置くPECOの枠組み [1] に入れるだけで、AIへの指示が具体的になる。
たとえば「高齢の心房細動(Af)にDOACでいいのか」という疑問。これを分解する。
| 要素 | 内容 |
|---|---|
| P(患者) | 80歳以上、非弁膜症性心房細動、CHA₂DS₂-VASc 4点 |
| I(介入) | 直接経口抗凝固薬(DOAC) |
| C(比較) | ワルファリン |
| O(アウトカム) | 脳梗塞予防効果、出血リスク、死亡率 |
4軸に落としてから問う。AIは具体的な検索軸を得て、焦点の合った回答を返すようになる。「DOACとワルファリンのどちらがよいか」とだけ聞いた場合との差は大きい。
PICOに分けた疑問は、そのままAIに渡せる。
次の臨床疑問について、根拠になる論文とガイドラインを挙げながら答えてください。

【P(患者)】80歳以上、非弁膜症性心房細動、CHA2DS2-VASc 4点
【I(介入)】直接経口抗凝固薬(DOAC)
【C(比較)】ワルファリン
【O(アウトカム)】脳梗塞の予防、出血、死亡

引用した論文には、著者・雑誌・年を添えてください。
返ってきた論文は、PubMedで実在と中身を確かめてから使う。
ステップ2:文献ベースのAIを優先する
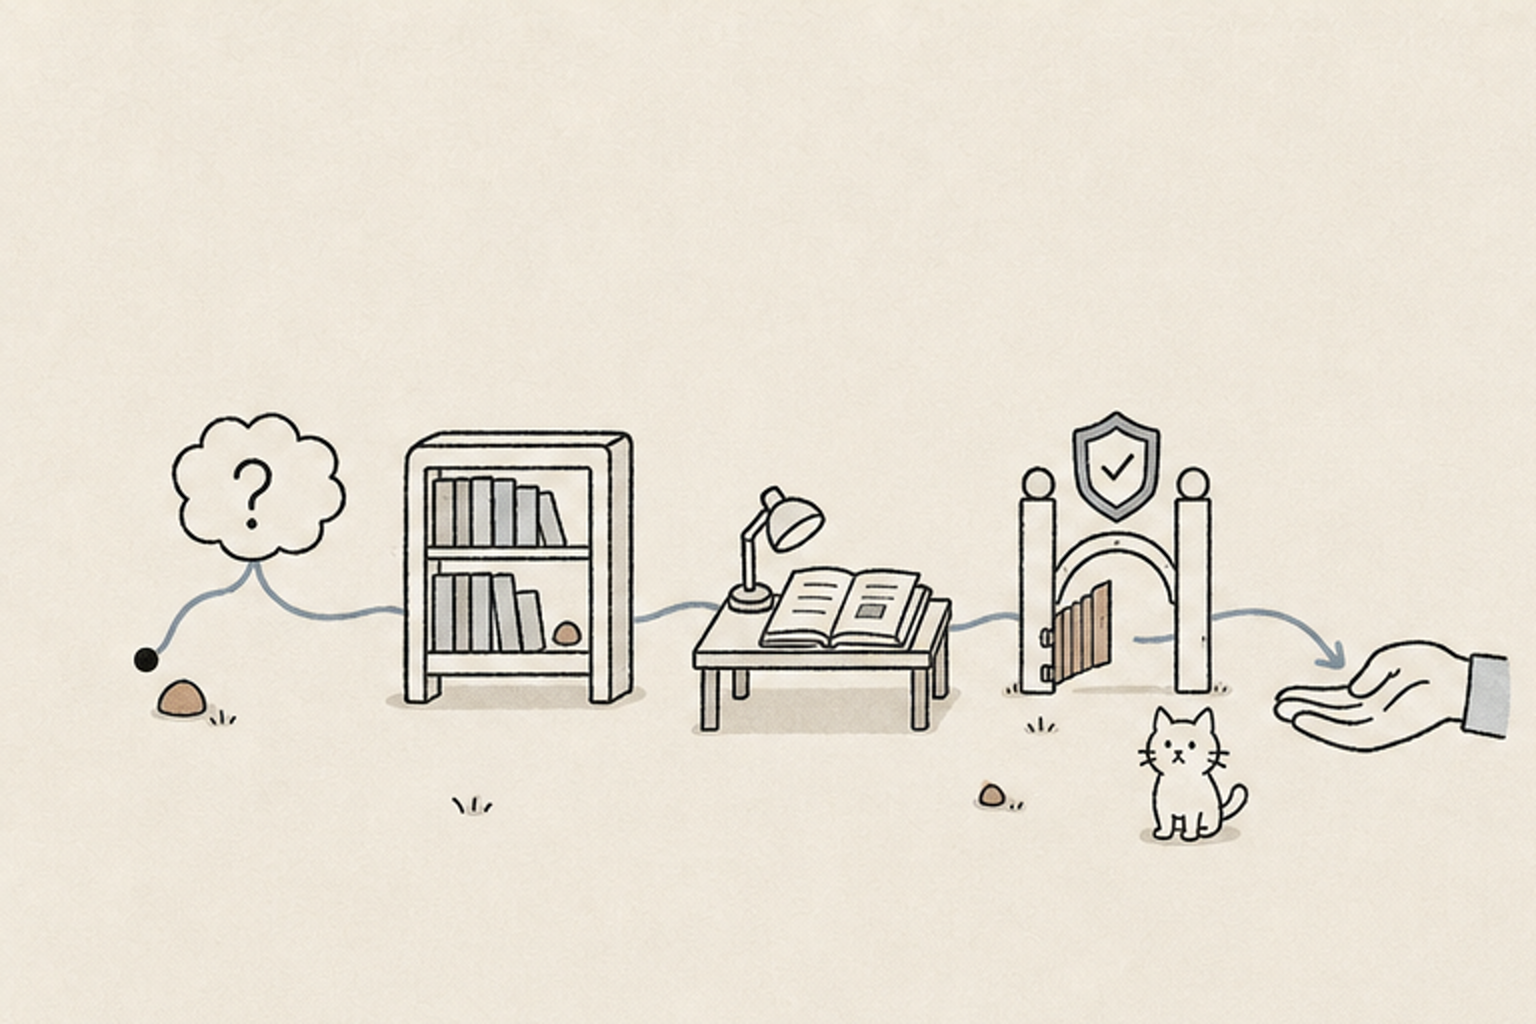
ChatGPTやClaudeに直接聞くと、ハルシネーションのリスクが消えない。実際、医療者から医薬品情報センターに寄せられた薬物療法の問い合わせ70件(2023年)を使った研究では、ChatGPT-3.5の回答は、医師が書いた回答より、情報の質と事実の正しさで劣った [2]。臨床疑問にはまずOpenEvidenceやConsensusなど、文献ベースのAI(主要ツール総覧で見た「文献・ガイドライン」のツール)を通す。
OpenEvidenceであれば、表のPICOを自然文で入力するだけで、該当する論文やガイドラインを引用した回答が返ってくる(医療者としての認証が要る。登録できないときは、Consensusなどで同じ順序をたどればよい)。引用リンクから原著に飛べる。このトレーサビリティがハルシネーション対策の要だ。ただし有効性の裏づけはまだ小さい。Mayo Clinic のプライマリケアの5症例を後ろ向きに評価した2025年の研究がある。OpenEvidence の回答は、明瞭さ・関連性・根拠の示し方で高く評価された。一方、診療の判断を変える影響は小さく、著者は前向きの試験が必要としている [3]。
文献ベースのAIで答えが出ない、あるいは不十分なときだけ汎用LLMで解釈を補う。この順序は崩さない。
比較
ベッドサイドAI使用の順番
- 文献ベースのAI(OpenEvidence/Consensus)でエビデンスを取得
- 汎用LLM(ChatGPT/Claude)で日本語要約・解釈の補助
- 公式ガイドライン・UpToDateで最終確認
- 上級医に提示して臨床判断にすり合わせる
→ AIは「上級医の代わり」ではなく「上級医に相談する前の準備」として位置づける。
ステップ3:答えを「自分の症例に翻訳する」
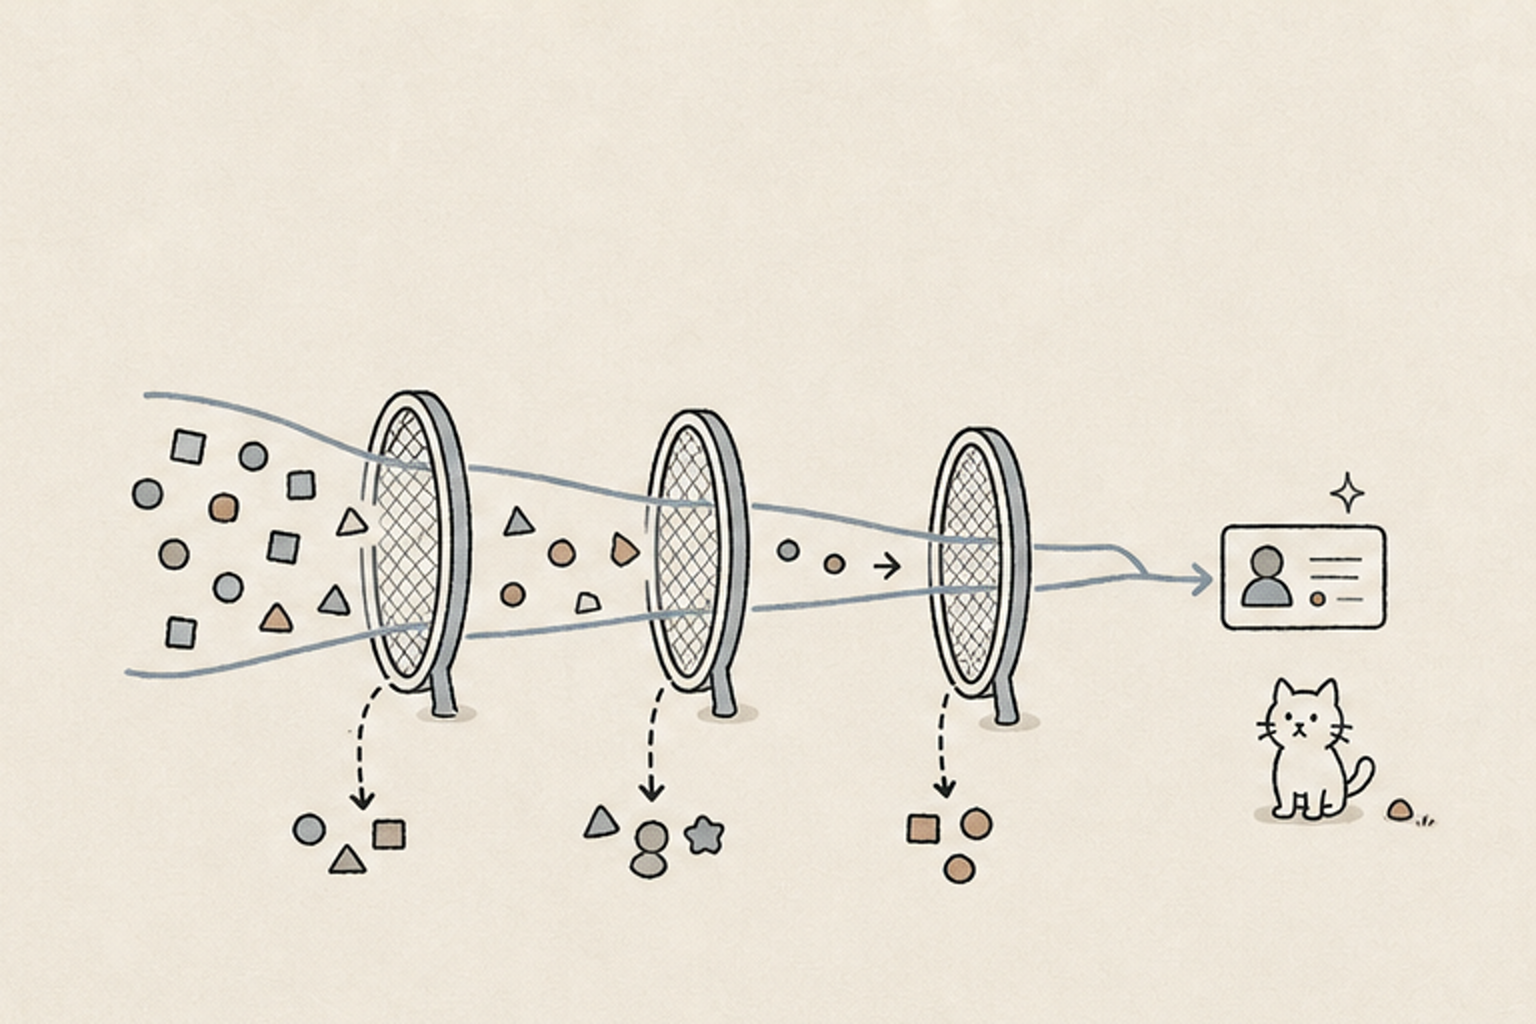
AIが返す答えは、あくまで論文集団に対する一般論だ。目の前の患者に当てはめるには、3つのフィルターを通す必要がある。
この患者は研究対象集団に近いか。論文の対象が腎機能正常の60代で、自分の患者がeGFR 30の85歳なら、エビデンスの外挿には限界がある。
患者固有の禁忌や相互作用はないか。AIは個別の併用薬まで見ない。お薬手帳とアレルギー歴との照合は医師の仕事だ。
この介入を選ばなかった場合の最悪シナリオは何か。AIは最善手を提示する。だが現場では最悪を回避する判断が優先される場面がある。
ステップ4:上級医への提示の仕方
AIから得た情報を上級医に持ち込むとき、「ChatGPTがこう言っていました」は最悪の切り出し方だ。こう変える。
「この臨床疑問をOpenEvidenceで調べたところ、DOACの4つの大規模試験をまとめたLancet誌2014年のメタ解析(Ruffら)で、DOACはワルファリンと比べて脳卒中・全身性塞栓症が少なく、頭蓋内出血はおよそ半分でした。一方で消化管出血は多めでした。ただこの患者は腎機能が落ちているので、年齢・体重・腎機能(クレアチニンクリアランスなど)から、添付文書の減量基準に当たるかを確かめたいと考えます。先生はどう思われますか?」
メタ解析の数字は [4] による。文献を踏まえた自分の仮説として出す。上級医も議論に乗りやすいし、自分の臨床推論も鍛えられる。ツールの名前ではなく文献を根拠に話すだけで、印象はまるで変わる。
参考文献
- Richardson WS, Wilson MC, Nishikawa J, Hayward RS. The well-built clinical question: a key to evidence-based decisions. ACP J Club. 1995;123(3):A12-A13.
- Krichevsky B, et al. Human vs. artificial intelligence: Physicians outperform ChatGPT in real-world pharmacotherapy counselling. Br J Clin Pharmacol. 2026;92(3):891-902. doi:10.1002/bcp.70321(オンライン先行公開 2025年10月。ChatGPT-3.5を2023年のデータで評価)
- Hurt RT, Stephenson CR, Gilman EA, et al. The Use of an Artificial Intelligence Platform OpenEvidence to Augment Clinical Decision-Making for Primary Care Physicians. J Prim Care Community Health. 2025;16:21501319251332215. doi:10.1177/21501319251332215(PMC12033599。5症例を4人の医師が後ろ向きに評価した小規模研究)
- Ruff CT, Giugliano RP, Braunwald E, et al. Comparison of the efficacy and safety of new oral anticoagulants with warfarin in patients with atrial fibrillation: a meta-analysis of randomised trials. Lancet. 2014;383(9921):955-962. doi:10.1016/S0140-6736(13)62343-0(PMID 24315724。脳卒中・全身性塞栓症 RR 0.81、頭蓋内出血 RR 0.48、消化管出血 RR 1.25)
セルフチェック
1. PICO形式に疑問を分解する目的として最も適切なものはどれか?
2. AIで得た情報を上級医に提示する方法として、最も適切なものはどれか?
明日のアクション
今週、回診や外来で出てきた臨床疑問を1つ選び、患者さんが特定される情報を除いてからPICOに分解して、OpenEvidenceに投げてみてほしい(登録がまだなら、Consensusなど他の文献ベースのAIでもよい)。返ってきた論文を1本だけ実際に開いて読んでみる。これだけで「3分間で疑問を仮説に変える」感覚が身につく。