患者説明の次は、問診力そのものを鍛える。
はじめに:練習機会のボトルネック
医療面接は回数で伸びる。だが研修医にとって、練習の場は驚くほど少ない。OSCE [1] 以降は実患者で場数を踏むしかなく、振り返りも自分の記憶頼みになる。上級医に患者役を頼むのはハードルが高い。
生成AIは、このボトルネックを小さくする手がかりになる [2]。症例設定を渡して患者役を演じさせれば、時間も相手の都合も気にせず問診を繰り返せる。振り返りもAIに手伝わせられる。このレッスンでは、AI模擬患者の設定方法と運用上の注意点を扱う。
AI模擬患者の作り方
ChatGPTでもClaudeでも、症例設定を渡して患者役を演じさせるだけで成立する。出来を決めるのは、最初のプロンプトで渡す枠組みの密度だ。
あなたは54歳の男性です。3日前から右下腹部に痛みがあります。
私は外来の医師で、これからあなたに問診をします。
以下のルールで答えてください。

【ルール】
- 私が聞いたことにだけ答える(聞いていない情報は出さない)
- 裏設定にないことを聞かれたら「分かりません」「覚えていません」と答える(作り話をしない)
- 一般人らしい言葉で話す(医学用語は使わない)
- 痛みや症状を聞かれたら、遠慮せず素直に表現する
- 私が「終わり」と言うまで患者役を続ける

【裏設定(あなたしか知らない情報)】
- 実は虫垂炎初期
- 2日前から微熱(37.6℃)
- 食欲低下、嘔気あり、嘔吐なし
- 既往:高血圧、内服中
- アルコール毎日2合
裏設定が要になる。この情報を問診で引き出せるかどうかを試すゲームになる。 聞き忘れた既往歴、拾えなかった併存症、触れなかった生活歴。終了後にすべて可視化される。
練習の3つのモード
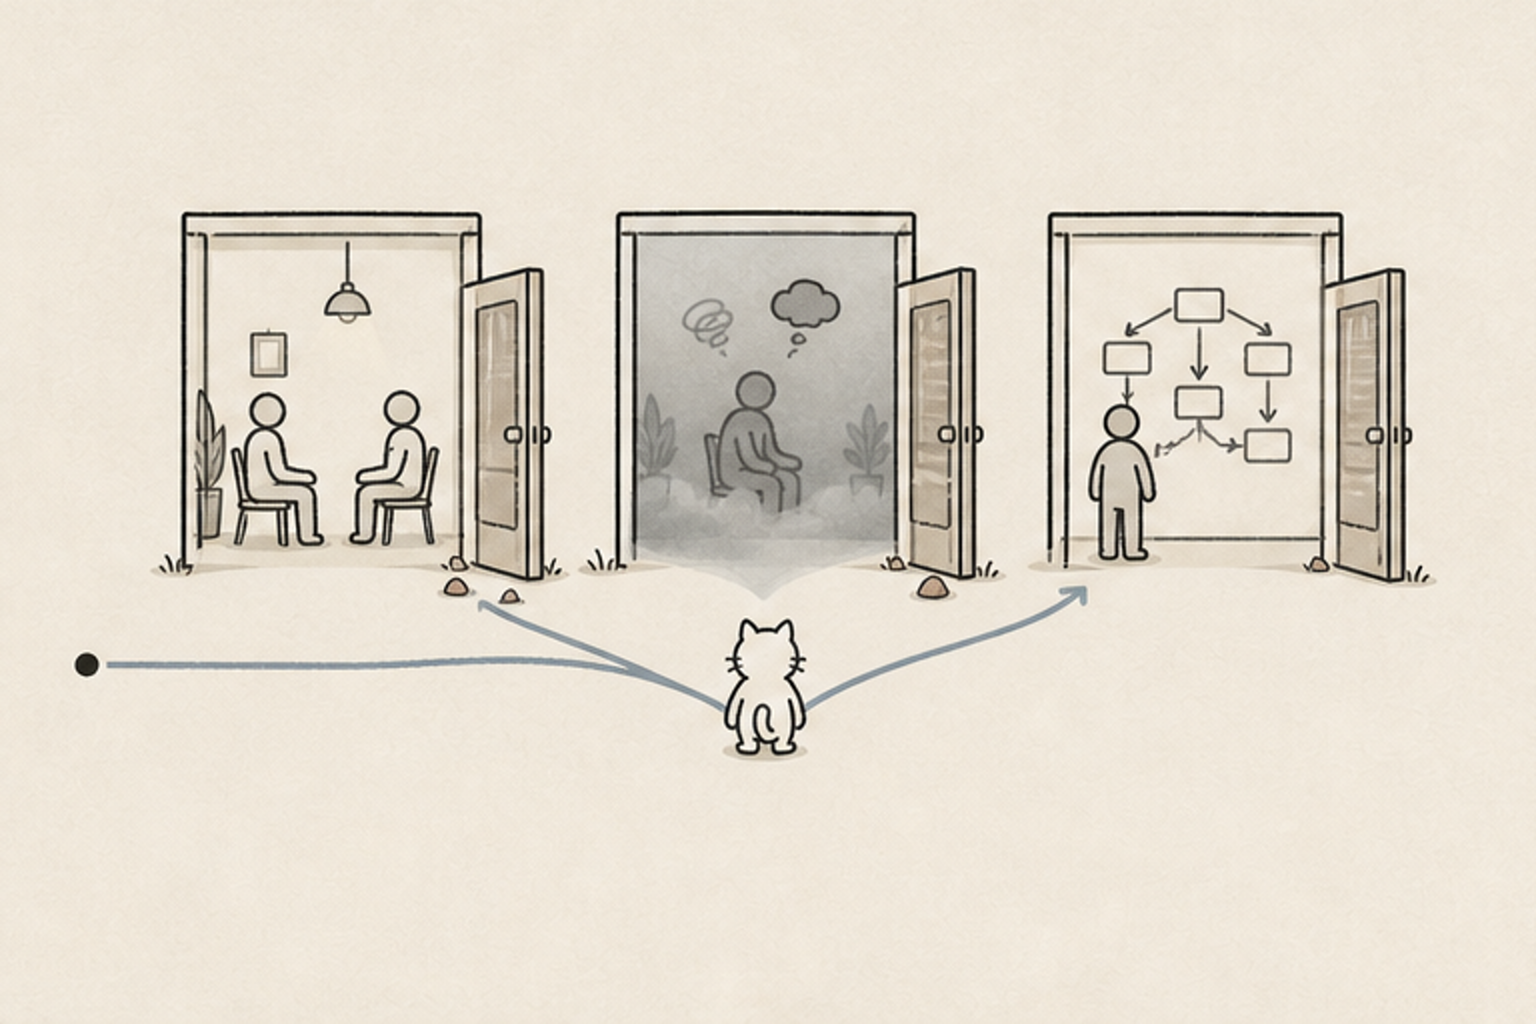
1つ目は基本問診。主訴から既往歴・生活歴まで、型どおりに聞き切る練習で、先ほどの設定をそのまま使う。
2つ目は情報が曖昧な難症例。ルールに「質問があいまいなら、あいまいに答える」「話がときどき脇にそれる」を足すと、聞き方の工夫が要る患者になる。
3つ目は鑑別を分岐させる症例。裏設定に正解の診断を書いたうえで、似た症状を示す別の病気とも矛盾しない症状を中心に入れておく。どの質問で鑑別が絞れるかを試す練習になる。
どのモードも、ルールと裏設定を書き換えるだけで切り替えられる。
視点
AI模擬患者の最大の価値
AI模擬患者の本当の価値は、「失敗を恐れずに何度でもやり直せる」点にある。実際の患者さんでは、聞き方を間違えれば信頼を損なう。OSCEでは、間違えれば点数が下がる。AIなら、何度でもリセットして、別のアプローチを試せる。
→ 医療面接は「正解を覚える」ものではなく、「自分の引き出しを増やす」もの。AI模擬患者は引き出しを増やす最適な砥石になる。
振り返りもAIにさせる
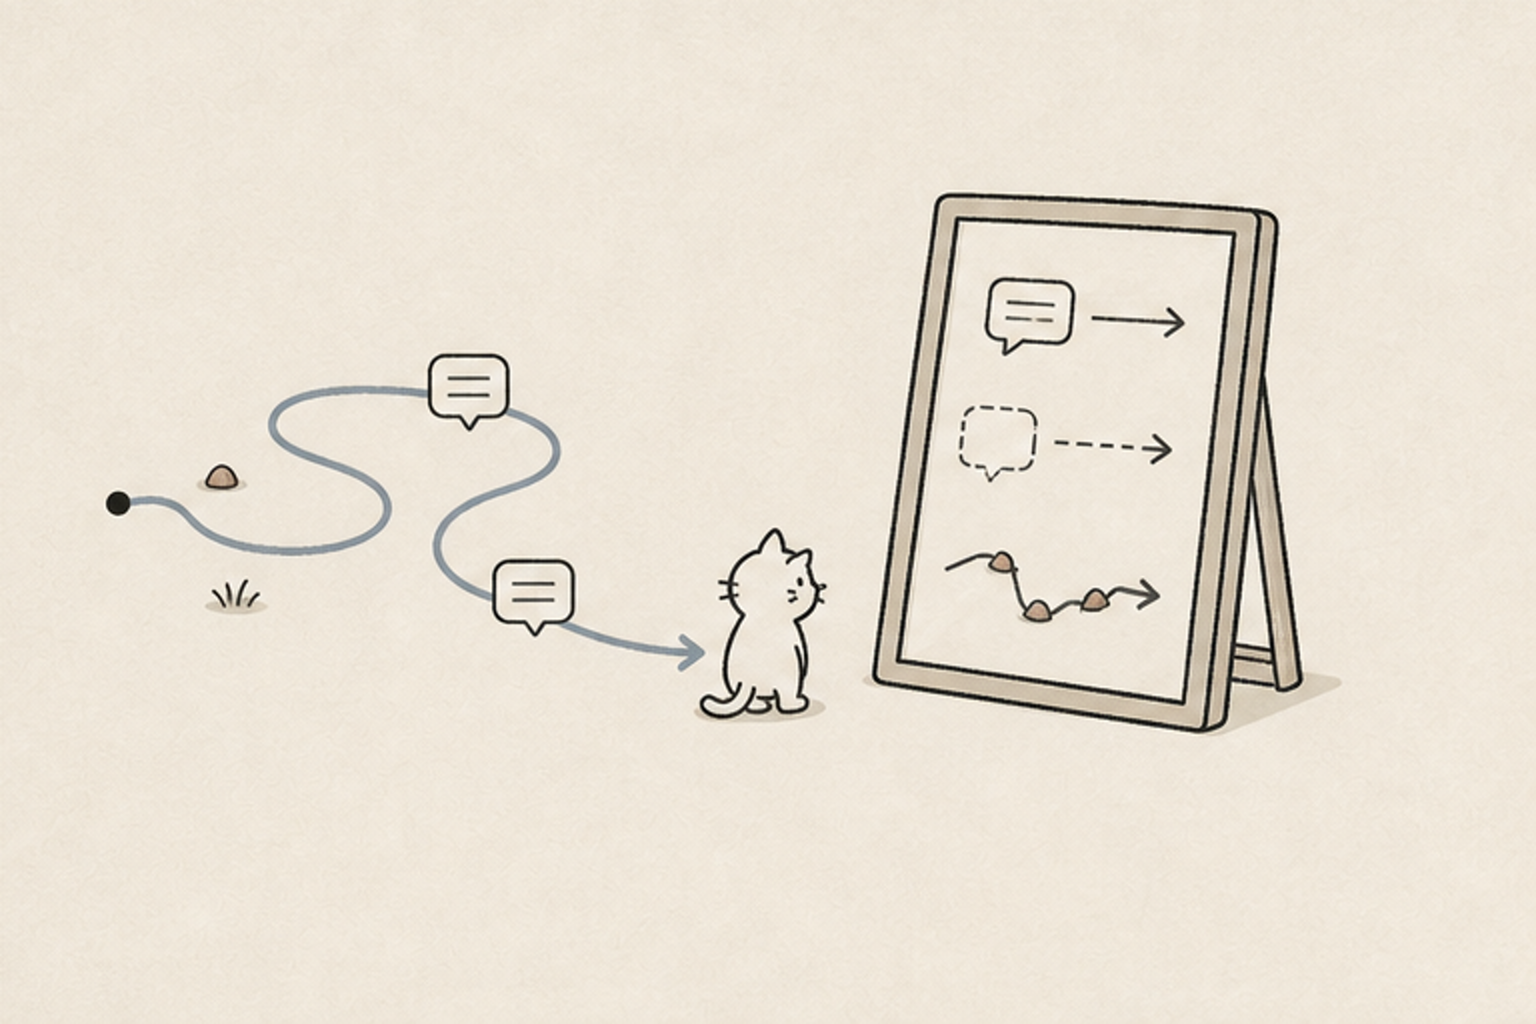
問診が終わったら、同じチャットの中で振り返りを頼む。
AIは患者目線と医師目線の両方からフィードバックを返す。「OSCE評価表の形式で」と追加すれば、構造化されたチェックリストにもなる。一人で練習しているのに、自分では気づけなかった盲点が浮き上がってくる。
限界と注意点
当然、限界もある。
非言語情報が再現できない。顔色、表情、姿勢、声の震え。実際の問診では、文字では伝わらない情報が多い。テキストベースのAIにこれは無理だ。
台本にない質問には、AI患者が作り話で答えることがある。GPT-3.5の模擬患者を医学生28人が試した研究では、台本にない質問への回答のうち、56.4%が作り話だった [2]。ルールで「作り話をしない」と指示しても、なくなるとは限らない。患者役の答えは医学的な正解ではなく、練習用の反応として扱う。
希少疾患のパターンに偏りがある。AIは平均的な症状の組み合わせを返しがちで、教科書から外れた非典型例は苦手だ。「非典型に演じて」と指示すればある程度対応するが、限界はある。
本物の患者の代わりにはならない。AI模擬患者は事前練習と振り返り教材であり、実患者での経験を補完する道具だ。そう割り切って使う。
それでも、限界は少しずつ縮まりつつある。2026年のJMIR Medical Education誌の研究では、生成AIの模擬患者との面接記録をAIが評価した結果が人間の評価と近く、評価にかかる時間も大きく短くなったと報告されている。ただし参加者7人の小規模な研究だ [3]。2025年にCommunications Medicine誌に発表された研究は、LLMエージェントで動く模擬患者のシステムを試作して評価した。医学生の調査では、問診の練習としての評価が、人が演じる模擬患者と同等以上だったと報告している [4]。
参考文献
- Harden RM, Stevenson M, Downie WW, Wilson GM. Assessment of Clinical Competence Using Objective Structured Examination. Br Med J. 1975;1(5955):447-451.
- Holderried F, Stegemann-Philipps C, Herschbach L, et al. A Generative Pretrained Transformer (GPT)-Powered Chatbot as a Simulated Patient to Practice History Taking: Prospective, Mixed Methods Study. JMIR Med Educ. 2024;10:e53961. doi:10.2196/53961(医学生28人の実現可能性の研究。台本外の質問への回答の56.4%が架空の情報)
- Takahashi H, Shikino K, Kondo T, et al. AI- vs Human-Based Assessment of Medical Interview Transcripts in a Generative AI-Simulated Patient System: Cross-Sectional Validation Study. JMIR Med Educ. 2026;12:e81673. doi:10.2196/81673(参加者7人の小規模研究)
- Yu H, Zhou J, Li L, et al. Simulated patient systems powered by large language model-based AI agents offer potential for transforming medical education. Commun Med. 2025;6(1):27. doi:10.1038/s43856-025-01283-x(LLMエージェントによる模擬患者システム AIPatient を開発し、問答の正確さ・読みやすさと、医学生による評価を報告した研究)
セルフチェック
1. AI模擬患者の最大の価値として最も適切なものはどれか?
2. AI模擬患者の限界として最も適切でないものはどれか?
明日のアクション
今夜、5分でいいのでAI模擬患者を1セッションやってみてほしい。テーマは何でもいい。「腹痛で来院した30代女性」程度で十分。終わった後に振り返りを依頼すれば、自分の問診のクセが一発で見える。