ここまで守ってきたのは、作ったアプリでした。今回守るのは、作っている最中のあなたのPCです。
Claude Codeのようなエージェントは、ファイルを書き換え、コマンドを実行します。強力さと危険は、同じ蛇口から出てきます。Anthropicは2026年に「Zero Trust for AI Agents」という36ページの公式ガイドを出し、公式ドキュメントでも何が危険で、どう使ってほしいかをはっきり書いています。今回はその言葉を直接引きながら、1つの方程式と4つの安全装置を確認します。
ㅤ
致命傷の方程式: リーサルトライフェクタ
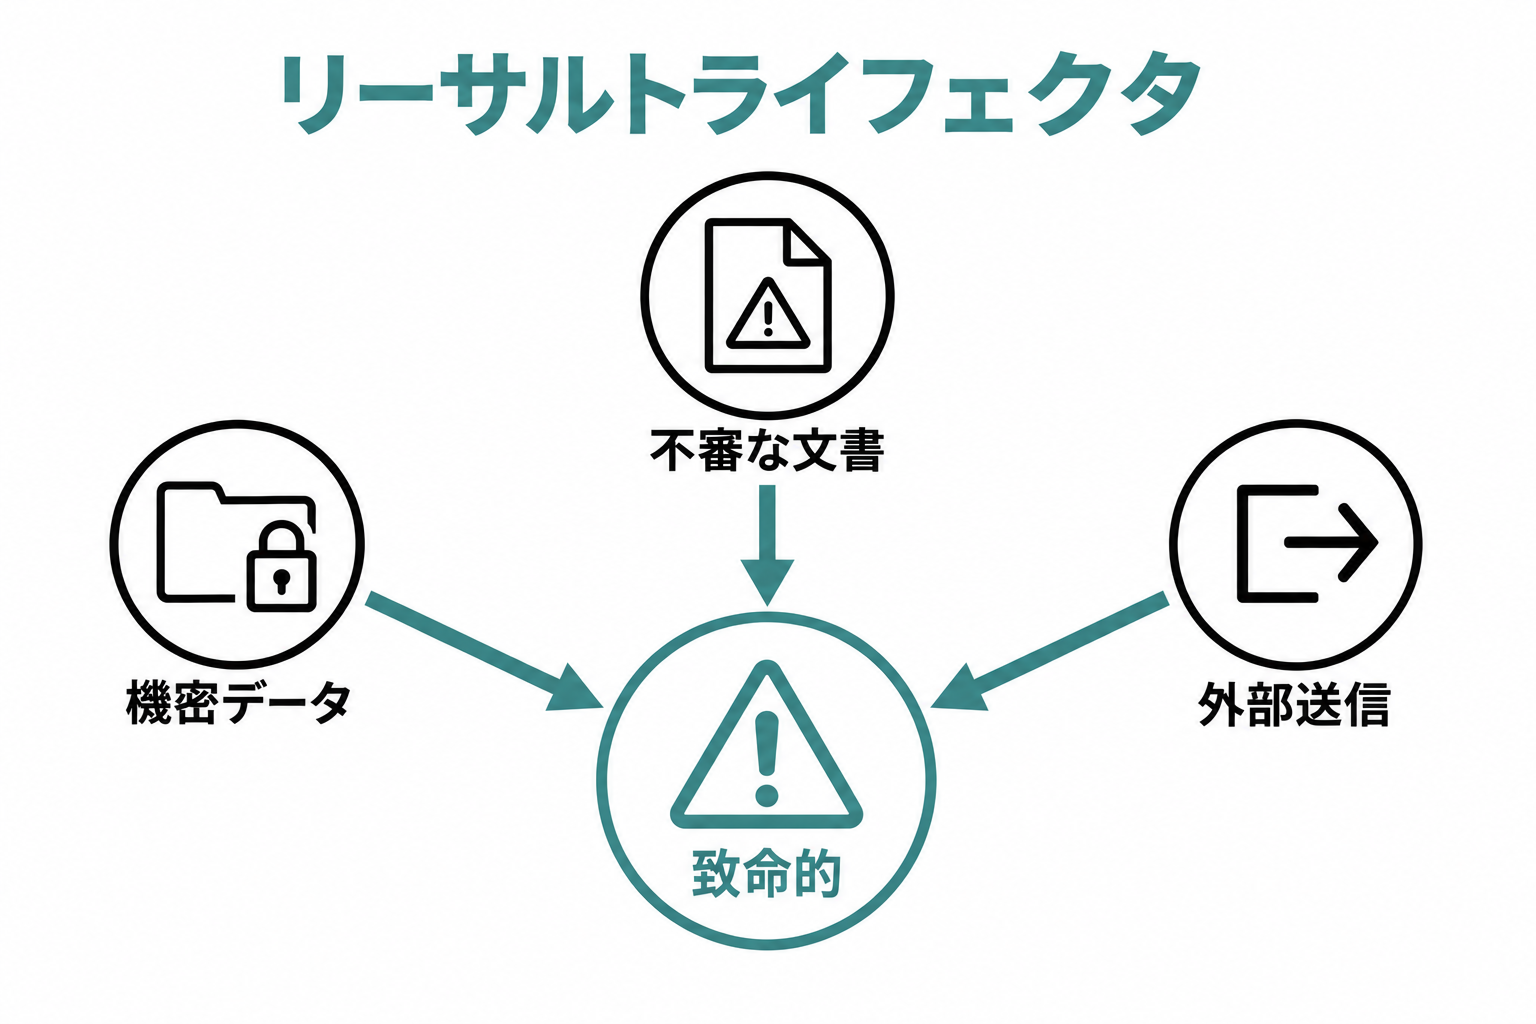
セキュリティ研究者のSimon Willison(サイモン・ウィリソン)は、AIエージェントが致命的な被害を出す条件を、3つの能力の組み合わせとして整理しました。リーサルトライフェクタ(lethal trifecta、致命的な三拍子)と呼ばれます。
対策の発想は明快です。3つを同時に揃えない。 機密に触れる作業では外部Webを切る。外部の文書を読ませる作業では機密フォルダに触れさせない。
視点
ゼロトラスト: 「誤作動する前提」で設計する
Anthropicの公式ガイド「Zero Trust for AI Agents」の土台は、ゼロトラストという古典的な考え方です。決して信頼せず常に検証する。侵害を前提とする。権限は最小にする。エージェントは攻撃されなくても確率的に誤作動する、という前提で設計します。誤削除・誤送信は悪意ゼロでも起きる。だから目標は「完璧に信頼できるエージェント」ではなく、「誤作動しても被害が広がらない環境」になります。
ㅤ
安全装置1: 権限モードを理解する
Claude Codeは、既定では読み取り以外の操作にあなたの承認を求めます。ファイル編集もコマンド実行も、一度あなたに聞いてから。公式ドキュメントの言葉では、こうです。
You're responsible for reviewing proposed code and commands for safety before approval.(提案されたコードやコマンドの安全性を承認前に確認する責任は、あなたにあります)
一方で、すべての確認を飛ばす --dangerously-skip-permissions(bypassPermissions)というモードも存在します。Anthropicはこのモードの用途を明確に限定しており、「隔離されたコンテナやVM(仮想マシン)でのみ使用すること」としています。壊れても困らない使い捨ての環境専用です。日常のPC、患者関連ファイルや原稿の入ったマシンでの常用は、開発元の想定外だと知っておいてください。
注意
便利さに慣れた頃がいちばん危ない
エージェントに慣れてくると、確認ダイアログを読まずにEnterを押すようになります。これは実質、bypassモードと同じです。全部を熟読する必要はありませんが、削除・送信・インストールの3語が見えたら指を止める。この癖だけで、重大事故の大半は避けられます。
権限のもう一段細かい話が、渡す道具そのものを絞ることです。ゼロトラストのガイドはこれを least agency(最小の行動力)と呼びます。データを見せたいだけなら読み取り専用のツールを渡す、メールを確認させたいなら閲覧だけのツールにする。第3回でRLSに書いたポリシーと同じ発想を、自分のエージェントにも向けます。
ㅤ
安全装置2: MCPサーバーは「無審査」と知る
MCP(AIと外部ツールをつなぐ仕組み、連携編参照)は、エージェントの手を一気に増やします。NotionやGmailにつながるのは、その仕組みのおかげです。
多くの人が誤解している事実がひとつあります。Anthropicの公式ドキュメントは、第三者のMCPサーバーについてこう明言しています。
Anthropic ... does not security-audit or manage any MCP server.(AnthropicはいかなるMCPサーバーについても、セキュリティ監査や管理は行っていません)
ディレクトリに掲載される際の基準確認はありますが、中身の安全性を保証する仕組みではありません。MCPサーバーを1つ足すことは、新しいスタッフを1人、合鍵付きで雇うことに相当します。使わなくなったものは、医療セキュリティ回でやったとおり、定期的に棚卸しして外します。
MCPサーバーを足す前に見る2点
提供元
信頼できる提供元のものを使うか、自分で作る。誰が作ったか、何の権限を求めているかを雇う前に見る
ツールポイズニング
ツール本体は正常でも、説明文にAIへの指示が仕込まれるパターン。説明文はインストールした瞬間にエージェントのプロンプトへ入る
ㅤ
安全装置3: 外部の文章を素通しさせない
前回のプロンプトインジェクションは、エージェントの世界ではもっと切実になります。エージェントはWebページを読み、その内容に基づいて行動するからです。Anthropicの研究チームは「エージェントが訪れるすべてのWebページが、潜在的な攻撃経路」と書いています。悪意ある文章を読んだエージェントが、あなたの意図しないコマンドを実行する。これが現実の攻撃シナリオです。
Claude Code側にも防御はあります(Web取得の内容を隔離された文脈で処理する、など)。それでも公式ドキュメントの推奨は明確です。
外部の文章への防御
信頼できない内容を流し込まない
そのままエージェントに読ませない
隔離環境で実行する
外部Webサービスと絡む作業はVM(仮想マシン)での実行を検討する
医療者の日常に引き付ければ、「知らないサイトのテキストを丸ごと貼り付けて『これやっといて』と頼まない」。
ㅤ
安全装置4: チャットの学習利用設定を確認する
個人向けのClaude(Free/Pro/Max)には「Model Improvement」という設定があり、オンの場合は入力内容がモデルの学習に使われることがあります。設定はいつでも変更できます(claude.ai の Settings から Privacy)。
一方、Claude CodeやAPIなどの商用条件下では、Anthropicは既定で学習に使いません。公式ドキュメントの言葉です。
Anthropic does not train generative models using code or prompts sent to Claude Code under commercial terms.
Vibe Coding連載の第1回から言い続けている「患者情報をAIに入れない」は、マナーの話ではなく、この仕組みを踏まえた防御線です。設定を確認した上で、それでも入れない。二重の守りにしてください。
明日のアクション
今日中にやる3点
- claude.ai の Settings で Model Improvement(学習利用)の設定を確認する
- 自分が接続しているMCPサーバーを一覧にし、「提供元を説明できないもの」を外す
- Claude Codeを bypass 系モードで常用していないか振り返る(常用しているなら、承認モードに戻すか隔離環境を検討)
ㅤ
参考・出典
- Willison, S. "The lethal trifecta for AI agents" (June 2025). https://simonwillison.net/2025/Jun/16/the-lethal-trifecta/
- Anthropic. "Zero Trust for AI Agents" (2026). https://claude.com/blog/zero-trust-for-ai-agents
- 数理の弾丸. 「AIエージェントのセキュリティ入門」(YouTube, 2026年7月). https://youtu.be/gySaTW5CRHw
- Anthropic公式. "Security" (Claude Code Docs). https://code.claude.com/docs/en/security
- Anthropic公式. "Permission modes" (Claude Code Docs). https://code.claude.com/docs/en/permission-modes
- Anthropic公式. "Data usage" (Claude Code Docs). https://code.claude.com/docs/en/data-usage
- Anthropic. "Defending against prompt injection attacks". https://www.anthropic.com/research/prompt-injection-defenses
- Anthropic公式. "Remote MCP servers". https://docs.claude.com/en/docs/agents-and-tools/remote-mcp-servers