文章を返すAIと、物を動かすAIには大きな違いがあります。後者の失敗は、画面の中で終わりません。箱を落とす。人の通路をふさぐ。器具を誤った位置へ動かす。だから性能だけでなく、止まり方まで設計します。
見て、考えて、動き、また見る
VLAはVision、Language、Actionの組合せです。カメラなどで見た環境と言葉の指示を受け、機体の動作へ変えます。Google DeepMindのGemini Roboticsは、汎用モデルが新しい物体や指示に対応する研究の一例です。これは医療機器としての承認や、病院での安全性を示すものではありません。
言葉が、身体の行動ループへ入った
画面内の誤りは、物理世界では衝突や損傷になり得ます。
- 知覚
カメラやセンサーで状態を読む
- 言語目標
人の指示を行動へ分解
- 動作
ロボットが環境へ働きかける
- フィードバック
結果を見て次の動作を変える
- 安全停止
逸脱時は人が介入
最後の工程「安全停止」から最初の工程「知覚」へ戻る
動作後に位置、周囲の人、対象物の状態をもう一度観測するため、これは一方向の処理ではありません。観測結果から次の動作を変える、閉じた循環です。さらに、人が止める条件と、停止後の代替手順を循環の外側に置きます。
デモと臨床の間には段差がある
ロボットの動画が滑らかでも、そのまま患者の近くへ置けるわけではありません。証拠は、仮想環境、実験室、体外組織、動物、生体、人の臨床という順に、問えることが変わります。
研究デモと患者への導入の間には段階がある
ex vivoの成功を、自律診療の実現と呼びません。
- 研究室デモ
限定環境で動作を示す
- ex vivo
生体外組織で工程を試す
- 動物・模擬環境
変動と安全限界を測る
- 臨床試験
患者利益と有害事象を評価
- 規制下導入
責任、訓練、監視を運用
2025年のSRT-H研究は、胆嚢摘出術の一部を、体外に取り出した豚胆嚢8例で自律実行しました。対象はex vivoです。人体で全手術をした研究でも、合併症や予後を改善した臨床試験でもありません。進展は、失敗を検出して修正する構成を、限定した工程で示したことです。原著
一方、FDAの既存のロボット支援手術機器に関する説明では、機器は外科医が直接制御し、人の直接制御なしに手術するものではありません。これは現在の承認済み機器を理解する背景であり、SRT-Hの自律性を裏づける資料ではありません。
この段差を飛ばさないことが、フィジカルAIを過大評価しない最短ルートです。
最初に任せるのは、戻せる仕事
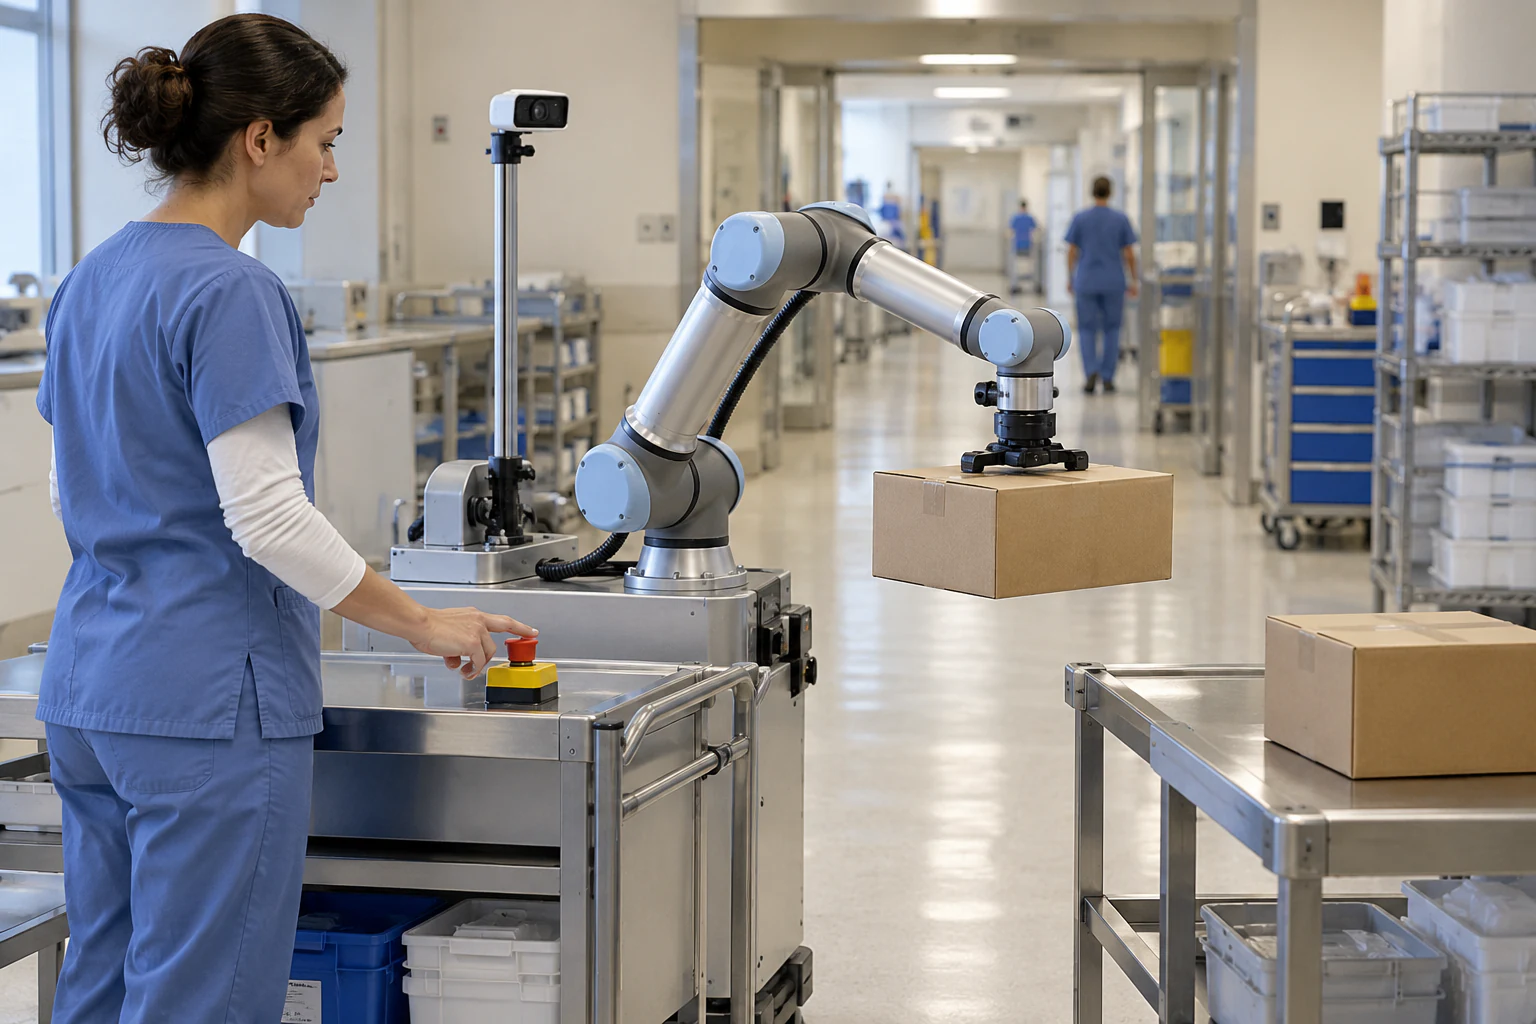
病院で先に試しやすいのは、失敗時に人が引き取りやすい仕事です。封をした物品の定期搬送、棚卸し、決められた区域の案内などが候補になります。患者への処置や身体接触は、同じ「動くAI」でも危険の種類が違います。
試験では成功率だけを見ません。通行を妨げた時間、積込みと受取りの手間、停止回数、復旧時間も測ります。自動化した結果、人の確認作業が増えたなら、その時間も費用です。
架空の搬送を紙で試す
公開情報と架空条件だけで、受付から展示室へ箱を運ぶ計画を作ります。人の担当、機体の担当、未確認の能力を分けてください。混雑、扉、通信断のどれかが起きたら中断し、台車で運ぶ手順へ戻します。
合格条件は、速さを推測することではありません。観測、判断、動作、再確認、人への引継ぎが一枚で読めることです。実機を動かす前に、何を確かめるかが決まっていれば、試験は小さくできます。
身体を持つAIの責任を分けた次は、現場ですでに始まった記録・判断支援の研究を見ます。
参考・出典(3件)
- Gemini Robotics brings AI into the physical world(Google DeepMind, 2025)
- SRT-H: A hierarchical framework for autonomous surgery via language-conditioned imitation learning(Science Robotics, 2025)
- Computer-Assisted Surgical Systems(FDA, 2026年確認)