AIは、知識を読む工程から、仮説を作って確かめる工程へも広がっています。AIの提案と、実験で得た結果を分けて読んでください。
2026年5月には、Googleの研究者らによるCo-Scientistの論文がNatureに掲載されました。AIが出した仮説の一部を、実験で確かめた報告です。Gottweisら(2026年)
医師の研究でも、問いを整え、別の説明を探し、検証の手順を作る工程が変わるかもしれません。何をAIが行い、何を人が確かめたのかを追います。
1. エージェントは道具を実行し、結果から次を選ぶ
エージェントは、目的に向け、途中の手順や道具を選ぶ構成です。Anthropicは2024年、あらかじめ順序を決めるワークフローと区別しました。Anthropicの技術記事
研究準備なら、検索の計画、資料の収集、候補の比較、追加調査を進めます。検索や計算の結果が返るたびに、次の作業を選びます。
「検索した」「計算した」という説明だけでは、実行した結果は分かりません。道具から返った結果と、生成された説明を照合します。
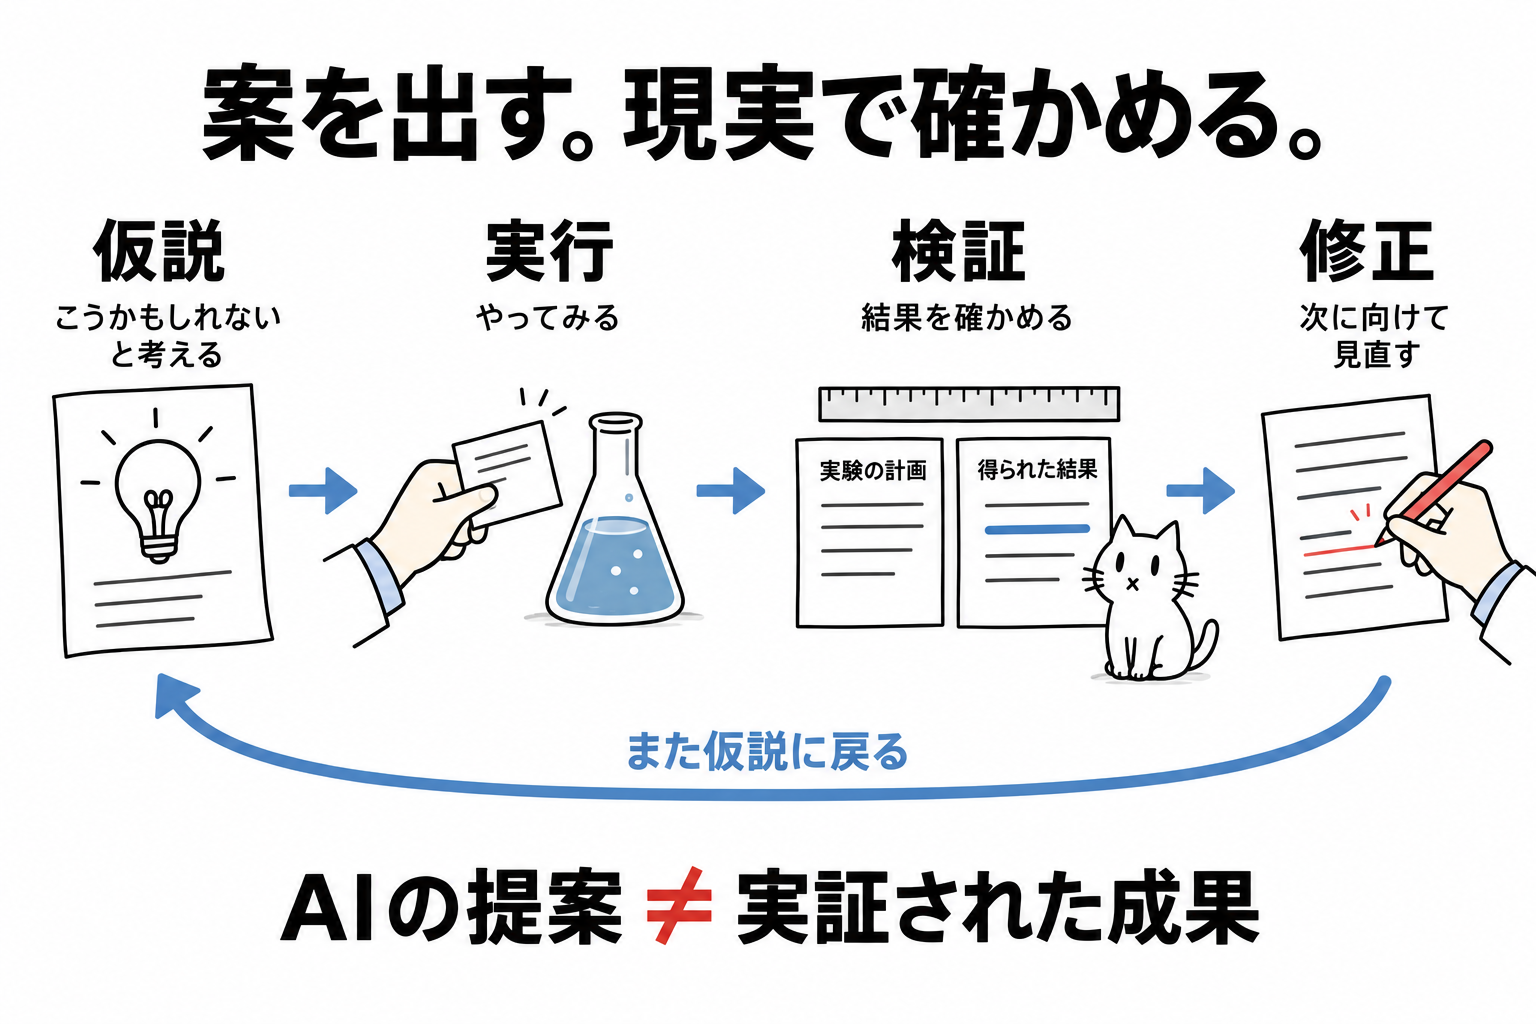
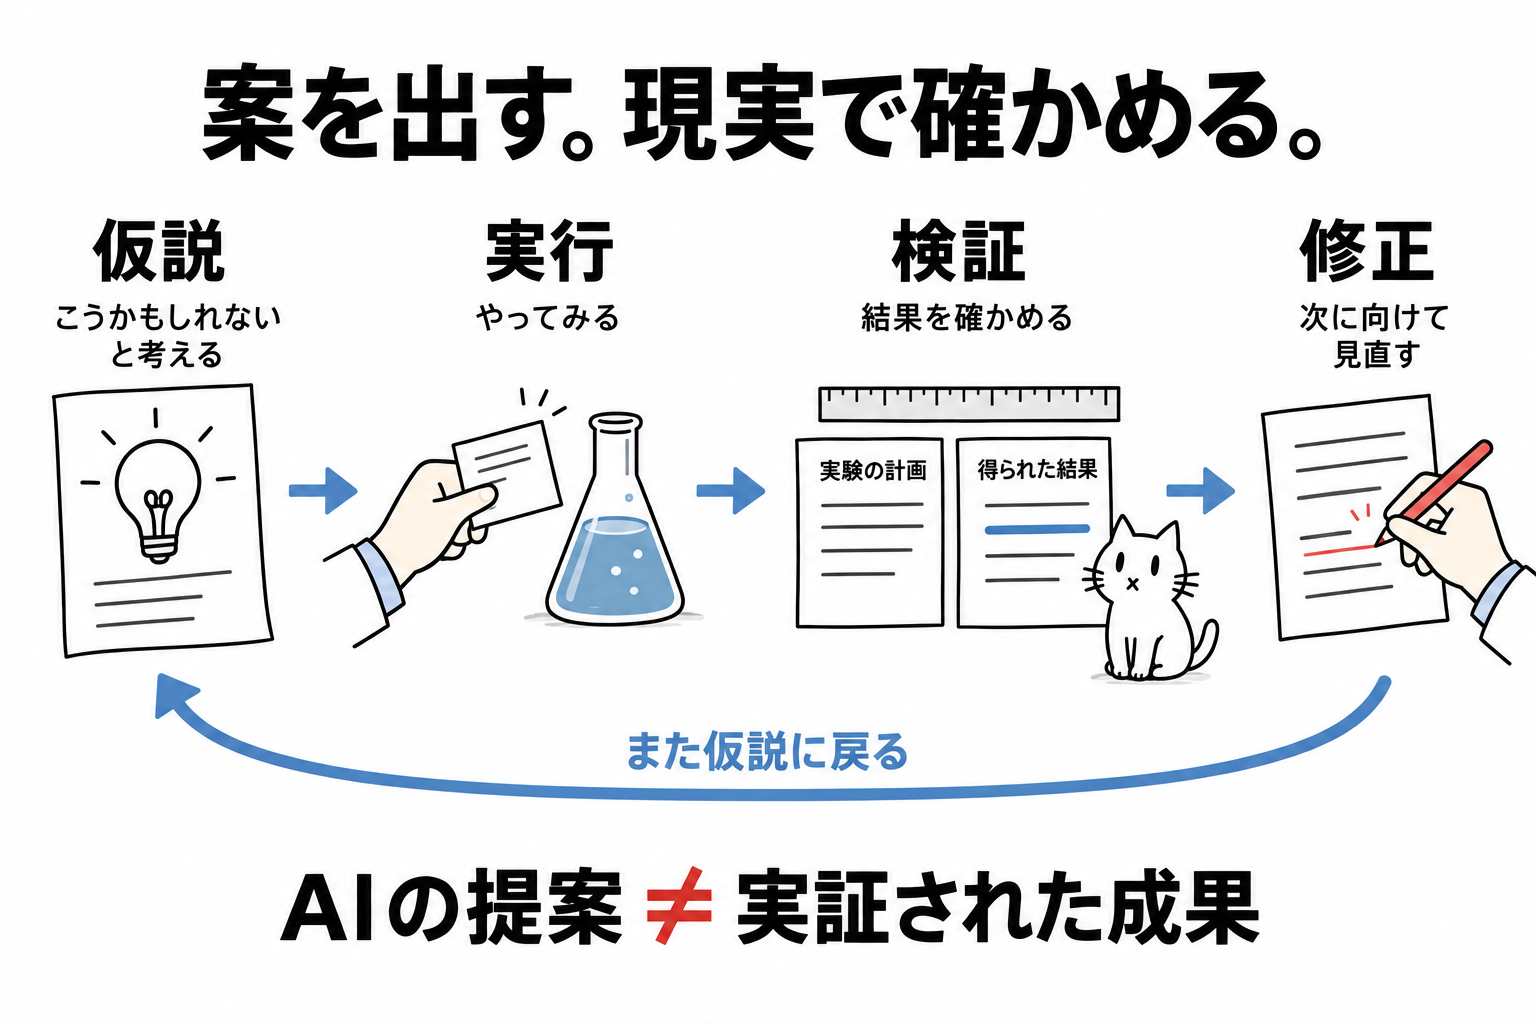
長い作業には、途中の確認地点と停止条件を置きます。Anthropicの記事も、人の確認や最大反復回数を説明しています。
- 検索語が問いに合うかを、人が見てから候補の比較へ進む。
- 資料が見つからなければ、そこで止めて戻す。
- 指定した計算量や反復回数を超えたら、中断する。
2. AlphaFoldの構造予測を、治療効果と分ける
タンパク質は、アミノ酸が連なって立体構造をとります。Jumperらは2021年、配列からその構造を予測するAlphaFoldの性能を報告しました。形は、働きを調べる手がかりです。Jumperら(2021年)
構造の予測は、次に調べる場所を選ぶ材料になります。患者に有効か、副作用が許容できるかは、別の評価です。
予測の成果から、次の問いへ進む
AlphaFoldが扱う問い
アミノ酸配列から、タンパク質の立体構造をどこまで予測できるか。
治療で確かめる問い
その物質が患者に有効か。副作用は許容できるか。どの対象で評価したか。
背景を読む:2024年ノーベル化学賞の二つの成果
賞の半分は、計算によるタンパク質設計のDavid Bakerに授与されました。残る半分は、構造予測のDemis HassabisとJohn Jumperへの授賞です。ノーベル賞の公式発表
「AIが受賞した」とまとめると、研究者の貢献と、設計・予測という異なる成果が見えにくくなります。
3. Co-Scientistは仮説を作り、体外の実験で確かめた
Co-Scientistは、複数のエージェントが仮説を生成し、批判、順位付け、修正を行う仕組みです。研究者が目的と制約を指定し、途中で方向を変えられます。Gottweisらの査読論文(2026年)
薬の新用途、肝線維症の標的、薬剤耐性の仕組みを検証対象にしました。急性骨髄性白血病では、薬の候補などを細胞実験で調べています。
- 仮説の順位:AI内部の評価です。
- in vitroの検証:体外の実験系で得た証拠です。
- 臨床の結果:患者の治療成績です。この研究の細胞実験とは異なります。
文章の提案から、測れる実験へ進んだ点が成果です。ただし、公開文献への依存により、購読制の論文や否定的な結果が抜ける可能性があります。仮説の材料も点検します。
自分の研究へ置き換える:公開されていない材料をどう扱うか
自分たちの未公表の観察や、失敗した方法も、問いを考える材料になります。それをどの範囲で扱い、どう確かめるかを研究者が決めます。
AI内部の順位が上がったことと、外部の実験で仮説が支えられたことは、別々の結果として記録します。
4. AlphaEvolveは、作ったプログラムを採点する
Google DeepMindが2025年に発表したAlphaEvolveは、数学や計算処理のアルゴリズムを探索するエージェントです。プログラムを生成し、実行して評価し、次の候補へ進みます。AlphaEvolveの研究報告(2025年)
| 工程 | 外から確かめること |
|---|---|
| 候補を作る | 実行できるプログラムか |
| 実行して採点する | 計算結果が合い、条件を満たすか。どれほど速いか |
| 次の候補を選ぶ | 評価のよかった候補から改善できるか |
一例は、複素数を要素に持つ4×4行列を、48回のスカラー乗算で掛け合わせる方法です。論文が扱う条件で、結果の一致と演算回数を確かめた成果です。
計算問題では採点できても、医療では、数字が何を表すかと、何を測るかを決める必要があります。候補の数と、問い・測定の質を分けて考えます。
応用と背景を読む:計算基盤の改善から、研究計画へ
開発元は、Googleの計算基盤の効率化や、行列計算への応用を報告しました。候補を採点できる仕組みが、反復を支えています。Google DeepMindの発表(2025年)
研究の準備にも、評価項目を先に決める考え方を応用できます。対象と比較があるか。仮説が外れたと認める観察を置いたか。この応用は、本講座の提案です。
5. 研修の問いに、比較・測定・反証を含める
架空の院内研修で、文章だけの資料と、図を加えた資料を比べます。関心は、翌週に内容を説明できるかです。同じ内容を扱うこと、事前知識の偏り、採点方法を先に考えます。
AIへ渡す前に、研究の問いを整える
比較するものを決める
同じ研修内容で、文章だけの資料と図を加えた資料を比べる
別の説明を置く
事前知識の偏りや、資料の情報量でも差が生じないか考える
測定と反証をそろえる
翌週に何を採点し、どんな結果なら仮説を支えないか書く
図が理解を助けたのか、説明の量が増えたのか、詳しい人が片方に集まったのか。AIには別の説明も出してもらい、比較条件をそろえ直します。
期待と違う結果も記録できる計画を下書きします。候補が増えたら元の問いに戻り、人が問いの価値と実行条件を判断します。
次は架空の院内研修です。実在の参加者や患者の情報ではありません。研究計画を実行せず、考え方の下書きだけ作ってください。外部検索は不要です。

【架空の設定】
同じ20分の研修について、文章だけの資料と、同じ内容に図を加えた資料を比べたい。翌週に内容を説明できるかが関心事。まだ参加者数、割付方法、事前の知識、採点方法は決まっていない。

次を簡潔に書いてください。
1. 比較できる問いを1文で書く。
2. 仮説と、結果の別の説明を各1つ書く。
3. 対象、比較方法、測る結果、仮説が支えられない結果を表にする。未決定の情報は未決定のまま残す。
4. 人が実行前に決める事項と、途中で中断する条件の案を書く。効果や必要人数の数値を作らない。
期待する問いは、「同じ内容の研修で、図の有無により翌週の説明の採点結果は違うか」です。事前知識と情報量は別の説明として扱い、人数と効果量は未決定のまま残します。
失敗例は、「図で理解度が50%上がるので、少人数でよい」です。その効果も必要人数も分かりません。比較と測定が対応し、反証と人の決定事項を残せば合格です。
次は、実験を動かす側へ
Co-Scientistの論文は、実験室の自動化との接続も将来の方向として述べています。仮説を考えるAIと、物を動かして測る装置がつながれば、循環が広がります。研究から治療まで無人で完了した、という成果ではありません。
セルフチェック
1. Co-Scientistが提案した候補を細胞の実験で検証した結果は、どう読みますか。
2. 研究の準備を進めるAIエージェントを評価するとき、適切なのはどれですか。
今日のまとめ
- AIエージェントは、計画、道具の実行、検証、修正をつなぐ構成です。
- 構造予測、仮説生成、細胞実験は進展していますが、患者への治療効果とは分けて読みます。
- 医師が渡す問いには、比較、測定、別の説明、仮説が外れる条件を含めます。
次は、「フィジカルAI」へ。画面の中の判断が、現実の動作とどうつながるかを確かめます。
参考・出典
出典の確認日:2026年10月10日。医学生物学の論文はPubMedで実在とDOIを照合しました。研究開発の成果と、臨床での有効性を区別しています。