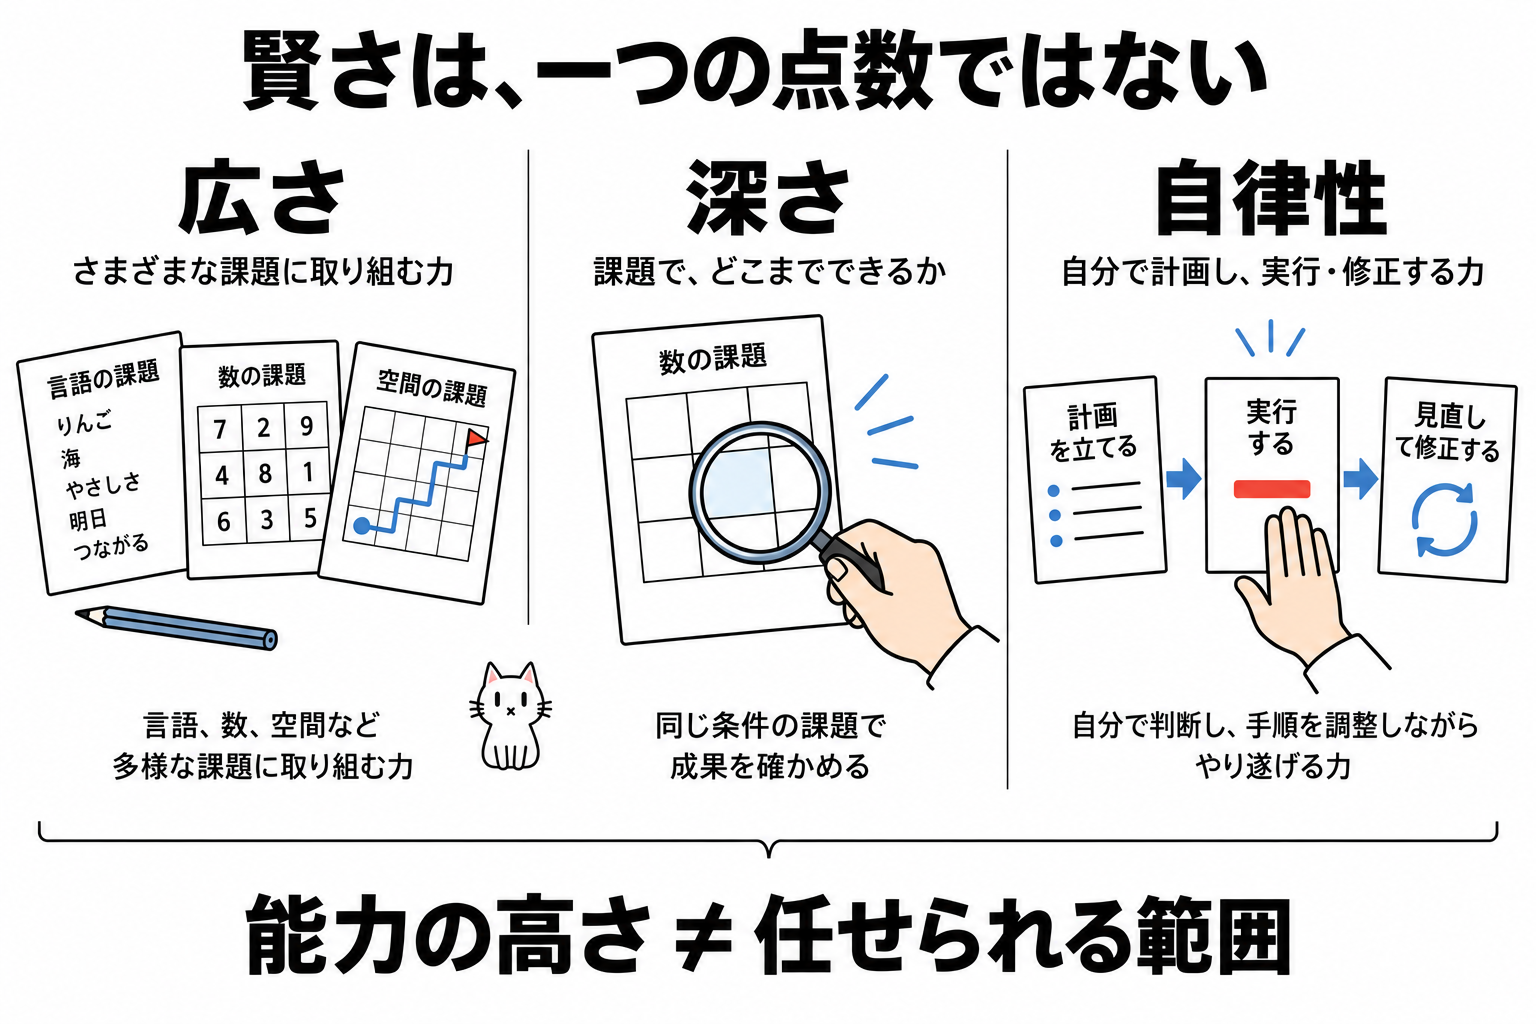
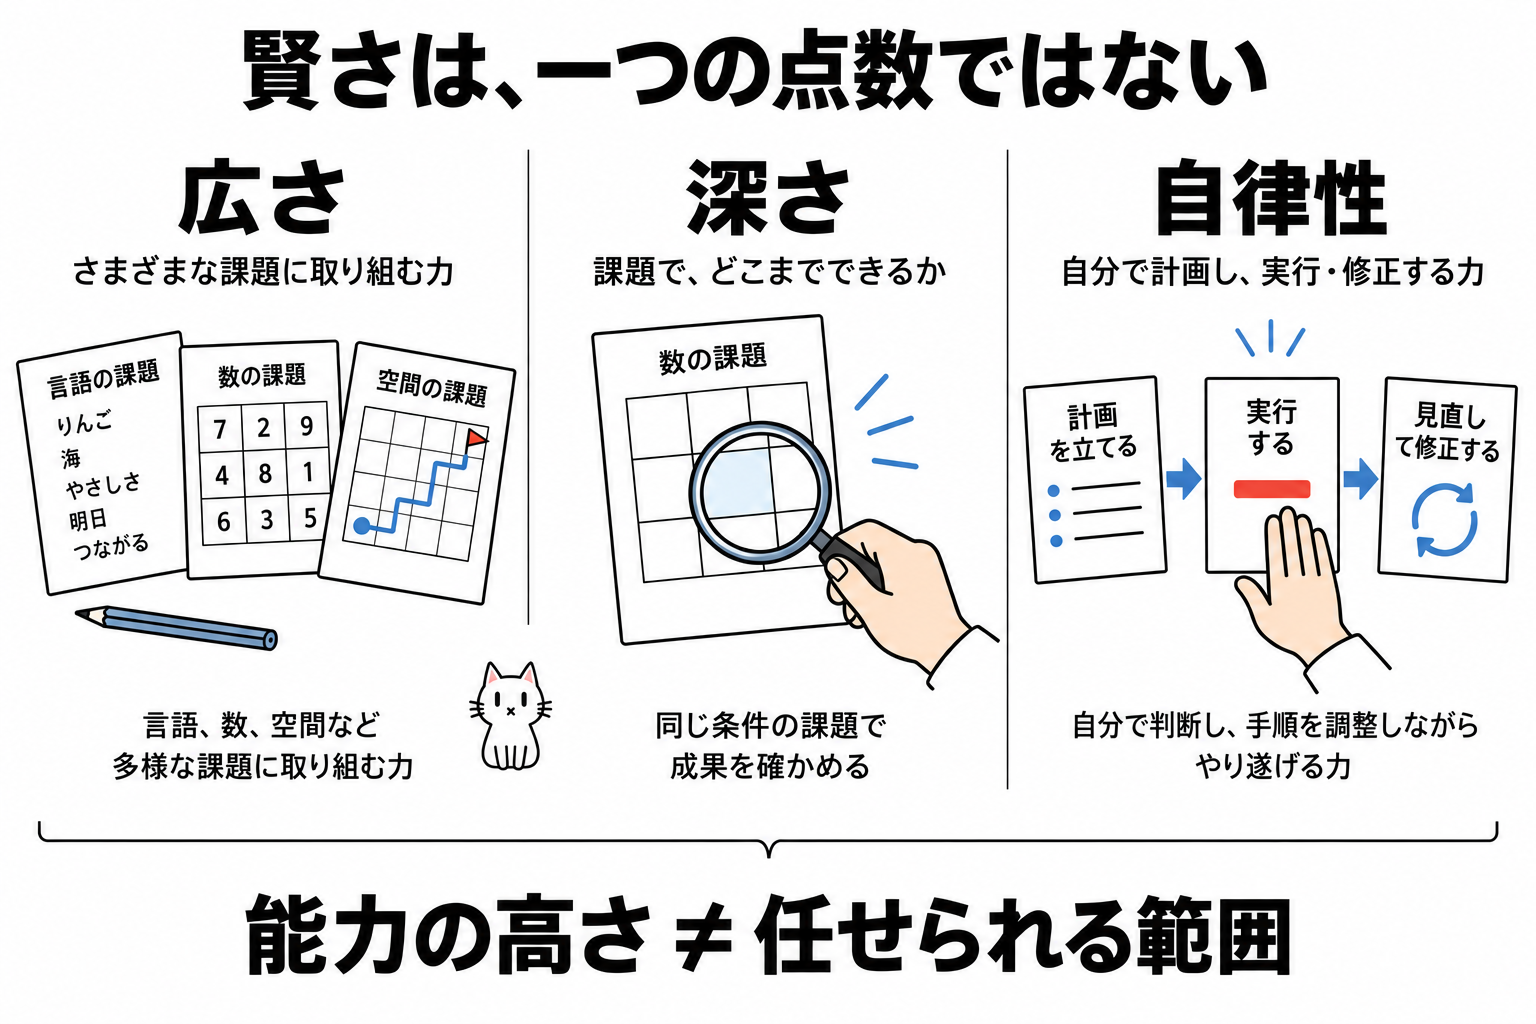
AGIは、能力の深さ、課題の広さ、自律性を分けて読むと具体的になります。高得点や実現年の予測だけでは、任せられる仕事は決まりません。
AGIは、Artificial General Intelligence、汎用人工知能の略です。幅広い課題を扱う知能を目指しますが、到達を認める共通の合格線はありません。
医学の問題、外国語の説明、プログラム作成。同じAIが違う仕事を行うとき、何がどの水準までできたかを見ていきます。
1. 深さ・広さ・自律性の3点で能力を見る
Morrisらは、能力の深さと課題の広さを分ける枠組みを提案しました。2024年のICMLで公表された論文です。Morrisらの枠組み
- 深さ:一つの課題で、どれほどよい成果を出すか。
- 広さ:異なる種類の課題にも対応できるか。
- 自律性:手順や道具を誰が選び、行き詰まったときに人へ戻せるか。
囲碁で人を上回っても、議事録の整理能力は別に調べます。多くの話題に答えても、各仕事を正確に仕上げるとは限りません。
抄読会にも、異なる作業があります。要約、研究デザインの説明、表の再計算、参加者向けの図作りは、同じ能力ではありません。
要約がよくても分母を取り違える。計算が合っても対象と読者の違いを見落とす。「医学に強い」より、できた作業を具体的に残す方が、次に任せる範囲を決められます。
医学に強いAIに、何を任せたいか
一つの課題の深さ
論文の要約が正しいか。対象、比較、結果を原文と照合する。
工程の広さと自律性
要約、数値の再計算、図作りを扱えるか。途中の手順と、人へ戻す地点も確かめる。
枠組みの範囲を確認する:能力の分類と、人との作業
Morrisらは、能力の分類と、人とAIがどう作業するかを分けて論じています。人が毎回指示する条件と、途中で道具を選ぶ条件は、同じ自律性ではありません。
論文のモデル配置は、執筆時点の例です。2026年の製品をそのまま格付けする表としては使いません。
2. AGI・意識・身体・医療での使用を分ける
AGIの話には、意識やロボットも登場します。想像する対象はつながりますが、評価する問いは異なります。
| 言葉 | この章で扱う問い |
|---|---|
| AGI | 異なる種類の課題を、どの水準まで扱えるか |
| ASI、超知能 | 人の能力を広い範囲で大きく上回る知能を想定しているか |
| 意識 | 主観的な経験があるか。それをどう調べるか |
| 身体を持つAI | 現実の物体や環境に働きかけられるか |
| 医療での使用 | その用途で評価され、必要な手続きを満たしているか |
Morrisらは、意識、感覚、身体をAGIの必須条件にしていません。一つの研究上の提案であり、意識や身体の議論が決着したという意味ではありません。Morrisら(2024年)
自然な会話だけでは、主観的経験の有無は判断できません。文章の難問と、落ちるコップをつかむ作業も別です。後者は距離、力、機体の動きに関わり、次々章のフィジカルAIで扱います。
AGIという呼び名は、医療機器の承認や施設の使用許可に代わりません。具体的な製品と用途で確認します。日本で使う章では、その確認先を整理します。
3. 高得点は、測った課題の成績として読む
2026年も、知能の測り方自体が研究されています。次の二つは、異なる能力を捉える方法です。
- Burnellら:学習、記憶、推論など10の認知領域から、得意・不得意を整理します。2026年5月の査読前報告で、AGI到達の認定ではありません。Burnellら(2026年)
- ARC-AGI:少数の例から、見慣れない課題の規則を読む評価です。2026年1月の技術報告は2025年の競技を整理します。医師の仕事全体の成績ではありません。Cholletら(2026年)
専門試験も、問題文と選択肢がそろう場面を測ります。情報の不足を見つけて集める仕事まで評価したかは、別に確認します。
点数の背景を読む:測っていない能力と評価条件
Burnellらの提案は、認知領域を個別に調べてプロフィールを作ります。知識問題は解けても新しい規則でつまずく、文章は書けても長い作業で目的を保てない、といった差を考える手がかりです。
ARCの技術報告では、課題ごとに候補を修正する手法の進展も整理されています。成績を読む際は、問題の種類、使えた資料、試行回数、人の介入を確かめます。
測った範囲と、まだ測っていない範囲が分かると、使う価値のある作業を選べます。
4. 実現年の予測に、予測者と前提を添える
Dario Amodeiは2024年10月、彼が想定する強力なAIは、早ければ2026年に来る可能性があると書きました。もっと長くかかる可能性も示した、本人の予測です。Amodeiのエッセイ(2024年)
2026年になったことが、想定した能力の実現を証明するわけではありません。予測年に、到達の定義と前提を添えて読みます。
到達年を見たときの3つの質問
誰の予測か
本人の見通しか、研究の評価結果かを確認する
何への到達か
想定する能力と、使われ方の定義を読む
どんな前提か
必要な条件と、もっと時間がかかる可能性を読む
準備に置き換える:変化が進む三つの速度を考える
医師のキャリアでは、一つの実現年に賭けるより、複数の速度で準備する方法を本講座は提案します。これは未来の予測ではありません。
- 文章や検索がさらに便利になる場合。
- 研究や事務のまとまった工程を任せられる場合。
- 身体を使う仕事にも変化が及ぶ場合。
各場合で、試せる課題を一つ書きます。大きな変化を待たず、公開論文の主張と数値を照合する練習から始められます。
5. AIの答えを、自分で説明できるか確かめる
AIを学習に使うなら、答えを受け取ったあとに理解を確かめます。次は手順の一例で、学習効果が保証されるという主張ではありません。
- 説明の深さを変えてもらい、自分の言葉で説明する。
- 抜けた前提を尋ね、似た概念を区別する問題を作る。
- 抄読会なら、自分とAIが書いた問いの対象・比較・結果を、原文で照合する。
「なぜこの分母か」「別の説明は残るか」まで、自分が説明できるか試します。必要な基礎知識を対話で補い、返事を照合する力につなげます。
まずは、架空の発表を能力の地図に分けてください。
次の文章は架空の発表です。実在するAIの性能ではありません。「深さ」「広さ」「自律性」の表を作り、それぞれ「分かること」「まだ測っていないこと」を1項目ずつ書いてください。AGI到達、意識、医療での使用可否を断定しないでください。外部検索は不要です。

【架空の発表】
開発チームは、用意した要約、翻訳、数学の計50問で90%正答と報告した。課題は1回の応答で終わる。道具を使う場合は人が毎回道具と手順を指定した。未知の種類の課題や、長期間の作業は評価していない。身体を使う作業、意識、医療での利用は調べていない。
期待する整理は、「深さは用意した50問の正答率」「広さは評価した3種類まで」「自律性は人の指示がある条件」です。未測定の範囲も、それぞれに残します。
失敗例は、「90%なので人より賢いAGIで、診療も任せられる」です。人との比較も診療の評価もありません。条件を残し、未知の課題や長い作業の成績を補わなければ合格です。
これは認定書ではなく、次に調べる能力を決めるメモです。
セルフチェック
1. ある専門試験でAIが高得点を取ったとき、AGIについて何が分かりますか。
2. AGIの実現時期を扱う記事を読む方法として適切なのはどれですか。
今日のまとめ
- AGIは、能力の深さ、課題の広さ、自律性に分けて読むと具体的になります。
- 専門試験の点数や到達年の予測だけで、汎用性や使用可能な範囲は決まりません。
- 学びでは、答えを受け取ったあとに、原文との照合と自分の説明を重ねます。
次は、「AIは、研究の途中にも入ってきた」へ。対話の先で、計画、道具、実験がどうつながるかを見ます。
参考・出典
出典の確認日:2026年10月10日。研究者の枠組み、評価報告、予測を区別して参照しています。