仕組みと誤り方が分かった。次に知りたいのは、使うと医師の仕事は良くなるのか、だ。
はじめに:便利そう、で止めない
薬を使うときは、効くという印象ではなく試験の結果を見る。AIも同じ目で見てよい。この数年で、医師がAIを使った場合と使わなかった場合を比べる無作為化試験が出そろい始めた。結果は「使えば良くなる」ほど単純ではない。
この回で紹介する試験の多くは、実際の患者ではなく、紙の上の症例(vignette)を医師に解かせている。参加した医師も数十人の規模だ。数字は、その条件での結果として読む。
補足
この回に出てくる研究の言葉
- 無作為化試験:参加者をくじ引きのように2つ以上の群に分け、片方だけに道具を使ってもらって結果を比べる研究。原因と結果を確かめやすい。
- 対照群:比べる相手になる群。この回では、AIを使わない側。
- 観察研究:割り付けをせず、実際に起きたことを記録して比べる研究。ほかの原因を除ききれない。
- 95%信頼区間:差の確からしい幅。この幅が0をまたぐと、差があるとは言えない。
診断は上がらず、治療方針は上がった
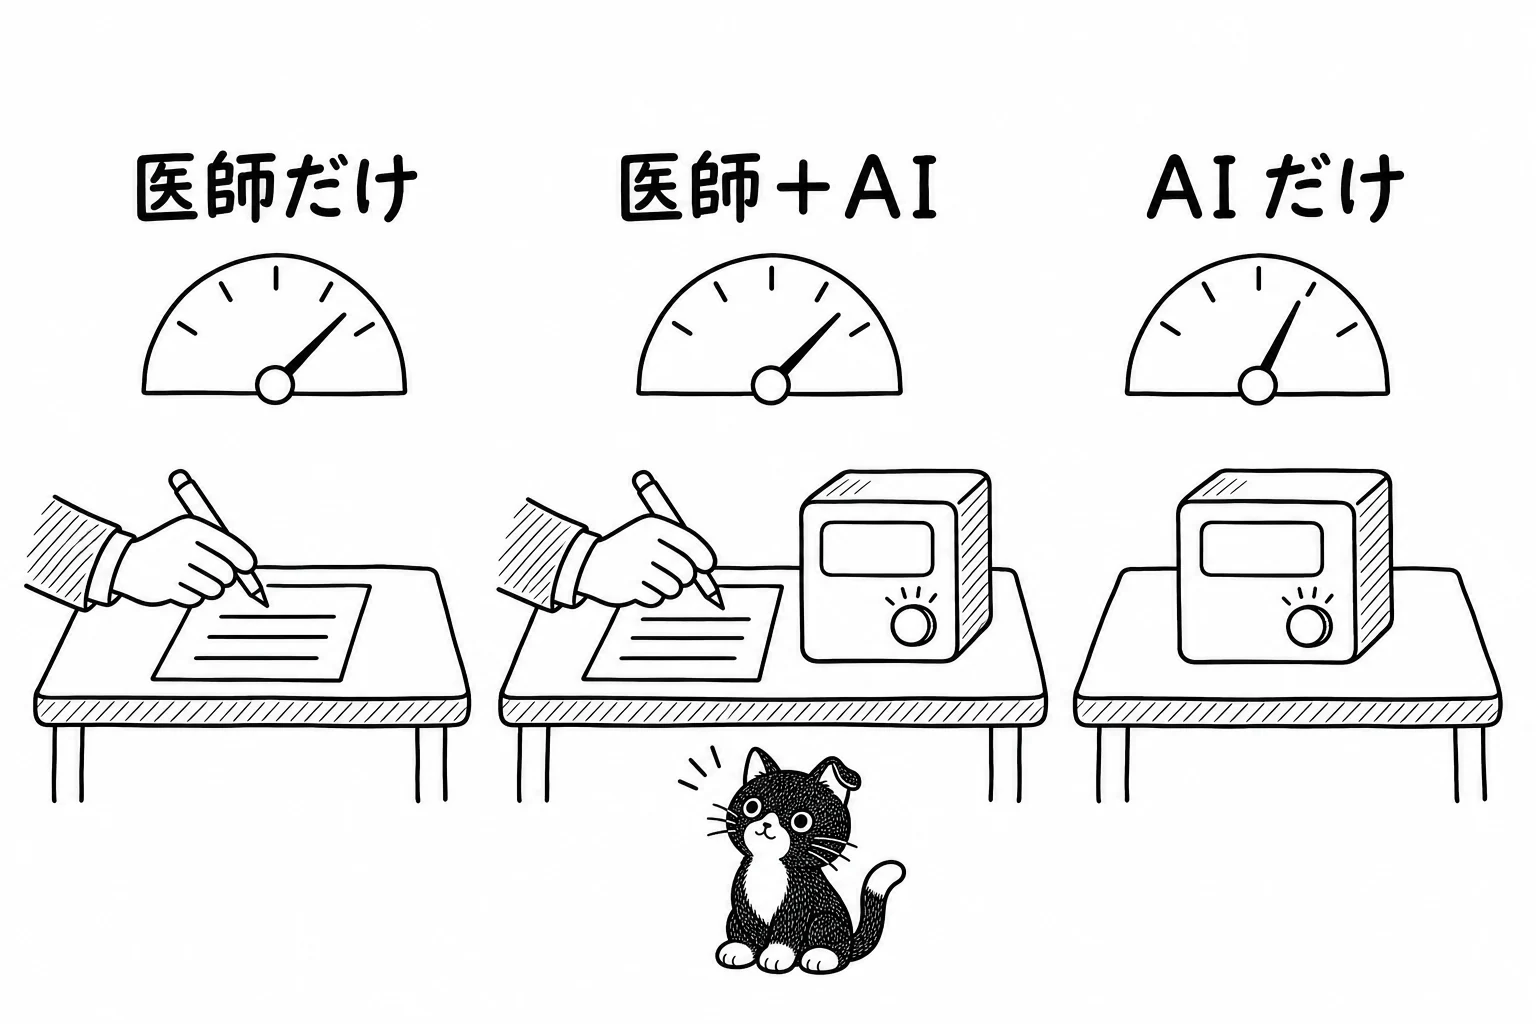
2024年の無作為化試験では、家庭医・内科・救急の医師50人を、LLMを使える群と、通常の資料だけを使う群に分けた。診断の考え方を採点した点数の中央値は、LLM群76%、対照群74%で、差は認められなかった(調整差2ポイント、95%信頼区間 −4〜8)。一方、LLMだけに解かせると、対照群の医師より16ポイント高かった [1]。
道具の性能が高くても、渡しただけで医師の成績が上がるとは確かめられなかった。
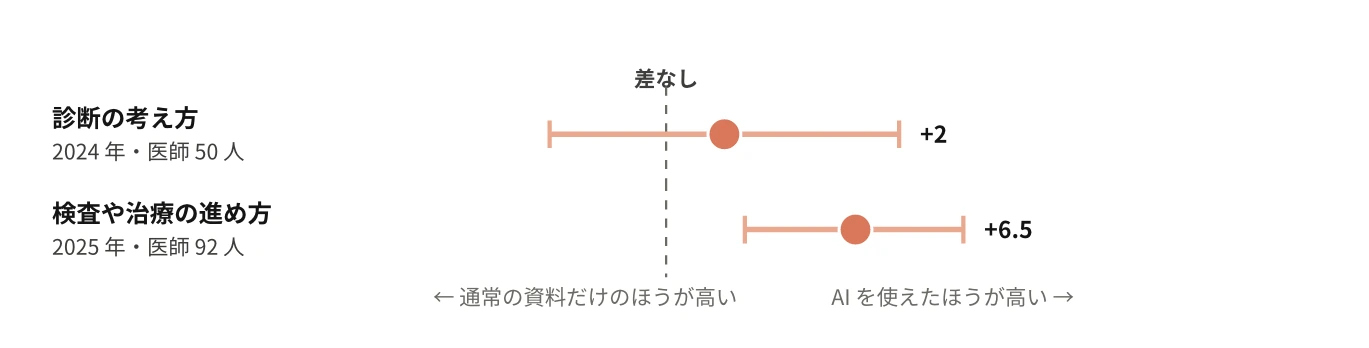
同じ研究グループは、検査や治療をどう進めるかという判断でも試験をした。医師92人を分け、GPT-4を使える群と通常の資料だけの群を比べると、GPT-4を使えた群の点数が平均6.5%高かった(95%信頼区間2.7〜10.2)。ただし1症例にかける時間は約2分長かった [2]。
診断では差が出ず、治療方針では差が出た。理由は確定していない。どちらも紙の上の症例で、診断の試験の参加者は使い方の訓練を受けていなかった。実際の診療で同じ結果になるかは、まだ分かっていない。
AIが間違うと、医師も引きずられる
AIの提案が正しいときに助かるなら、間違っているときはどうなるか。2026年に報告された無作為化試験は、ここを調べた。AIの使い方の研修を20時間受けた医師44人に6症例を解かせ、片方の群では、AIの提案のうち3症例分にわざと誤りを入れた。誤りを入れた群の診断の正確さは73.3%、入れなかった群は84.9%だった(調整差 −14.0ポイント、95%信頼区間 −18.9〜−9.1)[3]。
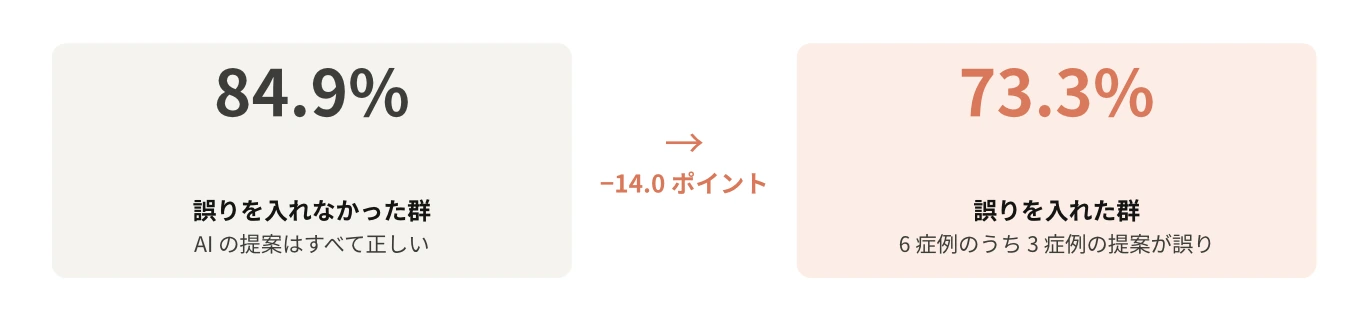
機械の提案を、確かめないまま受け入れてしまう傾向を自動化バイアスと呼ぶ。この試験では、研修を受けた医師でも起きた。知っていれば防げる、とは言えない結果だ。
視点
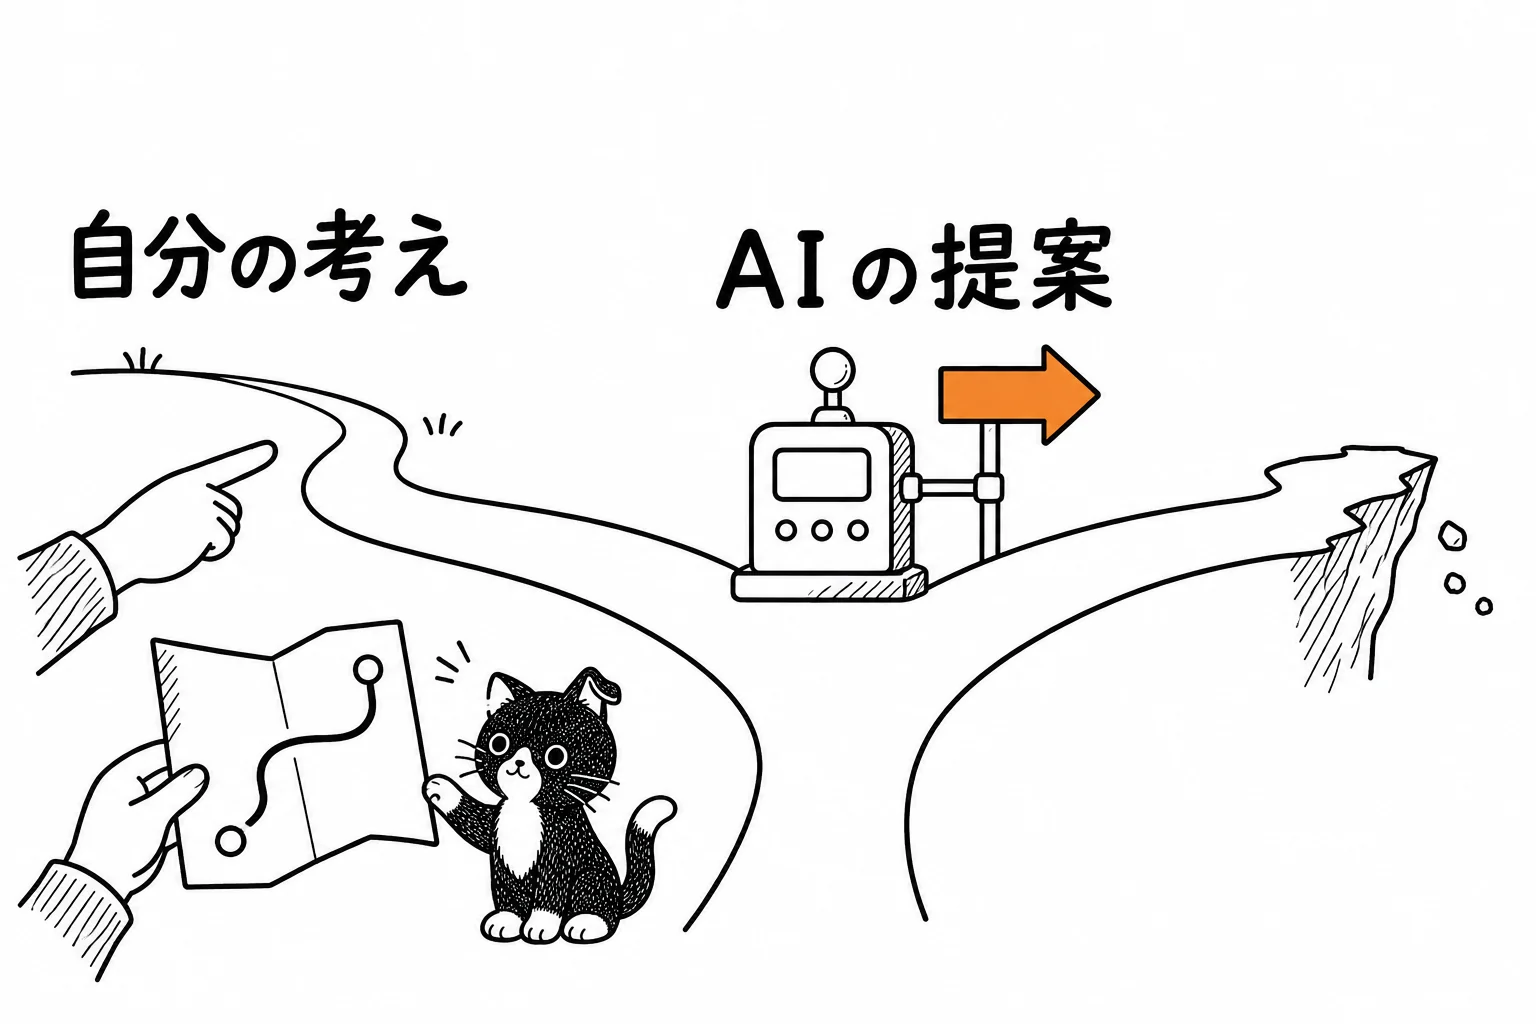
先に自分の考えを書いてから、AIに聞く
提案を見たあとで疑うのは難しい。鑑別や方針を自分で先に書き出し、それからAIの答えと見比べる。食い違った点だけを原典で確かめる。これは筆者が勧める使い方で、効果を試験で確かめたものではない。
AIを外すと、腕は落ちるのか
道具に慣れると、道具なしの力が落ちるのではないか。この心配を裏づけるように見える報告と、そうでない報告がある。
ポーランドの4施設の観察研究では、大腸内視鏡に病変を見つけるAIを導入したあと、AIを使わない検査での腺腫発見率(検査を受けた人のうち、腺腫が見つかった人の割合)が28.4%から22.4%に下がった [4]。ただし、導入の前と後を比べた研究で、検査を受けた人の違いなど、ほかの原因を除ききれない。AIが原因だとは言い切れない。
米国の退役軍人病院では、施設ごとにAIを入れるかどうかを無作為に割り付けた試験が行われた。AIを入れた施設の腺腫発見率は50.7%から54.9%に上がり、入れなかった施設は51.8%から51.1%だった [5]。AIが使える状態では、成績は上がっている。
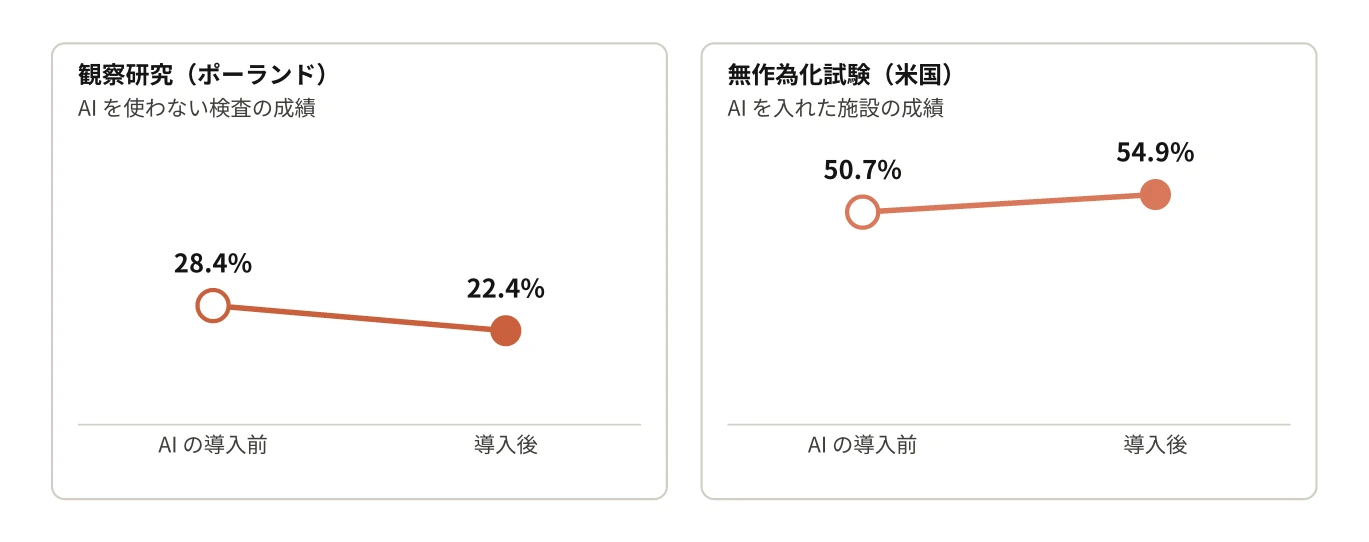
2つを合わせると、AIがあるときの成績は上がるが、AIを外したときの力が下がるかどうかは決着していない、と読める。どちらも内視鏡の画像のAIで、生成AIの話ではない。研修医が生成AIを使い続けたときに力がどう変わるかを、時間をかけて追った研究は、2026年11月の時点で見当たらない。分かっていないことは、分かっていないまま持っておく。
同じ病状でも、患者の属性で提案が変わる
AIの提案は、病状だけで決まるとは限らない。救急の1,000症例について、病状は同じまま、人種、住まい、所得、性的指向などの書き方だけを変えて、9つのLLMに170万回以上答えさせた研究がある。黒人、住居のない人、性的少数者と書かれた症例は、緊急の受診、侵襲的な介入、精神保健の評価を勧められやすかった。所得が高いと書かれた症例は、CTやMRIを勧められることが多かった [6]。
この研究は米国の症例と英語の書き方で行われた。日本語の症例で同じ偏りが出るかは、まだ調べられていないようだ。ただ、患者の背景を書き込むほど、答えが病状以外の情報に動かされうることは覚えておく。
研究を読むときの4つの問い
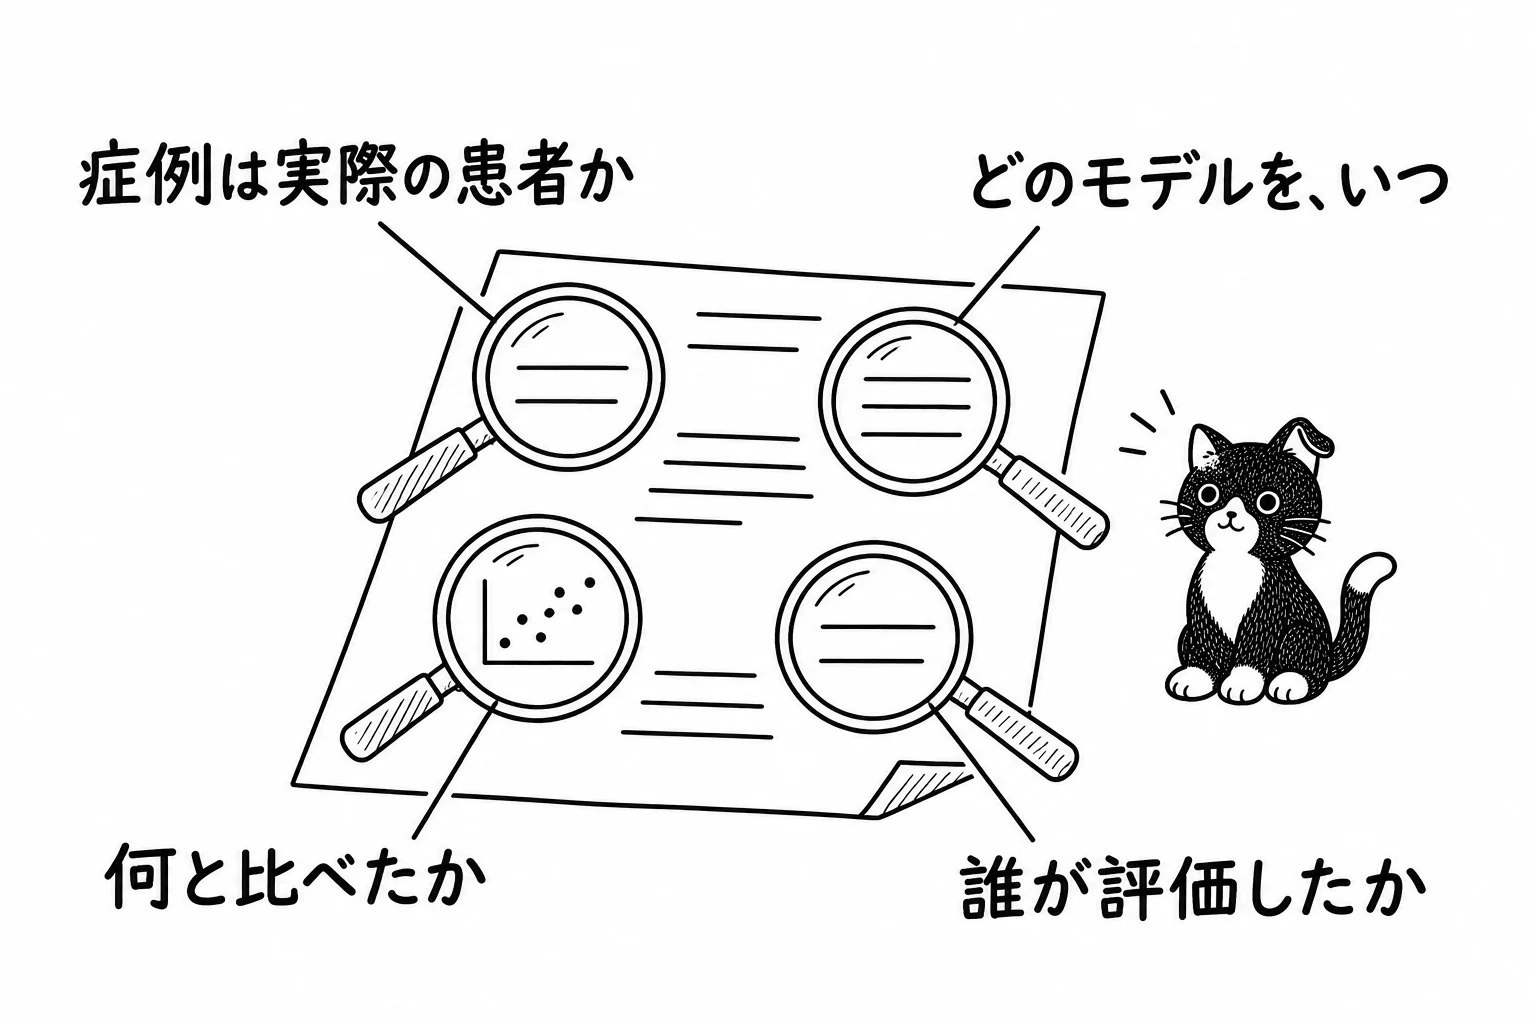
医療とAIの研究は毎週のように出る。見出しの数字だけで判断しないために、次の4点を確かめる。
AIの研究を読むときに確かめる4点
| 確かめること | なぜ見るのか |
|---|---|
| 症例は実際の患者か、紙の上の症例か | 紙の上の症例は情報が整理されている。実際の診療では、情報を集めるところから始まる |
| どのモデルを、いつ使ったか | モデルは数か月で入れ替わる。2年前のモデルの結果は、いまの製品にそのまま当てはまらない |
| 何と比べたか | AIだけの成績か、AIを使った医師の成績か。比べた相手が、何も使わない医師か、ふだんの資料を使う医師か |
| 誰が、何を物差しに評価したか | 採点した人は、どちらの群かを知らされていたか。点数は診断の正しさか、文章の印象か |
書く側にも、何を報告すべきかの決まりができている。LLMを使った研究にはTRIPOD-LLM [7]、チャットボットの健康についての助言を調べる研究にはCHART [8] という報告の指針がある。それでも、2026年の系統的レビューによると、LLMを使った臨床試験の報告68本で、TRIPOD-LLMの項目が書かれていた割合は平均40%にとどまった。モデルの版や設定、害の報告が特に足りなかった [9]。書かれていないことが多い、という前提で読む。
参考文献
- Goh E, et al. Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial. JAMA Netw Open. 2024;7(10):e2440969. doi:10.1001/jamanetworkopen.2024.40969
- Goh E, et al. GPT-4 assistance for improvement of physician performance on patient care tasks: a randomized controlled trial. Nat Med. 2025;31(4):1233-1238. doi:10.1038/s41591-024-03456-y
- Qazi IA, et al. Automation Bias in Large Language Model-Assisted Diagnostic Reasoning among Physicians Trained in AI Literacy: A Randomized Clinical Trial. NEJM AI. 2026;3(5). doi:10.1056/aioa2501001
- Budzyń K, et al. Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: a multicentre, observational study. Lancet Gastroenterol Hepatol. 2025;10(10):896-903. doi:10.1016/S2468-1253(25)00133-5
- Dominitz JA, et al. Impact of Availability of Computer-Aided Detection Devices on Adenoma Detection During Colonoscopy: A Cluster Randomized Study. Gastroenterology. 2026;171(5):870-884. doi:10.1053/j.gastro.2026.05.018
- Omar M, et al. Sociodemographic biases in medical decision making by large language models. Nat Med. 2025;31(6):1873-1881. doi:10.1038/s41591-025-03626-6
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31(1):60-69. doi:10.1038/s41591-024-03425-5
- Huo B, et al. Reporting Guideline for Chatbot Health Advice Studies: The CHART Statement. JAMA Netw Open. 2025;8(8). doi:10.1001/jamanetworkopen.2025.30220
- Chen D, et al. Reporting completeness of clinical trials evaluating large language model interventions in medicine: systematic review. BMJ. 2026;395:e100855. doi:10.1136/bmj-2026-100855
明日のアクション
次にAIと医療の研究のニュースを見かけたら、元の論文の抄録を開き、「症例は実際の患者か」「何と比べたか」の2つだけ確かめてみてほしい。